จำลองพลวัตของ Bose-Hubbard โดยเลือกการเข้ารหัสได้
คู่มือนี้สร้าง circuit สำหรับพลวัตเชิงเวลาของแบบจำลอง Bose-Hubbard หนึ่งมิติ ตั้งแต่การเขียนแฮมิลโทเนียนไปจนถึงการตรวจสอบความหนาแน่นของไซต์ที่วิวัฒน์แล้วกับค่าอ้างอิงที่แน่นอน สิ่งที่ทำให้แนวทางนี้น่าสนใจคือแนวคิดเดียว:
อย่าเลือกการเข้ารหัสโบซอนเป็น qubit ตอนสร้าง circuit ให้สร้าง circuit บนโหมดโบซอน แล้วปล่อยให้ transpiler ตัดสินว่าโหมดเหล่านั้นจะกลายเป็น qubit อย่างไร
สำหรับโบซอน คุณแทบทุกครั้งต้องเลื่อนการเข้ารหัสออกไป โหมดโบซอนรองรับอนุภาคได้มากเท่าใดก็ได้ ปริภูมิ Fock ของมันจึงมีมิติอนันต์ และไม่มีการเข้ารหัสใดจนกว่าคุณจะเลือกการตัดทอน ก่อน (จำนวนระดับการครอบครองที่คุณเก็บไว้) ในโค้ด การตัดทอนถูกกำหนดเป็นการครอบครองสูงสุดที่โหมดหนึ่งรองรับได้ คือ max_occupation ดังนั้นโหมดที่เก็บระดับ จึงมี max_occupation = 2 และ
นั่นทำให้การตัดทอนเป็น พารามิเตอร์ของการเข้ารหัส ไม่ใช่ของฟิสิกส์ และเป็นพารามิเตอร์ที่คุณอยากปรับเปลี่ยน คือเล็กเกินไปคำตอบก็ผิด ใหญ่เกินไป circuit ก็กว้างโดยไม่จำเป็น หากคุณเลื่อนการเข้ารหัสไปทำตอน transpile คุณก็กวาดค่าการตัดทอนได้โดยไม่ต้องเปลี่ยน circuit, แฮมิลโทเนียน หรือการจัดกลุ่ม
คู่มือ operatorsสำหรับโครงสร้างข้อมูลของ operator, คู่มือ mappersสำหรับการเข้ารหัสและวิธีเขียน mapper แบบกำหนดเอง และคู่มือ transpilationสำหรับขั้นตอนของ transpiler ที่อ้างถึงตลอดทั้งคู่มือ
การตัดทอนและต้นทุนของมัน
เมื่อคุณตัดทอนโหมดให้เหลือ ระดับ คุณจะทำลายคอมมิวเตเตอร์แบบแคนอนิกัลที่ระดับสูงสุดที่เก็บไว้ [1] ดังนั้นไม่มีการเข้ารหัสใดเป็นไอโซมอร์ฟิซึมของพีชคณิต การเข้ารหัสโบซอนแมปสถานะและ operator ที่กระทำภายในปริภูมิย่อยที่ถูกตัดทอน ผลที่ตามมาสองข้อสำคัญต่อทุกสิ่งต่อจากนี้:
-
ต้องเป็นขอบเขตของการครอบครองที่พลวัตไปถึงได้ ไม่ใช่เพียงของสถานะเริ่มต้น
-
การแมปไม่สับเปลี่ยนกับ normal ordering ดังนั้นให้ตัดสินใจครั้งเดียวว่าแฮมิลโทเนียนของคุณนิยามในรูปแบบ normal-ordered หรือไม่ และคงความสอดคล้องกันตลอด
คู่มือ mappersอนุพันธ์ความบกพร่องและแสดงผลที่ตามมาทั้งสองข้อบนโค้ดที่รันจริง
1. แฮมิลโทเนียน
แบบจำลอง Bose-Hubbard บนแลตทิซที่มีพันธะ คือ
โดยที่ อันตรกิริยานับคู่ของโบซอนบนไซต์หนึ่ง จึงต้องการให้ไซต์หนึ่งมีอนุภาคสองตัวพร้อมกัน เมื่อจัดเป็น normal-ordered จะได้ ซึ่งเป็นรูปแบบที่ใช้ในส่วนต่อไปนี้
เรขาคณิตเข้ามาเกี่ยวข้องผ่านรายการขอบเท่านั้น จึงไม่มีอะไรเฉพาะเจาะจงกับโซ่:
>>> from qiskit_bosons.operators import BosonOperator, ann, cre
>>>
>>> def bose_hubbard(edges, num_sites, tunneling, interaction):
...     """Build the normal-ordered Bose-Hubbard Hamiltonian on an arbitrary lattice."""
...     terms = {}
...     for i, j in edges:
...         terms[(cre(i), ann(j))] = -tunneling
...         terms[(cre(j), ann(i))] = -tunneling
...     for i in range(num_sites):
...         # U/2 * n_i (n_i - 1), already normal-ordered
...         terms[(cre(i), cre(i), ann(i), ann(i))] = 0.5 * interaction
...     return BosonOperator.from_dict(terms)
>>>
>>> num_sites = 4
>>> edges = [(i, i + 1) for i in range(num_sites - 1)]
>>> hamiltonian = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> print(f"Number of terms: {len(hamiltonian)}")
Number of terms: 10
มีสองสมบัติที่ควรตรวจสอบก่อน แฮมิลโทเนียนต้องเป็นเฮอร์มิเชียนเพื่อให้ เป็นยูนิทารี และมันอนุรักษ์จำนวนโบซอนทั้งหมด:
>>> hamiltonian.is_hermitian()
True
>>> hamiltonian.conserves_particle_number()
True
ตอนนี้ถึงคำถามเรื่องโบซอน: operator นี้ต้องการกี่ระดับ?
>>> hamiltonian.max_occupation()
2
พจน์อันตรกิริยาใช้ตัวสร้างสองตัวกับโหมดเดียว ดังนั้นโหมดต้องรองรับโบซอนสองตัวพจน์นี้จึงจะกระทำได้เลย นั่นคือการครอบครองสูงสุดเท่ากับ 2 ซึ่งเป็นตัวเลขที่ LevelSpec รับเป็น max_occupation โหมดที่เก็บการครอบครอง มี ระดับ ดังนั้น max_occupation >= 2 จึงเป็นข้อกำหนดเดียวกับ
นี่เป็นเพียงขอบเขตล่าง เพราะมาจากการใช้ operator หนึ่งครั้ง และการใช้ซ้ำตลอดการวิวัฒน์ตามเวลาอาจไปไกลกว่านั้น มันตัดค่าตัดขาดที่เล็กเกินไปอย่างแน่นอนออกไป และขั้นที่ 6 จะชี้ขาดว่าสำหรับแบบจำลองและสถานะนี้ ค่าตัดขาดต้องใหญ่เท่าใด mode_occupations() รายงานขอบเขตของแต่ละโหมดแยกกัน ซึ่งเป็นสิ่งที่ใช้เปรียบเทียบกับค่าตัดขาดรายโหมด
2. จัดกลุ่มก่อนแมป
การวิวัฒน์ถูกทำเป็น Trotter และวิธีแบ่งแฮมิลโทเนียนเป็นตัวกำหนดว่าการสังเคราะห์จะได้รับอะไร มีสองข้อพิจารณาที่ชี้ไปทางเดียวกัน
ข้อแรกเป็นเรื่องฟิสิกส์ พจน์การกระโดดเดี่ยว ไม่เป็นเฮอร์มิเชียน มีเพียงคู่ เท่านั้นที่เป็น หากคุณวิวัฒน์ภายใต้พจน์ที่ไม่เป็นเฮอร์มิเชียนเพียงพจน์เดียว การดำเนินการนั้นจะไม่เป็นยูนิทารี และ operator ที่แมปแล้วจะมีสัมประสิทธิ์เชิงซ้อนซึ่ง PauliEvolutionGate ปฏิเสธ ดังนั้นพจน์การกระโดดสองพจน์ของแต่ละพันธะต้องอยู่ด้วยกัน
ข้อที่สองเป็นเรื่องประสิทธิภาพ พจน์อันตรกิริยาบนไซต์ทั้งหมดเป็นเส้นทแยงมุมในฐานการครอบครองและสับเปลี่ยนกันเอง จึงอยู่กลุ่มเดียวกันและสังเคราะห์ร่วมกันได้ เช่นเดียวกับพันธะที่ไม่แตะไซต์ร่วมกัน บนโซ่ พันธะเว้นหนึ่งเป็นเซตแบบนั้น พันธะ 0 และ 2 กระทำบนคู่โหมดที่ไม่ซ้อนกัน พจน์การกระโดดของมันจึงสับเปลี่ยนกันและอยู่กลุ่มเดียวกันได้ ส่วนพันธะ 1 เป็นกลุ่มของตัวเอง ถ้าคุณจัดกลุ่มพันธะคู่และพันธะคี่ คุณจึงต้องการสามกลุ่ม ขณะที่หนึ่งกลุ่มต่อพันธะต้องการสี่กลุ่ม กลุ่มน้อยกว่าหมายถึงตัวประกอบน้อยกว่า และ circuit ตื้นกว่าด้วย โดยใช้ Gray code ที่ max_occupation = 2 ความลึกสอง qubit คือ 95 เทียบกับ 139 แลตทิซเป็นตัวตัดสินว่าพันธะใดอยู่กลุ่มเดียวกันได้ ซึ่งเป็นเหตุผลที่เลือกการแบ่งกลุ่มที่นี่
แอตทริบิวต์ groups นำการตัดสินใจนั้นเข้าสู่ circuit โดยเกต Evolution บน operator ที่จัดกลุ่มแล้วจะแยกย่อยเป็นการวิวัฒน์ย่อยหนึ่งรายการต่อกลุ่ม การแบ่งกลุ่มเลือกที่ระดับโบซอน ขณะที่โครงสร้างแลตทิซยังมองเห็นอยู่ และคงอยู่ครบถ้วนตลอดการแมป คู่มือการจัดกลุ่มครอบคลุมการตรวจสอบที่การจัดกลุ่มควรผ่าน
>>> def group_of(actions, edges):
...     """Assign each term to the even bonds, the odd bonds, or the on-site group."""
...     creations = sorted(mode for action, mode in actions if action)
...     annihilations = sorted(mode for action, mode in actions if not action)
...     if creations == annihilations:
...         return 2  # diagonal: the on-site interaction group
...     bond = tuple(sorted(set(creations) | set(annihilations)))
...     return edges.index(bond) % 2  # bonds 0 and 2 share a group, bond 1 has its own
>>>
>>> hamiltonian.groups = [group_of(actions, edges) for actions, _ in hamiltonian.iter_terms()]
>>> hamiltonian.num_groups()
3
ทุกกลุ่มต้องเป็นเฮอร์มิเชียนด้วยตัวเอง ซึ่งเป็นสิ่งที่การจับคู่ก่อนหน้าให้มา groups_are_hermitian() ตรวจสอบทุกกลุ่มในการเรียกครั้งเดียว:
>>> from qiskit_bosons.operators.terms import groups_are_hermitian
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
หากต้องการดูว่าแต่ละกลุ่มมีอะไร ให้แยกกลุ่มออกจากกัน:
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(f"group {index}: {len(group)} terms, hermitian={group.is_hermitian()}")
group 0: 4 terms, hermitian=True
group 1: 2 terms, hermitian=True
group 2: 4 terms, hermitian=True
การจัดกลุ่มคู่-คี่เป็นทางเลือกหนึ่ง และทางเลือกอื่นวัดได้ง่าย หากคุณให้ทุกพันธะมีกลุ่มของตัวเอง คุณต้องการสี่กลุ่ม และ circuit เดียวกันจะมีความลึกสอง qubit มากขึ้น ความลึกนับหลังจากลด circuit ด้วย Gray code ที่ max_occupation = 2 ซึ่งขั้นที่ 4 อธิบายไว้:
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution
>>> from qiskit_bosons.mappers import LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> def two_qubit_depth(operator):
...     """The two-qubit depth of one evolution under ``operator``, lowered with the Gray code."""
...     probe = BosonicCircuit(num_sites)
...     probe.append(Evolution(num_sites, operator, time=0.4), probe.modes)
...     pass_manager = generate_preset_occupation_pass_manager(LevelSpec(2, "gray"))
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(probe.decompose())
...     return lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
>>>
>>> per_bond = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> per_bond.groups = [
...     len(edges) if sorted(m for a, m in actions if a) == sorted(m for a, m in actions if not a)
...     else edges.index(tuple(sorted({m for _, m in actions})))
...     for actions, _ in per_bond.iter_terms()
... ]
>>> per_bond.num_groups(), two_qubit_depth(per_bond)
(4, 139)
>>> hamiltonian.num_groups(), two_qubit_depth(hamiltonian)
(3, 95)
3. circuit แบบโบซอน
สังเกตสิ่งที่ไม่มีใน circuit ไม่มีการตัดทอน ไม่มีการเข้ารหัส และไม่มีจำนวน qubit มันกระทำบนโหมดโบซอนสี่โหมด:
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution, InitializeModes
>>>
>>> total_time = 0.4
>>> occupation = [1, 1, 0, 0]  # one boson on each of the first two sites
>>>
>>> circuit = BosonicCircuit(num_sites)
>>> circuit.append(InitializeModes(occupation), circuit.modes)
>>> circuit.append(Evolution(num_sites, hamiltonian, time=total_time), circuit.modes)
>>> dict(circuit.count_ops())
{'InitializeModes': 1, 'Evolution': 1}

เส้นลวดคือโหมดโบซอน ไม่ใช่ qubit สังเกตว่า InitializeModes รับจำนวนเต็ม ไม่ใช่แฟลก เพราะโหมดหนึ่งรองรับโบซอนได้กี่ตัวก็ได้ สถานะ Fock จึงเป็นรายการของจำนวนการครอบครอง
การเรียก decompose() เพียงครั้งเดียวจะเปลี่ยนการจัดกลุ่มจากขั้นที่ 2ให้เป็นหนึ่งเกตต่อกลุ่ม:
>>> decomposed = circuit.decompose()
>>> dict(decomposed.count_ops())
{'Evolution': 3, 'InitializeModes': 1}
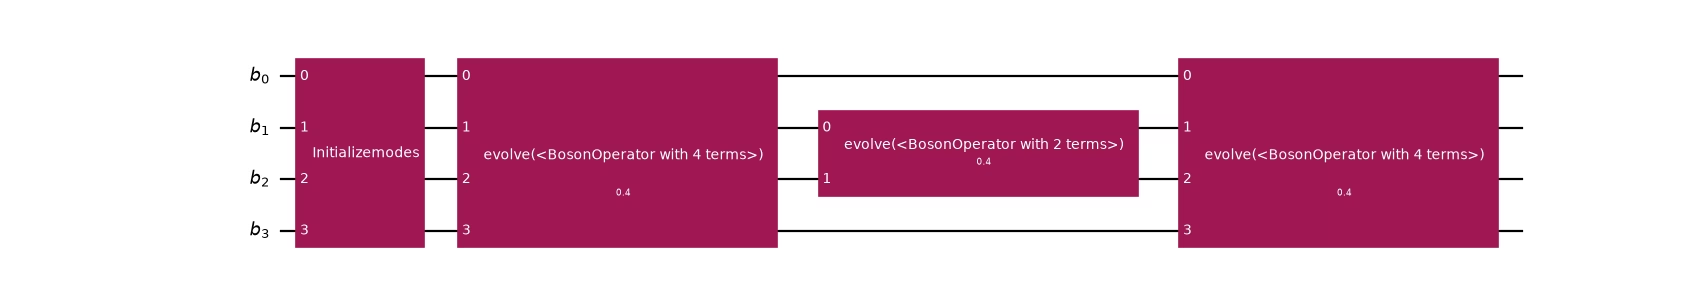
กลุ่มแรกมีพันธะบนโหมด 0 และ 1 และบนโหมด 2 และ 3 เกตของมันจึงครอบคลุมทั้งสี่โหมด กลุ่มบนไซต์ก็เช่นกัน พันธะกลางมีเกตของตัวเองบนโหมด 1 และ 2
หากข้ามการ decompose นั้น การจัดกลุ่มจะถูกเพิกเฉย วิธีที่ทำการแยกคือ synthesis ของเกต โดยมี BosonicLieTrotter เป็นค่าเริ่มต้น Synthesize an Evolution gate in bosonic space แสดงทางเลือกอื่น
4. เลือกการเข้ารหัสตอน transpile
นี่คือผลตอบแทน circuit เดียวกันถูกลดรูปสี่ครั้ง ภายใต้ค่า LevelEncoding สี่ค่าที่ต่างกัน โดยเปลี่ยนเพียงหนึ่งอาร์กิวเมนต์ LevelSpec จับคู่การเข้ารหัสกับการตัดทอนของทุกโหมด และ preset ต่อไปนี้อนุมานเลย์เอาต์ การเตรียมสถานะ และการแมป operator จากสเปกเดียวนั้น (ดูDescribe the truncation with a LevelSpec) สตริงอย่าง "gray" ใช้ได้ทุกที่ที่รับ LevelEncoding
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.mappers import LevelEncoding, LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> max_occupation = 2  # the largest occupation per mode, so d = max_occupation + 1 = 3 levels
>>>
>>> encodings = (
...     LevelEncoding.UNARY_PROJECTED,
...     LevelEncoding.UNARY_UNPROJECTED,
...     LevelEncoding.STANDARD_BINARY,
...     LevelEncoding.GRAY,
... )
>>> for encoding in encodings:
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     pass_manager.qubit = PassManager()  # keep the circuit as the pipeline synthesized it
...     qubit_circuit = pass_manager.run(decomposed)
...     basis = qubit_circuit.decompose(reps=6)
...     two_qubit = basis.depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"{encoding!s:18s} qubits={qubit_circuit.num_qubits:2d}  2q-depth={two_qubit:4d}")
unary_projected    qubits=12  2q-depth= 645
unary_unprojected  qubits=12  2q-depth= 383
standard_binary    qubits= 8  2q-depth= 218
gray               qubits= 8  2q-depth=  95
ตัวเลขเหล่านี้ขัดกับการเดาตามธรรมชาติ การเข้ารหัสแบบ unary ใช้ qubit ต่อโหมด เทียบกับ ของรหัสแบบกะทัดรัด และที่ รหัสแบบกะทัดรัดชนะทั้งสองด้านพร้อมกัน คือ qubit น้อยกว่าและเกตที่ทำ entangle น้อยกว่ามาก unary สองแบบต่างกันที่ operator ที่ส่งออก ไม่ใช่เลย์เอาต์ LevelEncoding.UNARY_PROJECTED มีตัวฉายบนทุก qubit ที่เว้นหนึ่งของโหมด ทำให้เป็นแบบที่วิวัฒน์แพงที่สุดในสี่แบบ ส่วน LevelEncoding.UNARY_UNPROJECTED ละตัวฉายออกและตรงกับแบบแรกบนปริภูมิย่อย one-hot คู่มือ mappersแสดง operator ทั้งสองเคียงกัน และอธิบายว่าทำไม Gray code จึงชนะ standard binary (SB) บนพจน์การกระโดด
Sawaya และคณะรายงานลำดับเดียวกัน [2]:
แม้รหัส unary มักต้องการ qubit มากกว่าแต่ใช้การดำเนินการน้อยกว่า แต่บ่อยครั้ง SB หรือ Gray code มีประสิทธิภาพกว่าทั้งในแง่จำนวน qubit และจำนวนการดำเนินการ
ข้อสรุปของพวกเขาคือรหัสที่ดีที่สุดขึ้นอยู่กับแฮมิลโทเนียนและ ซึ่งเป็นข้อโต้แย้งที่หนักแน่นที่สุดว่าไม่ควรตรึงตัวเลือกไว้ใน circuit
ภายใต้การเข้ารหัสระดับ หนึ่งโหมดครอบคลุมหลาย qubit ดังนั้นรีจิสเตอร์ qubit จึงกว้างกว่ารีจิสเตอร์โหมด preset ใช้ OccupationB2QLayout ซึ่งอนุมานความกว้างของรีจิสเตอร์จาก LevelSpec คู่มือ transpilationอธิบายขั้นตอนที่ preset รัน
5. ตรวจสอบกับพลวัตที่แน่นอน
ไม่มีขั้นตอนก่อนหน้าใดยืนยันได้ว่า circuit ถูกต้อง สำหรับเรื่องนั้น ให้เปรียบเทียบความหนาแน่นของไซต์ หลังการวิวัฒน์กับค่าอ้างอิงที่แน่นอนซึ่งคำนวณบนแฮมิลโทเนียนที่เข้ารหัสแล้ว
ค่าอ้างอิงต้องคำนวณในปริภูมิที่ถูกตัดทอนเดียวกับที่ circuit ทำงาน เพราะการเปรียบเทียบกับการคำนวณที่ไม่ตัดทอนจะปะปนความคลาดเคลื่อนของ Trotter กับความคลาดเคลื่อนจากการตัดทอน ซึ่งเป็นคนละเรื่องและควรแยกออกจากกัน (ดู Truncate the Fock space)
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp, Statevector
>>> from scipy.sparse.linalg import expm_multiply
>>> from qiskit_bosons.mappers.library import occupation_encoding
>>>
>>> def sparse_matrix(operator, encoding):
...     """Map a bosonic operator and hand back a sparse qubit matrix."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     observable = occupation_encoding(operator, spec)
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
>>>
>>> def fock_index(occupation, encoding):
...     """The computational basis index encoding a product Fock state."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     return sum(
...         encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets)
...     )
>>>
>>> def densities(state, encoding):
...     """The per-site boson number <n_m> of an encoded state vector."""
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         matrix = sparse_matrix(number, encoding)
...         out.append(float((state.conj() @ (matrix @ state)).real))
...     return out
เมื่อมีสิ่งเหล่านั้นแล้ว นี่คือการวิวัฒน์ที่แน่นอนในปริภูมิที่ถูกตัดทอน:
>>> encoding = LevelEncoding.GRAY
>>> num_qubits = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
>>>
>>> initial = np.zeros(2**num_qubits, dtype=complex)
>>> initial[fock_index(occupation, encoding)] = 1.0
>>>
>>> evolved_exact = expm_multiply(
...     -1j * total_time * sparse_matrix(hamiltonian, encoding), initial
... )
>>> reference = densities(evolved_exact, encoding)
>>> for site, value in enumerate(reference):
...     print(f"site {site}: {value:.6f}")
site 0: 0.993834
site 1: 0.858853
site 2: 0.141309
site 3: 0.006004
โบซอนแพร่จากปลายโซ่ที่มีอนุภาคไปยังปลายที่ว่าง และโบซอนสองตัวถูกอนุรักษ์:
>>> bool(np.isclose(sum(reference), 2.0))
True
ตอนนี้ circuit สังเกตว่าค่าอ้างอิงก่อนหน้าสร้างจาก initial โดยตรง ดังนั้น circuit ที่นำมาเทียบต้องมีเพียงการวิวัฒน์ เพราะเกต InitializeModes จะเตรียมสถานะที่เตรียมไว้แล้วซ้ำอีกครั้ง
>>> from qiskit_bosons.circuit.library.synthesis import BosonicLieTrotter
>>>
>>> def trotter_densities(steps, encoding):
...     """Site densities after `steps` first-order Trotter steps of the grouped evolution."""
...     circuit = BosonicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, hamiltonian, time=total_time, synthesis=BosonicLieTrotter(reps=steps)
...         ),
...         circuit.modes,
...     )
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     qubit_circuit = pass_manager.run(circuit.decompose())
...     # decompose BEFORE evolving: see the warning that follows
...     basis = qubit_circuit.decompose(reps=6)
...     state = np.asarray(Statevector(initial).evolve(basis).data)
...     return densities(state, encoding)
>>>
>>> for steps in (1, 2, 4, 8, 16):
...     error = max(
...         abs(a - b) for a, b in zip(trotter_densities(steps, encoding), reference)
...     )
...     print(f"steps={steps:2d}  max density error = {error:.4f}")
steps= 1  max density error = 0.0843
steps= 2  max density error = 0.0389
steps= 4  max density error = 0.0183
steps= 8  max density error = 0.0088
steps=16  max density error = 0.0043
ความคลาดเคลื่อนลดลงครึ่งหนึ่งเมื่อจำนวนขั้นเพิ่มเป็นสองเท่า ซึ่งเป็นลายเซ็น ของสูตรผลคูณอันดับหนึ่ง นั่นคือหลักฐานว่าความต่างคือความคลาดเคลื่อนของ Trotter และการเข้ารหัสถูกต้อง
การทำซ้ำมาจาก synthesis ของเกต ซึ่งทำ Trotter ในปริภูมิโบซอนที่การจัดกลุ่มยังคงอยู่ แต่ละขั้นใช้ทุกกลุ่มหนึ่งครั้ง และขั้นต่าง ๆ ตามกันไป ซึ่งต่างจากการส่ง LieTrotter ที่มี reps > 1 ให้ปลั๊กอินสังเคราะห์ระดับ qubit ที่นั่นแต่ละกลุ่มเป็น PauliEvolutionGate ของตัวเองอยู่แล้ว สูตรจึงแบ่งย่อยเฉพาะพจน์ภายในกลุ่ม และไม่เคยสลับกลุ่มเข้าด้วยกัน กลุ่มไม่สับเปลี่ยนกันเอง จึงเหลือขั้น Trotter ด้านนอกเพียงขั้นเดียวที่ความคลาดเคลื่อนไม่ลดลงไม่ว่า reps จะใหญ่เท่าใด Synthesize an Evolution gate in bosonic space เปรียบเทียบทั้งสองและครอบคลุมอันดับที่สูงกว่า
การเรียก decompose() ก่อนหน้าเป็นสิ่งจำเป็น evolve() ใช้นิยามที่แน่นอนของ PauliEvolutionGate และข้ามสูตรผลคูณไปทั้งหมด หากคุณตรวจสอบกับ circuit ที่ไม่ได้ decompose คุณจะเห็นความสอดคล้องเกือบสมบูรณ์แม้กับการสังเคราะห์ที่ผิดโดยตั้งใจ circuit ที่ไม่ได้ decompose ยังบังคับให้สร้าง operator หนาแน่นขนาด ในขณะที่ circuit ที่ decompose แล้วใช้เกตทีละตัว ซิมูเลเตอร์อื่นอาจจัดการเกตต่างออกไป ดังนั้นการตรวจสอบนี้ขึ้นกับซิมูเลเตอร์ ขณะที่ฮาร์ดแวร์ต้องใช้รูปแบบที่ decompose แล้วเสมอ
สุดท้ายคือการตรวจสอบหลัก ฟิสิกส์ต้องไม่ขึ้นกับการเข้ารหัสที่เลือก:
>>> def exact_densities(encoding):
...     """Exact truncated-space densities, computed under a given encoding."""
...     width = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
...     start = np.zeros(2**width, dtype=complex)
...     start[fock_index(occupation, encoding)] = 1.0
...     evolved = expm_multiply(
...         -1j * total_time * sparse_matrix(hamiltonian, encoding), start
...     )
...     return densities(evolved, encoding)
>>>
>>> all(
...     bool(np.allclose(exact_densities(name), reference, atol=1e-10))
...     for name in encodings
... )
True
จำนวน qubit โครงสร้าง Pauli และความลึกของ circuit ล้วนต่างกัน แต่ฟิสิกส์ตรงกันถึงทศนิยมสิบตำแหน่ง การเข้ารหัสเป็นทางเลือกด้านการใช้งาน ซึ่งเป็นเหตุผลที่มันเป็นของ transpiler unary สองแบบตรงกันที่นี่เพราะสถานะที่จำลองอยู่บนปริภูมิย่อย one-hot หากออกนอกนั้นทั้งสองจะต่างกัน
6. การตัดทอนเป็นพารามิเตอร์การลู่เข้า
ขั้นสุดท้ายเฉพาะกับโบซอน ทุกอย่างที่ผ่านมาตรึง max_occupation = 2 นั่นคือ แต่การตัดทอนไม่ใช่ตัวเลือกอิสระ มันคือพารามิเตอร์การลู่เข้า และคำตอบน่าเชื่อถือก็ต่อเมื่อมันหยุดเปลี่ยน (ดู Truncate the Fock space)
circuit ไม่มีการตัดทอน ดังนั้นตัว circuit เองไม่เปลี่ยนเมื่อค่าตัดขาดเปลี่ยน มีเพียงการ transpile ที่ทำซ้ำ สิ่งที่เปลี่ยนคือขนาดของผลลัพธ์ และการกวาดค่าจะถูกเท่านี้ได้ก็เพราะระบบเล็กมาก ค่าอ้างอิงต่อไปนี้เป็นการจำลองแบบคลาสสิกที่แน่นอนของพลวัตที่ถูกตัดทอน ซึ่งทำได้กับสี่ไซต์ และเพิ่มแบบเอกซ์โพเนนเชียลตามจำนวน qubit สำหรับปัญหาที่เกินขอบเขตนั้นจะไม่มีค่าอ้างอิงที่แน่นอนให้เปรียบเทียบ และต้องตัดสินการลู่เข้าด้วยวิธีอื่น
>>> def densities_at_cutoff(max_occ, encoding=LevelEncoding.GRAY):
...     """Exact truncated-space densities at a given cutoff."""
...     spec = LevelSpec(max_occ, encoding).resolve(num_sites)
...
...     start = np.zeros(2**spec.total_width, dtype=complex)
...     start[
...         sum(encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets))
...     ] = 1.0
...
...     def matrix(operator):
...         observable = occupation_encoding(operator, spec)
...         return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
...
...     evolved = expm_multiply(-1j * total_time * matrix(hamiltonian), start)
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         out.append(float((evolved.conj() @ (matrix(number) @ evolved)).real))
...     return out
>>>
>>> previous = None
>>> for max_occ in (1, 2, 3, 4):
...     current = densities_at_cutoff(max_occ)
...     # Report the drift bucketed rather than to full precision: after it reaches machine
...     # epsilon, the exact digits are arithmetic noise and vary between BLAS builds.
...     if previous is None:
...         drift = "--"
...     else:
...         gap = max(abs(a - b) for a, b in zip(current, previous))
...         drift = f"{gap:.0e}" if gap > 1e-12 else "< 1e-12"
...     print(f"d={max_occ + 1}  "
...           + " ".join(f"{x:.6f}" for x in current)
...           + f"   drift={drift}")
...     previous = current
d=2  0.993986 0.858173 0.141827 0.006014   drift=--
d=3  0.993834 0.858853 0.141309 0.006004   drift=7e-04
d=4  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
d=5  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
ที่ max_occupation = 1 () แต่ละไซต์มีโบซอนได้อย่างมากหนึ่งตัว พจน์อันตรกิริยาซึ่งต้องการสองตัวบนไซต์จึงกระทำไม่ได้เลย และความหนาแน่นคลาดเคลื่อนประมาณ เมื่อเพิ่มระดับที่สาม ผลลัพธ์จับอันตรกิริยาได้ และตั้งแต่ max_occupation = 3 เป็นต้นไปผลลัพธ์นิ่งถึงความแม่นยำของเครื่อง: ลู่เข้าแล้ว
เหตุผลที่มันหยุดที่ max_occupation = 2 คือจำนวนอนุภาค แฮมิลโทเนียนอนุรักษ์จำนวนโบซอน และสถานะนี้มีสองตัว ดังนั้นไม่มีไซต์ใดมีได้เกินสองตัว ไม่ว่าเวลาวิวัฒน์จะเท่าใดและอันตรกิริยาจะผลักหรือดึงก็ตาม หากคุณวิวัฒน์ถึง แทน หรือพลิกเครื่องหมายของ ความหนาแน่นที่ max_occupation = 2 ขึ้นไปจะไม่เปลี่ยนถึง
สิ่งที่ดันข้อกำหนดให้สูงขึ้นคือจำนวนโบซอน โบซอนสามตัวบนโซ่เดียวกันเปลี่ยนไปประมาณ ระหว่าง max_occupation = 2 กับ 3 หลังการวิวัฒน์สั้น ๆ เท่าเดิม และประมาณ หลัง นั่นเป็นข้อความเกี่ยวกับแบบจำลองนี้และปริมาณอนุรักษ์ และเป็นขอบเขตเฉพาะกับ operator ที่อนุรักษ์จำนวนอนุภาค ไม่ใช่กฎทั่วไป ดังนั้นต้องกวาดค่าตัดขาด ไม่ใช่เดา
การกวาดค่ามีราคาฝั่ง circuit ด้วย ซึ่งค่าอ้างอิงที่แน่นอนไม่แสดง circuit แบบโบซอนเดียวกัน ลดรูปด้วย Gray code ที่แต่ละค่าตัดขาด:
>>> for max_occ in (1, 2, 3, 4):
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occ, LevelEncoding.GRAY)
...     )
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(decomposed)
...     depth = lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"d={max_occ + 1}  qubits={lowered.num_qubits:2d}  2q-depth={depth:4d}")
d=2  qubits= 4  2q-depth=   8
d=3  qubits= 8  2q-depth=  95
d=4  qubits= 8  2q-depth= 217
d=5  qubits=12  2q-depth=1176
แต่ละระดับที่เพิ่มมีต้นทุนเป็นความลึก และจำนวน qubit กระโดดทุกครั้งที่ ผ่านเลขยกกำลังสอง เมื่อคุณหาการลู่เข้าใน คุณจึงแลกความแม่นยำกับขนาดของ circuit การกวาดค่าจึงเป็นมากกว่าการตรวจสอบเชิงตัวเลข
สังเกตด้วยว่า ที่เกือบถูกต้องเป็นเรื่องบังเอิญของ observable ความหนาแน่นของไซต์แทบไม่ขยับ ขณะที่สถานะเบื้องหลังผิดในเชิงคุณภาพ (ไม่มีองค์ประกอบที่ถูกครอบครองสองตัว) หาก observable หนึ่งลู่เข้า ก็ไม่ได้แสดงว่าอีกตัวลู่เข้าแล้ว
ข้อสรุปที่ควรจำ
-
การเข้ารหัสเป็นเรื่องของ Transpiler Circuit แบบโบซอนใน ขั้นตอนที่ 3 ไม่ได้กล่าวถึงการตัดทอน (truncation) การเข้ารหัส หรือจำนวน Qubit เลย แต่การเข้ารหัสทั้งสี่แบบแปลง Circuit นั้นเป็น Circuit สี่แบบที่ต่างกัน และทั้งหมดให้ฟิสิกส์เดียวกัน ไม่มีอะไรก่อนหน้า Transpiler ที่ต้องเปลี่ยน
-
สำหรับโบซอน นี่ไม่ใช่แค่ความสะดวก การตัดทอนเป็นพารามิเตอร์การลู่เข้าที่ต้องกวาดค่า และมันอยู่ภายในการเข้ารหัส Circuit ที่สร้างบนการเข้ารหัสแบบตายตัวจะต้องถูกสร้างใหม่สำหรับทุกค่าของ
-
จัดกลุ่มก่อนแมป และจัดกลุ่มเพื่อความเป็นเฮอร์มิเชียน เทอมการกระโดดเดี่ยวไม่เป็นเฮอร์มิเชียนและยกกำลังเอกซ์โปเนนเชียลไม่ได้ ส่วนคู่เทอมของพันธะบนมือเป็นเฮอร์มิเชียน จึงยกกำลังเอกซ์โปเนนเชียลได้ ให้ตัดสินใจการแบ่งกลุ่มที่ระดับโบซอน ซึ่งยังมองเห็นแลตทิซอยู่ นี่จำเป็นทางฟิสิกส์ และแอตทริบิวต์
groupsมีไว้เพื่อส่งต่อการตัดสินใจนั้น -
อย่าสมมติว่าการเข้ารหัสแบบน้ำหนักต่ำคือแบบที่ถูกที่สุด ที่ โค้ดแบบกะทัดรัดชนะทั้งสองแบบยูนารีทั้งในด้าน Qubit และ Gate พร้อมกัน และแบบโปรเจกต์มีต้นทุนสูงที่สุด ให้วัดผลดู เพราะจุดตัดขึ้นอยู่กับ
-
การตัดทอนทำลายพีชคณิต ในแบบที่วัดปริมาณได้ เฉพาะที่ระดับสูงสุดที่เก็บไว้ ด้วยขนาด และนี่ก็คือเหตุผลที่การแมปไม่สลับที่กับการเรียงลำดับแบบปกติ
ขั้นตอนถัดไป
มีสองทิศทางที่ต่อยอดตัวอย่างนี้ได้ ถ้าคุณแทนที่รายการขอบของโซ่ด้วยพันธะของแลตทิซสี่เหลี่ยม คุณไม่ต้องเปลี่ยนอย่างอื่นเลย เพราะฟังก์ชัน bose_hubbard ที่นิยามไว้ก่อนหน้านี้ไม่ขึ้นกับเรขาคณิตอยู่แล้ว การเข้ารหัสแบบกำหนดเองของคุณ (เช่นโค้ดแบบบล็อกยูนารีที่อยู่ระหว่างยูนารีกับแบบกะทัดรัด) ก็เสียบเข้ากับจุดต่อ MapperFnEvolutionSynthesis เดียวกับที่ค่าที่ตั้งไว้ล่วงหน้าใช้ได้เช่นกัน
-
หลักการออกแบบของการแทนตัวดำเนินการ อธิบายโครงสร้างข้อมูลของตัวดำเนินการที่อยู่เบื้องหลังแฮมิลโทเนียน
-
แมปการแทนตัวดำเนินการ ครอบคลุมการเข้ารหัสและการเขียน mapper ของคุณเอง
-
Transpile Circuit แบบโบซอน อธิบายขั้นตอนต่าง ๆ ที่ค่าที่ตั้งไว้ล่วงหน้าทำงาน
-
สังเคราะห์ Gate Evolution ในปริภูมิโบซอน แสดงวิธีลดค่าความคลาดเคลื่อน Trotter ในปริภูมิโบซอน
ความลึกทุกค่าที่รายงานอยู่บนรีจิสเตอร์นามธรรมที่เชื่อมต่อกันครบทุกคู่ การแมปไปยังการเชื่อมต่อของฮาร์ดแวร์จริงเป็นขั้นตอนแยกต่างหาก และบล็อก Qubit ต่อโหมดของการเข้ารหัสแบบจำนวนการครอบครองให้โครงสร้างแก่ router ที่ต่างจากแบบหนึ่ง Qubit ต่อหนึ่งโหมดพอสมควร
[1]
R. Somma, G. Ortiz, E. Knill, and J. Gubernatis, Quantum Simulations of Physics Problems (2003), arXiv:quant-ph/0304063, Sec. 4, Eq. 22.
[2]
N. P. D. Sawaya, T. Menke, T. H. Kyaw, S. Johri, A. Aspuru-Guzik, and G. G. Guerreschi, Resource-efficient digital quantum simulation of d-level systems for photonic, vibrational, and spin-s Hamiltonians, npj Quantum Information 6, 49 (2020), arXiv:1909.12847.