จำลองพลวัต Fermi-Hubbard 1 มิติด้วย flow set
ฟังก์ชันที่อธิบายในคู่มือนี้ใช้ได้เฉพาะใน Python API ในปัจจุบัน ฟังก์ชันการทำงานที่เทียบเท่ากันจะมีใน C API ในรุ่นอนาคต
คู่มือนี้สร้าง circuit สำหรับ พลวัตตามเวลาของโมเดล Fermi-Hubbard หนึ่งมิติ ตั้งแต่การเขียน Hamiltonian ไปจนถึงการตรวจสอบความหนาแน่นของไซต์ที่วิวัฒน์แล้ว สิ่งที่ทำให้เส้นทางนี้น่าสนใจคือแนวคิดเดียวจากเฟรมเวิร์ก flow set ของ Gandon et al. [1] ซึ่งเป็นงานที่เป็นแรงบันดาลใจให้เกิด TransferVertexOperator ในแพ็กเกจนี้ด้วย:
แทนที่จะจัดกลุ่มพจน์ของ Hamiltonian หลัง การแมป fermion-to-qubit ให้จัดกลุ่มมัน ก่อน การแมป เป็น flow set ซึ่งเป็นเซตย่อยหนึ่งมิติของกราฟอันตรกิริยาเฟอร์มิออนแบบมีทิศทาง ที่ transfer operator ของมันสลับที่กันได้ทั้งหมด
ทางเลือกนี้ขับเคลื่อนทุกอย่างด้านล่าง มันต้องการสิ่งต่อไปนี้:
-
การเข้ารหัส fermion-to-qubit แบบกำหนดเอง ที่ปรับให้เหมาะกับ flow set ซึ่งในที่นี้ใช้ ancilla qubit หนึ่งตัว เพื่อให้จำนวน qubit ที่เกี่ยวข้องกับการทำพจน์ Hamiltonian หนึ่ง ๆ ไม่เพิ่มขึ้นตามจำนวน mode ของเฟอร์มิออนอีกต่อไป (ต่างจากกรณีของ Jordan-Wigner (JW))
-
การสังเคราะห์แบบกำหนดเอง ที่ใช้ประโยชน์จากการสลับที่ได้ภายในแต่ละเซต ผลตอบแทนคือ circuit ที่มีความลึกสอง qubit คงที่เมื่อขนาดระบบเพิ่มขึ้น เทียบกับการเติบโตเชิงเส้นของการทำ Trotterization ทีละพจน์แบบ JW
กลไกที่นำการเข้ารหัสของคุณเองเข้าสู่ transpiler (CustomF2QLayout และ MapperFnEvolutionSynthesis) ใช้ได้กับทุกโมเดล
คู่มือ transpilation สำหรับสเตจของ transpiler ที่อ้างถึงตลอดคู่มือนี้ และคู่มือ mapper สำหรับสูตรทั่วไปในการเขียน mapper แบบกำหนดเอง
Transfer operator และ flow set
TransferVertexOperator สร้างจาก vertex operator และ transfer operator ในเทอมของ creation และ annihilation operator ของเฟอร์มิออน
ดังนั้น วัดการครอบครองของ mode (เป็น เมื่อว่าง และ เมื่อเต็ม) ขณะที่ ถ่ายโอนเฟอร์มิออนไปตามขอบ มีทิศทาง โปรดสังเกตว่าดัชนีสองตัวของ สลับกันไม่ได้ ดัชนีแรกเป็นตัวนำการรวมแบบลบ และดัชนีที่สองเป็นตัวนำแบบบวก ซึ่งทำให้ ต่างจาก และทำให้ขอบมีทิศทาง
ตัวดำเนินการเหล่านี้เป็นไปตามความสัมพันธ์การสลับที่แบบ ผสม transfer operator สองตัวที่ทำงานบนไซต์ที่ ไม่ซ้อนกัน สลับที่กันได้โดยปริยาย เพราะแต่ละตัวเป็นผลคูณ คู่ ของ operator เฟอร์มิออน กรณีที่น่าสนใจคือการใช้ไซต์ร่วมกัน ในกรณีนั้น ทั้งสองตัว สลับที่ได้ ถ้าลูกศร ไหล ผ่านไซต์นั้น (ตัวหนึ่งเข้า อีกตัวออก) และ สลับที่แบบตรงข้าม (anticommute) ถ้ามัน ชนกัน (เข้าทั้งคู่ หรือออกทั้งคู่)
กฎนี้เห็นภาพได้ง่ายที่สุดจากรูป การวาดจุดยอดเป็นโหนดและแต่ละ เป็นลูกศรจาก ไป จะได้กราฟอันตรกิริยา แบบมีทิศทาง ในที่นี้สำหรับสายโซ่สี่ไซต์ที่ใช้ตลอดคู่มือนี้ ซึ่งมีทั้งสองทิศทางของทุกพันธะ:

ลองไล่ตามกฎบนรูป ดู และ เป็นตัวอย่าง ลูกศรหนึ่ง เข้า ไซต์ 2 และอีกอัน ออก จากมัน เฟอร์มิออนจึงไหลผ่านตรง ๆ และตัวดำเนินการทั้งสองสลับที่กัน ทีนี้ลองดู และ ลูกศรทั้งสอง ชี้เข้า ไซต์ 2 พวกมันชนกัน และทั้งสองตัวสลับที่แบบตรงข้าม
นี่คือสิ่งที่ทำให้ flow set เป็นไปได้ เลือกเซตของลูกศรที่ก่อเป็นเส้นทางมีทิศทาง แล้วทุกคู่จะต่อกันแบบหัวต่อหางหรือไม่ต่อกันเลย ดังนั้นทั้งเซตจึงสลับที่กันได้ แม้แต่ละตัวจะซ้อนกันบนไซต์ร่วม การวิวัฒน์ภายใต้ flow set เดียวจึง ไม่มีความคลาดเคลื่อนแบบ Trotter และดังที่ ขั้นตอนที่ 7 แสดง ก็ทำได้ที่ความลึก circuit คงที่ด้วย
1. Hamiltonian ของ Fermi-Hubbard
โมเดล Fermi-Hubbard 1 มิติบน ไซต์ (ไม่มีสปิน ขอบเปิด) คือ
ตาม Eq. (9) ของ Ref. [1] พจน์การกระโดดคือ ส่วนอันตรกิริยาเป็นแนวทแยง จึงแสดงผ่าน vertex operator โดยใช้ :
ทั้งสองส่วนถูกสร้างโดยตรงเป็น TransferVertexOperator โปรดสังเกตว่า ถูกเก็บเป็นรายการแนวทแยง (j, j):
>>> from collections import defaultdict
>>> from qiskit_fermions.operators import TransferVertexOperator
>>>
>>> def fermi_hubbard_1d(num_sites, tunneling, interaction):
...     data: defaultdict[tuple[tuple[int, int], ...], complex] = defaultdict(complex)
...     for j in range(num_sites - 1):
...         k = j + 1
...         # hopping: -t (a^dag_j a_k + a^dag_k a_j) = t (T_jk + T_kj)
...         data[((j, k),)] += tunneling
...         data[((k, j),)] += tunneling
...         # interaction: U n_j n_k with n_j = (1 - V_j) / 2
...         data[()] += interaction / 4
...         data[((j, j),)] -= interaction / 4
...         data[((k, k),)] -= interaction / 4
...         data[((j, j), (k, k))] += interaction / 4
...     return TransferVertexOperator.from_dict(data)
>>>
>>> num_sites = 4
>>> hamiltonian = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
>>> print(format(hamiltonian))
  1.500000e0 +0.000000e0j * ()
-5.000000e-1 +0.000000e0j * (V(0))
 5.000000e-1 +0.000000e0j * (V(0) V(1))
  1.000000e0 +0.000000e0j * (T(0,1))
  1.000000e0 +0.000000e0j * (T(1,0))
 -1.000000e0 +0.000000e0j * (V(1))
 5.000000e-1 +0.000000e0j * (V(1) V(2))
  1.000000e0 +0.000000e0j * (T(1,2))
  1.000000e0 +0.000000e0j * (T(2,1))
 -1.000000e0 +0.000000e0j * (V(2))
 5.000000e-1 +0.000000e0j * (V(2) V(3))
  1.000000e0 +0.000000e0j * (T(2,3))
  1.000000e0 +0.000000e0j * (T(3,2))
-5.000000e-1 +0.000000e0j * (V(3))
ไซต์ภายในได้สัมประสิทธิ์ บน เพราะปรากฏในสองพันธะ ส่วนไซต์ขอบปรากฏในพันธะเดียว ทุกพจน์ที่แสดงที่นี่ปรากฏในกราฟที่วาดไว้ข้างต้น พจน์ T(j,k) คือลูกศรของมัน และพจน์ V(j) คือโหนดของมัน
2. แบ่งเป็น flow set
ถัดไป ติดป้ายแต่ละพจน์ด้วย flow set ที่มันอยู่ แอตทริบิวต์ groups มีไว้เพื่อจุดประสงค์นี้ gate Evolution บน operator ที่จัดกลุ่มแล้วจะแยกเป็น Evolution หนึ่งตัวต่อกลุ่ม (ขั้นตอนที่ 6 นำสิ่งนี้ไปใช้) ดังนั้นการจัดกลุ่มที่ตัดสินใจไว้ที่นี่ในระดับ เฟอร์มิออน จึงคงอยู่ต่อไปใน circuit
สำหรับสายโซ่ 1 มิติ flow set การกระโดดสองชุดคือลูกศรทิศตะวันออก () และลูกศรทิศตะวันตก () พจน์อันตรกิริยาแนวทแยงสลับที่กับทุกอย่างที่เป็นแนวทแยงและก่อเป็นกลุ่มที่สาม:
>>> def flow_set_groups(operator):
...     groups = []
...     for terms, _ in operator.iter_terms():
...         match terms:
...             case [(left, right)] if right == left + 1:
...                 groups.append(0)  # east-oriented: T_{j,j+1}
...             case [(left, right)] if right == left - 1:
...                 groups.append(1)  # west-oriented: T_{j+1,j}
...             case _:
...                 groups.append(2)  # diagonal interaction terms
...     return groups
>>>
>>> hamiltonian.groups = flow_set_groups(hamiltonian)
>>> hamiltonian.num_groups()
3
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(index, sorted(terms for terms, _ in group.iter_terms()))
0 [[(0, 1)], [(1, 2)], [(2, 3)]]
1 [[(1, 0)], [(2, 1)], [(3, 2)]]
2 [[], [(0, 0)], [(0, 0), (1, 1)], [(1, 1)], [(1, 1), (2, 2)], [(2, 2)], [(2, 2), (3, 3)], [(3, 3)]]
กลุ่ม 0 และ 1 คือ flow set ทั้งสอง แต่ละเซตเป็นเส้นทางมีทิศทางตามสายโซ่ ดังนั้นตามคุณสมบัติ flow ทุกพจน์ภายในกลุ่มจึงสลับที่กัน
แต่ละกลุ่มยังต้องเป็น Hermitian ด้วยตัวเอง เพราะ product formula ยกกำลังเอ็กซ์โพเนนเชียลของแต่ละกลุ่มแยกกัน และมีเพียงตัวประกอบที่เป็น Hermitian เท่านั้นที่การวิวัฒน์เป็นยูนิทารี groups_are_hermitian() ยืนยันเรื่องนี้:
>>> from qiskit_fermions.operators.terms.grouping import groups_are_hermitian
>>>
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
ควรหยุดคิดตรงนี้ เพราะกลุ่มการกระโดดสองกลุ่มเป็นแบบ ทิศทางเดียว: กลุ่ม 0 มีเฉพาะพจน์ทิศตะวันออก และกลุ่ม 1 เฉพาะทิศตะวันตก การแยก Hamiltonian แบบนั้นปกติจะทำลายความเป็น Hermitian เพราะ ต้องมีคู่ conjugate อยู่ด้วย TransferVertexOperator หลีกเลี่ยงปัญหานี้ได้เพราะ เป็น Hermitian อยู่แล้ว ด้วยตัวเอง มันเป็นผลคูณของ Majorana operator สองตัว (ดูนิยามในขั้นตอนที่ 1) ไม่ใช่ เปล่า ๆ ภาพ Jordan-Wigner ของมันจึงมีสัมประสิทธิ์จริงแทนที่จะเป็นจินตภาพ การเลือกการแสดง operator นี้จึงเป็นสิ่งที่ทำให้ flow set ทิศทางเดียวเป็นตัวประกอบ Trotter ที่ถูกต้อง
ป้ายกำกับตะวันออก/ตะวันตกที่ใช้ตลอดคู่มือนี้เป็น เชิงเรขาคณิต โดยวาดสายโซ่จากซ้ายไปขวาและดัชนี mode เพิ่มขึ้นในทิศทางนั้น ชี้ไปทางตะวันออก และ ชี้ไปทางตะวันตก Ref. [1] ไม่สอดคล้องกันเองในการตั้งชื่อนี้ (เนื้อความและรูปไม่ตรงกัน) ดังนั้นคู่มือนี้จึงตั้งใจ ไม่ ตามเนื้อความ และใช้ป้ายกำกับจากรูปแทน เมื่ออ่านเทียบกับบทความ ให้จับคู่ flow set ด้วยน้ำหนัก Pauli ของมัน (1 และ 3 ด้านล่าง) ไม่ใช่ด้วยคำบอกทิศ
3. เขียนการเข้ารหัสแบบกำหนดเอง
ส่วน IV B ของ Ref. [1] จำแนกรูปแบบที่การเข้ารหัส fermion-to-qubit แบบเฉพาะที่เป็นไปได้เมื่อจำกัดอยู่บน flow set Jordan-Wigner ธรรมดาใช้ qubit และแมปทุกพจน์การกระโดดเป็น Pauli น้ำหนัก 2 การจำแนกนี้แสดงว่า การใช้ qubit เพิ่มแลกมาซึ่งโครงสร้าง ใน operator ที่เข้ารหัส
การเข้ารหัสที่ทำที่นี่คือโครงสร้างแบบ parity-delocalized ของ Appendix B 2 (สมการ B4 และ B5) ซึ่งใช้ ancilla qubit หนึ่งตัว ดังนั้น พาริตีของเฟอร์มิออนถูกกระจายไปบนคู่ของ qubit:
ดัชนี ในนิพจน์สุดท้ายบังคับให้ต้องมี qubit เพิ่ม พันธะสุดท้ายของสายโซ่มี ดังนั้น ของมันตกที่ qubit ซึ่งเกิน mode เฟอร์มิออนตัวสุดท้าย ไปหนึ่ง qubit ท้ายสุดนั้นคือ ancilla และเป็นเหตุผลที่ แทนที่จะเป็น ระยะเอื้อมเดียวกันนี้ปรากฏใน ซึ่ง ของมันอยู่บน ancilla เมื่อ
ผลตอบแทนเห็นได้ทันที: flow set ทั้งชุดถูกแมปเป็นผลรวมของ Pauli น้ำหนัก 1
ตัวคูณ ถูกกำหนดโดยการทำให้เป็นบรรทัดฐาน และเครื่องหมายลบสัมพัทธ์ระหว่างสองทิศทางถูกกำหนดโดยอัตลักษณ์ผลคูณ ซึ่ง Pauli ข้างต้นเป็นไปตาม หากผิดอย่างใดอย่างหนึ่ง จะได้ operator ที่เป็นไปตามความสัมพันธ์การสลับที่ แต่ไม่ได้แทน Hamiltonian เดิมอีกต่อไป คุณจึงควรตรวจสอบการเข้ารหัสเชิงตัวเลข ดังที่แสดงในขั้นตอนที่ 4
การเขียนการเข้ารหัสหมายถึงการเขียนฟังก์ชันที่แมป generalized transfer operator ตัวเดียวเป็น Pauli string โดย map_transfer_vertex_generators() จัดการการวนซ้ำบนพจน์และการประกอบเข้าด้วยกัน:
>>> from qiskit.quantum_info import SparseObservable
>>> from qiskit_fermions.mappers import map_transfer_vertex_generators
>>>
>>> def flow_set_action(action, num_qubits):
...     match action:
...         case (j, k) if j == k:
...             # vertex operator: V_j = Z_j Z_{j+1}
...             return SparseObservable.from_sparse_list(
...                 [("ZZ", [j, j + 1], 1.0)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j + 1:
...             # east-oriented transfer operator: weight 1
...             return SparseObservable.from_sparse_list(
...                 [("X", [k], -0.5)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j - 1:
...             # west-oriented transfer operator: weight 3
...             return SparseObservable.from_sparse_list(
...                 [("ZXZ", [k, k + 1, k + 2], 0.5)], num_qubits=num_qubits
...             )
...         case _:
...             raise ValueError(f"not a nearest-neighbor transfer operator: {action}")
>>>
>>> def flow_set_encoding(operator, num_qubits):
...     return map_transfer_vertex_generators(
...         operator,
...         lambda action: flow_set_action(action, num_qubits),
...         identity=lambda: SparseObservable.identity(num_qubits),
...         compose=SparseObservable.compose,
...     ).simplify()
MapperFnEvolutionSynthesis.mapper_fn คาดหวัง signature (operator, num_qubits) และชนิดที่คืนต้องเป็น SparseObservable ซึ่งทำให้ฟังก์ชันนั้นใช้เป็นปลั๊กอิน transpiler ได้โดยตรง ดูขั้นตอนที่ 6
การใช้มันกับ Hamiltonian จากขั้นตอนที่ 1 ให้ operator ที่เข้ารหัสบน qubit:
>>> num_qubits = num_sites + 1
>>> encoded = flow_set_encoding(hamiltonian, num_qubits)
>>> for label, indices, coeff in sorted(encoded.to_sparse_list()):
...     print(f"{label:3s} {str(indices):12s} {coeff.real:+.2f}")
    []           +1.50
X   [1]          -0.50
X   [2]          -0.50
X   [3]          -0.50
ZXZ [0, 1, 2]    +0.50
ZXZ [1, 2, 3]    +0.50
ZXZ [2, 3, 4]    +0.50
ZZ  [0, 1]       -0.50
ZZ  [0, 2]       +0.50
ZZ  [1, 2]       -1.00
ZZ  [1, 3]       +0.50
ZZ  [2, 3]       -1.00
ZZ  [2, 4]       +0.50
ZZ  [3, 4]       -0.50
มี 14 พจน์ในสามรูปแบบ: การกระโดดกลายเป็น X และ ZXZ อันตรกิริยาเป็น ZZ และ [] ตัวแรกคือเอกลักษณ์ ซึ่งให้เพียงเฟสรวม โปรดสังเกตว่าพจน์ ZZ ครอบคลุมทั้งเพื่อนบ้านใกล้ที่สุด และ ใกล้เป็นอันดับสอง ครอบคลุม qubit ถึง ซึ่งเป็นต้นทุนของการกระจายพาริตี
การจัดกลุ่มตาม flow set เผยให้เห็นความไม่สมมาตรที่โครงสร้างนี้แลกมา ลองแสดงน้ำหนัก Pauli ที่มีในแต่ละกลุ่ม:
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     weights = {len(indices) for _, indices, _ in flow_set_encoding(group, num_qubits).to_sparse_list()}
...     print(index, sorted(weights))
0 [1]
1 [3]
2 [0, 2]
flow set ทิศตะวันออก (กลุ่ม 0) ประกอบด้วย Pauli น้ำหนัก 1 ทั้งหมด การวิวัฒน์ตามเวลาของมันจึงเป็นชั้นของการหมุน qubit เดี่ยว และ ไม่ต้องใช้ entangling gate ขณะที่ใน Jordan-Wigner ทุกพจน์การกระโดดมีน้ำหนัก 2 และต้องใช้ นี่คือการแลกเปลี่ยนระหว่างปริภูมิกับเวลาของ Ref. [1] ในรูปแบบที่ง่ายที่สุด: qubit เพิ่มหนึ่งตัวเปลี่ยนครึ่งหนึ่งของ Hamiltonian การกระโดดให้เป็นการหมุน qubit เดี่ยว
flow set ทิศตะวันตก (กลุ่ม 1) จ่ายด้วยน้ำหนักสาม และอันตรกิริยา (กลุ่ม 2) อยู่ที่น้ำหนักสอง โดยรายการน้ำหนักศูนย์คือเอกลักษณ์ ทั้งหมดนี้ยังไม่ใช่ข้อกล่าวอ้างเกี่ยวกับ circuit สิ่งที่การสังเคราะห์ทำกับน้ำหนักเหล่านี้เป็นหัวข้อของขั้นตอนที่ 6 และ 7
4. ตรวจสอบการเข้ารหัส
การเข้ารหัสแบบกำหนดเองจะมีประโยชน์ก็ต่อเมื่อมัน ซื่อตรง และควรตรวจสอบอันที่เขียนด้วยมือ เนื่องจากการเข้ารหัสนี้ใช้ qubit ปริภูมิฮิลเบิร์ตของ qubit จึงใหญ่เป็นสองเท่าของปริภูมิเฟอร์มิออน Hamiltonian ที่เข้ารหัสจึงไม่สามารถเท่ากับของ Jordan-Wigner ทีละพจน์ได้ ทั้งสองสัมพันธ์กันด้วย isometry แทน
isometry มาจากไหน: ใน Jordan-Wigner สถานะฐานคือสตริงการครอบครอง qubit เก็บ ส่วนการเข้ารหัสนี้เก็บ พาริตีสะสม แทน กำหนด
ดังนั้นบิต บันทึกพาริตีของการครอบครองทั้งหมดจนถึงและรวมไซต์ มีบิตแบบนี้ ตัวสำหรับการครอบครอง ตัว ซึ่งเป็นที่มาของ ancilla การครอบครองกู้คืนได้เป็น ผลต่าง ระหว่างบิตที่อยู่ติดกัน ไซต์ที่ถูกครอบครองจึงปรากฏเป็น domain wall ระหว่างสองบิตที่อยู่ติดกัน จึงเรียกว่าการเข้ารหัส domain-wall (หรือ Kramers-Wannier) และนั่นก็เป็นเหตุผลที่ : ผลคูณของ สองตัวที่อยู่ติดกันอ่านผลต่างนั้นออกมา
เมื่อเขียนแผนที่นี้ออกมาสำหรับบางสถานะ โครงสร้างจะเห็นชัดขึ้น (สังเกตว่า ถูกตรึงไว้ ดังนั้นมีเพียงครึ่งหนึ่งของสถานะ Qubit ทั้ง สถานะที่อยู่ในภาพ จึงเป็นไอโซเมทรีไม่ใช่ยูนิทารี):
>>> def domain_wall_bits(occupations):
...     parity = 0
...     bits = [0]
...     for occupation in occupations:
...         parity ^= occupation
...         bits.append(parity)
...     return bits
>>>
>>> for occupations in ([0, 0, 0, 0], [1, 0, 0, 0], [1, 1, 0, 0], [1, 0, 1, 0]):
...     bits = domain_wall_bits(occupations)
...     # little-endian: reversed() prints qubit 0 on the right, as Qiskit labels do
...     print("".join(map(str, occupations)), "->", "".join(str(b) for b in reversed(bits)))
0000 -> 00000
1000 -> 11110
1100 -> 00010
1010 -> 00110
เฟอร์มิออนตัวเดียวที่ไซต์ 0 จะพลิกพาริตีสะสมทุกตัวที่อยู่เหนือมัน ซึ่งก็คือผลของการ delocalization นั่นเอง เมื่อรวมคอลัมน์เหล่านี้เป็นเมทริกซ์ จะได้ไอโซเมทรี และการเข้ารหัสจะซื่อตรงเมื่อมัน intertwine แฮมิลโทเนียนทั้งสองเข้าด้วยกัน:
นั่นคือ การแมปสถานะเฟอร์มิออนเข้าสู่ปริภูมิ Qubit แล้วให้มันวิวัฒน์ที่นั่น ต้องได้ผลเหมือนกับการวิวัฒน์ในปริภูมิเฟอร์มิออนก่อนแล้วค่อยแมปทีหลัง
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp
>>> from qiskit_fermions.mappers.library import transfer_vertex_jordan_wigner
>>>
>>> def to_matrix(observable):
...     # SparseObservable carries no dense-matrix method, so route through
...     # SparsePauliOp. This is only ever needed for the checks below --
...     # the encoding itself never leaves SparseObservable.
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix()
>>>
>>> def domain_wall_isometry(num_sites):
...     isometry = np.zeros((2 ** (num_sites + 1), 2**num_sites), dtype=complex)
...     for index in range(2**num_sites):
...         occupations = [(index >> j) & 1 for j in range(num_sites)]
...         bits = domain_wall_bits(occupations)
...         isometry[sum(b << j for j, b in enumerate(bits)), index] = 1.0
...     return isometry
>>>
>>> isometry = domain_wall_isometry(num_sites)
>>> np.allclose(isometry.conj().T @ isometry, np.eye(2**num_sites))
True
>>>
>>> def intertwines(operator):
...     """Whether both mappings of `operator` agree through the isometry."""
...     flow = to_matrix(flow_set_encoding(operator, num_qubits))
...     reference = to_matrix(transfer_vertex_jordan_wigner(operator, num_sites).simplify())
...     return np.allclose(flow @ isometry, isometry @ reference)
>>>
>>> intertwines(hamiltonian)
True
>>> # and, more strongly, once per flow set: a product formula evolves the groups
>>> # separately, so each one has to be intertwined on its own
>>> all(intertwines(group) for group in hamiltonian.split_out_groups())
True
ความสัมพันธ์ intertwining เป็นจริงอย่างแม่นตรง และเป็นจริงแยกกันสำหรับแต่ละ flow set ข้อความที่สองซึ่งแข็งแรงกว่านี้คือสิ่งที่ขั้นตอนถัดไปอาศัย: product formula วิวัฒน์กลุ่มทีละกลุ่ม และผลคูณของตัวประกอบที่ intertwine กันก็ intertwine เช่นกัน ดังนั้น การประมาณ ใดๆ ที่สร้างจากกลุ่มเหล่านี้จึงให้ผลตรงกันระหว่างสองการเข้ารหัส แม้ว่าการเข้ารหัสจะต่างกัน เป็นผลสืบเนื่อง สเปกตรัมต้องตรงกัน โดยค่าไอเกนทุกค่าของ Jordan-Wigner ปรากฏสองครั้งในปริภูมิที่ใหญ่กว่า หนึ่งครั้งต่อค่าพาริตีรวมที่ไม่ถูกจำกัดแต่ละค่า:
>>> jw_matrix = to_matrix(transfer_vertex_jordan_wigner(hamiltonian, num_sites).simplify())
>>> flow_matrix = to_matrix(flow_set_encoding(hamiltonian, num_qubits))
>>>
>>> jw_spectrum = np.linalg.eigvalsh(jw_matrix)
>>> flow_spectrum = np.linalg.eigvalsh(flow_matrix)
>>> np.allclose(
...     np.sort(flow_spectrum),
...     np.sort(np.concatenate([jw_spectrum, jw_spectrum])),
... )
True
>>> print(f"{jw_spectrum[0]:.10f}  {flow_spectrum[0]:.10f}")
-1.8557725066  -1.8557725066
5. สร้างวงจรเฟอร์มิออน
ก่อนจะเกี่ยวข้องกับ Qubit ใดๆ พลวัตจะถูกแสดงในระดับ เฟอร์มิออน ก่อน FermionicCircuit ทำงานบนโหมดเฟอร์มิออนแทนที่จะเป็น Qubit และเกต Evolution บนแฮมิลโทเนียนก็คือวงจรทั้งหมด:
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import Evolution
>>> from qiskit_fermions.circuit.library.synthesis import FermionicLieTrotter
>>>
>>> total_time = 1.0
>>> circuit = FermionicCircuit(num_sites)
>>> circuit.append(
...     Evolution(
...         num_sites, hamiltonian, time=total_time, synthesis=FermionicLieTrotter()
...     ),
...     circuit.modes,
... )
>>> circuit.draw("mpl")
<Figure size ... with 1 Axes>

มีกล่องทึบหนึ่งกล่องครอบคลุมทั้งสี่โหมด และส่วนที่น่าสนใจคือมันแตกออกเป็นอะไร อาร์กิวเมนต์ synthesis บอกวิธี: FermionicLieTrotter คือ product formula อันดับหนึ่ง ซึ่งแยกตัวดำเนินการตาม groups ของมัน แล้ววิวัฒน์แต่ละกลุ่มตามลำดับ ดังนั้นการแบ่ง flow set จากขั้นตอนที่ 2 ก็คือ การทำ Trotterization และ decompose() ครั้งเดียวก็ทำให้เกิดผลนั้น โดยให้ Evolution หนึ่งตัวต่อหนึ่ง flow set ตามลำดับกลุ่ม: ตะวันออก ตะวันตก แล้วจึงอันตรกิริยาแนวทแยง ซึ่งมี 3, 3 และ 8 พจน์ตามลำดับ
>>> flow_set_circuit = circuit.decompose()
>>> flow_set_circuit.draw("mpl")
<Figure size ... with 1 Axes>
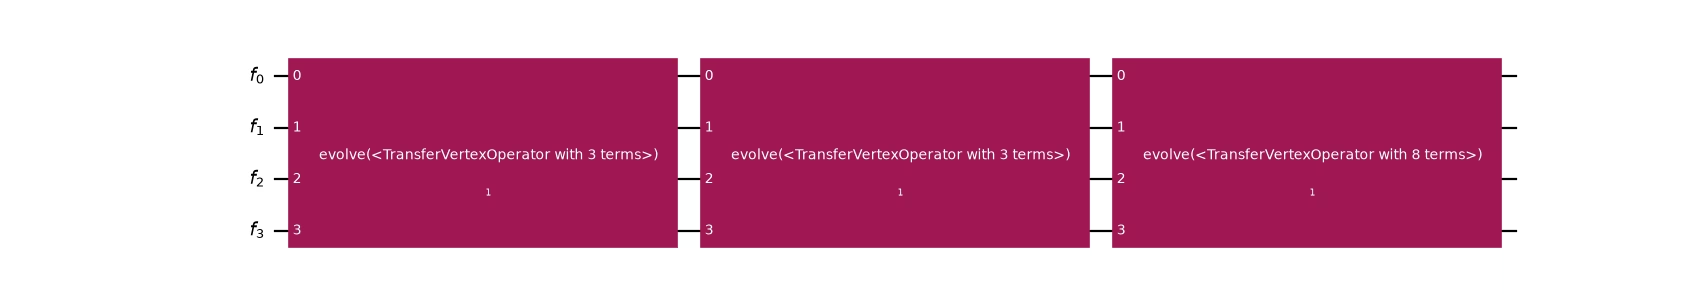
สังเกตว่าทั้งหมดนี้เกิดขึ้นในปริภูมิเฟอร์มิออนล้วนๆ: ยังไม่มีการกล่าวถึง Qubit เลย แต่การประมาณก็เกิดขึ้นแล้ว จำนวนขั้น Trotter จึงอยู่ที่นี่ด้วย ในรูป reps ซึ่งหารเวลาและทำซ้ำการกวาดทั้งหมด:
>>> def trotter_steps(reps):
...     step = FermionicCircuit(num_sites)
...     step.append(
...         Evolution(
...             num_sites,
...             hamiltonian,
...             time=total_time,
...             synthesis=FermionicLieTrotter(reps=reps),
...         ),
...         step.modes,
...     )
...     return step.decompose()
>>>
>>> trotter_steps(3).count_ops()["Evolution"]
9
เก้าเกต: สาม flow set วนซ้ำสามรอบ โดยแต่ละรอบใช้เวลาหนึ่งในสาม การวนนั้นเองที่ทำให้เป็น Trotterization ไม่ใช่แค่การหั่นกลุ่มเดียวใหม่ การทำซ้ำกลุ่ม เดียว ไม่ได้อะไรเลย เพราะเอกซ์โพเนนเชียลที่ต่อเนื่องกันของตัวดำเนินการเดียวกันสลับที่กันได้ ดังนั้น A(t/3) A(t/3) A(t/3) ก็คือ A(t) สูตรที่อ่านกลุ่มได้สามารถสลับสอดแทรกกลุ่มเหล่านั้นได้ แต่สูตรที่ใช้หลังการแมปทำไม่ได้ เพราะตอนนั้นการจัดกลุ่มหายไปแล้ว
นี่คือขั้นตอนที่ทำให้การจัดกลุ่มมีความสำคัญ แต่ละเกตที่ถูกปล่อยออกมาจะถูกแมปและสังเคราะห์แยกกัน ดังนั้นทุกอย่างปลายน้ำจึงทำงานตามการแบ่งที่ตัดสินใจไว้ในระดับเฟอร์มิออน การข้ามการ decompose จะส่งตัวดำเนินการทั้งหมดไปยังขั้นถัดไปแทน และการจัดกลุ่มจะถูกมองข้าม
6. Transpile ด้วยการเข้ารหัสแบบกำหนดเอง
ตอนนี้การเข้ารหัสพร้อมให้ Transpiler ใช้งานแล้ว ยังต้องมีอีกสองส่วน:
-
เลย์เอาต์
TrivialF2QLayoutค่าเริ่มต้นสมมติว่าหนึ่งโหมดใช้หนึ่ง Qubit ซึ่งไม่ถูกต้องในสถานการณ์นี้CustomF2QLayoutเชื่อมโยงรีจิสเตอร์เฟอร์มิออนกับQuantumRegisterที่มีขนาดต่างออกไป ซึ่งเป็นวิธีที่ Qubit ancilla เข้ามาในไปป์ไลน์ -
ปลั๊กอินสังเคราะห์
MapperFnEvolutionSynthesisรับฟังก์ชัน mapper โดยตรง แมปแฮมิลโทเนียนของเกตEvolutionด้วยมัน และปล่อยPauliEvolutionGateโดยรักษาข้อกำหนด ไว้product_formulaของมันเป็นตัวกำหนดว่าเกตนั้นถูกแปลงเป็นการหมุนอย่างไร สังเกตว่านี่คือ product formula ตัวที่สอง ที่เป็นอิสระ ซึ่งทำงานบน Qubit หลังการแมป: ที่นี่ส่งLieTrotterของ Qiskit เข้าไป และขั้นตอนที่ 7 จะแทนที่ด้วยตัวที่รู้จัก flow set
เนื่องจากทุกการเปรียบเทียบด้านล่างต้องรันไปป์ไลน์นี้ซ้ำ จึงควรห่อมันไว้ครั้งเดียว:
>>> from qiskit.circuit import QuantumRegister
>>> from qiskit.passmanager import MultiStagePassManager
>>> from qiskit_fermions.transpiler import FermionicCircuitToDAG, QuantumDAGToCircuit
>>> from qiskit_fermions.transpiler.passes import (
...     CustomF2QLayout,
...     F2QSynthesis,
...     MapperFnEvolutionSynthesis,
... )
>>>
>>> def flow_set_pass_manager(mode_register, product_formula=None):
...     '''Build the pipeline mapping `mode_register` with the flow-set encoding.'''
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         flow_set_encoding, product_formula=product_formula
...     )
...     # this encoding spends one ancilla on top of the fermionic modes
...     qubit_register = QuantumRegister(mode_register.size + 1, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from qiskit.synthesis import LieTrotter
>>>
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, LieTrotter())
>>> qubit_circuit = pass_manager.run(flow_set_circuit)
>>> qubit_circuit.num_qubits
5
โหมดเฟอร์มิออนสี่โหมดกลายเป็นวงจรห้า Qubit โดยมี ancilla มาจากเลย์เอาต์แบบกำหนดเอง
ตอนนี้ลองดูว่าวงจรที่ได้มีอะไรอยู่จริงๆ การ decompose ซ้ำๆ จะลดเกต evolution ลงจนเหลือแค่ U และ CX เพื่อให้ต้นทุนสองคิวบิตของกลยุทธ์การสังเคราะห์สองแบบที่เปรียบเทียบด้านล่างถูกวัดด้วยหน่วยเดียวกัน: จากนั้น count_ops() จะรายงานจำนวน CX และ depth() รับฟังก์ชันตัวกรองเพื่อวัดความลึกสองคิวบิต สังเกตว่า reps นี้คือความลึกของการ decompose ซึ่งไม่เกี่ยวกับจำนวนขั้น Trotter ที่ product formula ใช้ ซึ่งในคู่มือนี้ภายหลังก็เรียกว่า reps เช่นกัน:
>>> decomposed = qubit_circuit.decompose(reps=6)
>>> decomposed.count_ops()["cx"]
26
>>> decomposed.depth(lambda instruction: len(instruction.qubits) == 2)
23
เกต CX ยี่สิบหกเกตใน 23 เลเยอร์ แทบไม่มีอะไรทำงานแบบขนานเลย การวาดวงจรจะแสดงเหตุผล:
>>> decomposed.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
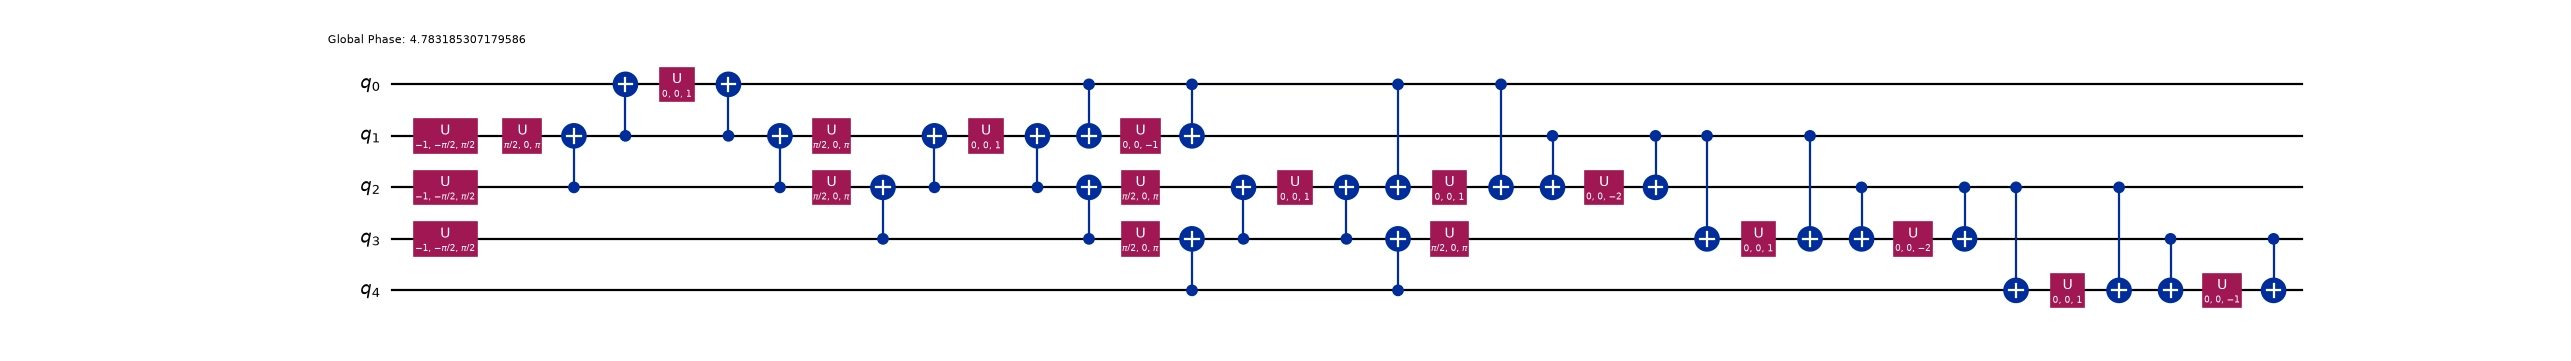
ทุกพจน์ถูกคอมไพล์แยกกัน: เปลี่ยนเบสิส ไล่บันได CX ลงไปยังการหมุนเดียว แล้วจึงยกเลิกบันไดนั้น flow set น้ำหนัก 1 ไม่มีต้นทุน พจน์ของมันเป็นการหมุนเดี่ยวๆ ไม่มีบันไดล้อมรอบ แต่แต่ละพจน์น้ำหนัก 3 ต้องจ่ายเกต CX สี่ตัว และเนื่องจากบันไดถูกปล่อยออกมาตามลำดับ จึงไม่มีอะไรซ้อนทับกัน
ดังนั้นการจัดกลุ่มอยู่รอดผ่านไปป์ไลน์ทั้งหมด (สาม flow set, สาม PauliEvolutionGate ที่ถูกแมปแล้ว) แต่ก็ยังได้ประโยชน์แทบไม่มี การทำ Trotterization แบบเฟอร์มิออนในขั้นตอนที่ 5 ทำหน้าที่ของมันแล้ว สิ่งที่ทำให้สูญเปล่าคือสูตรฝั่ง Qubit LieTrotter ได้รับชุดพจน์ที่มันไม่ได้รับการบอกอะไรเลย และคอมไพล์แต่ละพจน์แยกกัน มันไม่อาจรู้ว่าพจน์เหล่านั้นสลับที่กันได้ทั้งหมด จึงทำให้เป็นลำดับต่อกันทั้งที่อาจใช้การเปลี่ยนเบสิสร่วมกันได้
นั่นคือช่องว่างที่การเข้ารหัสนี้มีไว้เพื่ออุดช่อง: มี product formula สองตัวทำงานอยู่ และจนถึงตอนนี้มีเพียงตัวฝั่งเฟอร์มิออนที่ได้รับโครงสร้าง ขั้นตอนถัดไปจะให้การสังเคราะห์ฝั่ง Qubit ที่ใช้ประโยชน์จากโครงสร้างนั้นด้วย
7. การสังเคราะห์ที่รู้จัก flow set
การกู้ข้อได้เปรียบคืนหมายถึงการบอกโครงสร้างให้การสังเคราะห์ฝั่ง Qubit รู้ นี่คือหัวข้อ IV C ของเอกสารอ้างอิง [1]: เนื่องจากทุกพจน์ของ flow set สลับที่กันได้ จึงสามารถทำให้เป็นแนวทแยงพร้อมกันได้ด้วยวงจร Clifford เดียว หมุนในเบสิสร่วมหนึ่งเดียวแล้วหมุนกลับ แทนที่จะทำทีละพจน์
สำหรับการเข้ารหัสนี้ Clifford นั้นง่าย การคอนจูเกตด้วยโซ่เกต CZ บนเพื่อนบ้านที่อยู่ติดกันจะแมป
พร้อมกันสำหรับทุก โซ่ CZ หนึ่งเส้นเปลี่ยน flow set น้ำหนัก 3 (ตะวันตก) ทั้งหมดให้เป็นเลเยอร์ของการหมุน ของ Qubit เดี่ยวที่เป็นอิสระต่อกัน อินเทอร์เฟซ EvolutionSynthesis ขอเพียงเมธอด synthesize() ซึ่งเป็นสิ่งเดียวที่คลาสนี้ implement มันไม่มีจำนวนขั้น Trotter เพราะรับ flow set ทีละชุด จึงไม่อาจแบ่งย่อยการวิวัฒน์ข้ามชุดต่างๆ ได้ การแบ่งย่อยนั้นอยู่สูงขึ้นไปหนึ่งระดับ ในปริภูมิเฟอร์มิออน ที่ซึ่ง F2FSynthesisPlugin มองเห็นทั้งหมดพร้อมกัน (ดู ขั้นตอนที่ 9):
>>> from qiskit.circuit import QuantumCircuit
>>> from qiskit.synthesis.evolution import EvolutionSynthesis
>>>
>>> def cz_brickwork(circuit):
...     # emit even and odd bonds as two layers, so the CZs are scheduled in
...     # parallel: a chain of overlapping CZs has depth 2, not num_qubits - 1
...     #
...     # NOTE: CZ gates are diagonal, so they all commute and each is its own inverse.
...     # This whole layer is therefore self-inverse, which is why the conjugation below
...     # calls it twice rather than calling it and then its inverse.
...     for offset in (0, 1):
...         for j in range(offset, circuit.num_qubits - 1, 2):
...             circuit.cz(j, j + 1)
>>>
>>> # The interaction reaches nearest (distance 1) and next-nearest (distance 2)
>>> # neighbors, so every interior qubit carries four Rzz gates and can only do one at
>>> # a time: four layers is the best any schedule can do. These offsets achieve it.
>>> def rzz_layers(circuit, angles):
...     """Emit the diagonal Rzz gates in four layers of disjoint qubit pairs."""
...     near = [(j, k) for j, k in angles if k - j == 1]
...     far = [(j, k) for j, k in angles if k - j == 2]
...     schedule = [
...         [(j, k) for j, k in near if j % 2 == 0],
...         [(j, k) for j, k in far if j % 4 in (0, 1)],
...         [(j, k) for j, k in near if j % 2 == 1],
...         [(j, k) for j, k in far if j % 4 in (2, 3)],
...     ]
...     # emit layer by layer, since Qiskit's depth follows the order gates were added
...     for layer in schedule:
...         for j, k in layer:
...             circuit.rzz(angles[j, k], j, k)
>>>
>>> class FlowSetSynthesis(EvolutionSynthesis):
...     '''Synthesize one flow set of the encoded Hamiltonian at a time.'''
...
...     preserve_order = True
...
...     def synthesize(self, evolution):
...         circuit = QuantumCircuit(evolution.operator.num_qubits)
...         east, west, diagonal = [], [], {}
...
...         for label, indices, coeff in evolution.operator.to_sparse_list():
...             angle = 2 * evolution.time * coeff.real
...             match label, indices:
...                 case "", _:  # the identity contributes only a global phase
...                     circuit.global_phase -= angle / 2
...                 case "X", [qubit]:  # east flow set: already weight-1
...                     east.append((qubit, angle))
...                 case "ZXZ", [j, k, l] if (k, l) == (j + 1, j + 2):
...                     west.append((k, angle))  # needs the CZ conjugation below
...                 case "ZZ", [j, k]:  # interaction: diagonal, see rzz_layers above
...                     diagonal[min(j, k), max(j, k)] = angle
...                 case _:
...                     raise ValueError(f"unexpected Pauli term: {label} on {indices}")
...
...         # east flow set: bare rotations, no entangling gates at all
...         for qubit, angle in east:
...             circuit.rx(angle, qubit)
...
...         # west flow set: one CZ chain diagonalizes the WHOLE set at once
...         if west:
...             cz_brickwork(circuit)
...             for qubit, angle in west:
...                 circuit.rx(angle, qubit)
...             cz_brickwork(circuit)
...
...         if diagonal:
...             rzz_layers(circuit, diagonal)
...
...         return circuit
มีรายละเอียดสองอย่างที่พลาดได้ง่าย EvolutionSynthesis แบบกำหนดเองต้องมีแอตทริบิวต์ preserve_order ซึ่งพาสการสังเคราะห์ระดับสูงจะอ่านค่านี้
ตัวช่วยทั้งสองปล่อยเกตของมันเป็นเลเยอร์ที่ชัดเจน ไม่ใช่ตามลำดับพจน์ เพราะ depth() จัดตารางเกต โดยเร็วที่สุดตามลำดับที่เพิ่มเข้ามา เนื่องจากเกตทั้งหมดภายในชุดหนึ่งสลับที่กันได้ ลำดับจึงเลือกได้อิสระ การสังเคราะห์ทีละพจน์เลือกลำดับได้ไม่ดี การปล่อยโซ่ CZ ที่ทับซ้อนกันตามลำดับจะรายงานความลึกที่โตตามจำนวน Qubit แทนที่จะเป็นค่าคงที่ 2 ที่ฮาร์ดแวร์ทำได้
นี่คือเหตุผลที่การสังเคราะห์ข้างต้นไม่มีจำนวนขั้น Trotter มันรับหนึ่ง flow set ต่อเกต การทำซ้ำภายในมันจึงเป็นการทำซ้ำ ภายใน ชุดเดียว ไม่ใช่การวนระหว่างชุด:
repeating within one set:      A(t/2) A(t/2) B(t/2) B(t/2)
what a Trotterization needs:   A(t/2) B(t/2) A(t/2) B(t/2)
รูปแบบแรกไม่ได้อะไรเลย: เอกซ์โพเนนเชียลที่ต่อเนื่องกันของตัวดำเนินการเดียวกันสลับที่กันได้ ดังนั้น A(t/2) A(t/2) ก็คือ A(t) และความคลาดเคลื่อนยังคงอยู่ที่ค่าขั้นเดียวไม่ว่าจะขอกี่ขั้น
จำนวนขั้นจึงเป็นของ FermionicLieTrotter ฝั่งเฟอร์มิออนในขั้นตอนที่ 5 ซึ่งอ่าน groups และสลับสอดแทรกกลุ่มได้ การแบ่งหน้าที่นี้คือประเด็นสำคัญ: สูตรฝั่งเฟอร์มิออนตัดสินว่า กี่ขั้น และ ลำดับใด ส่วนคลาสนี้ตัดสินว่าแต่ละชุดที่ได้จะถูกทำให้เป็นจริง ได้ถูกแค่ไหน
หากต้องการเลือกลำดับ ให้ส่งไปยัง MapperFnEvolutionSynthesis.product_formula ซึ่งเป็นอาร์กิวเมนต์ที่ flow_set_pass_manager รับ ไม่มีอย่างอื่นในไปป์ไลน์ (หรือวงจรเฟอร์มิออนที่มันรันอยู่) เปลี่ยนไป:
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, FlowSetSynthesis())
>>>
>>> flow_circuit = pass_manager.run(flow_set_circuit).decompose(reps=6)
>>> flow_circuit.count_ops()["cx"]
22
>>> flow_circuit.depth(lambda instruction: len(instruction.qubits) == 2)
12
>>> flow_circuit.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
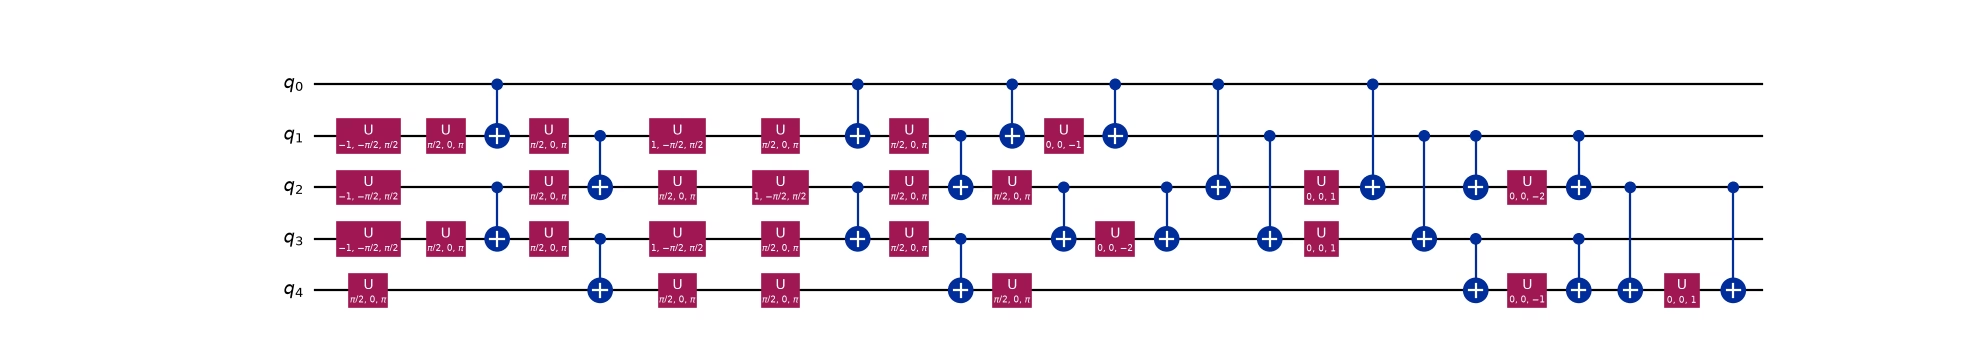
จากความลึก 23 ที่มีเกต CX 26 ตัว ลดลงเหลือความลึก 12 ที่มีเกต CX 22 ตัว สังเกตว่านี่คือเกตพัวพันที่น้อยลงและความลึกเกือบครึ่งหนึ่ง เมื่อเปรียบเทียบภาพทั้งสอง ความต่างไม่ใช่ว่าเกตถูกกว่า แต่เป็นว่ามัน ซ้อนกัน บันไดแบบอนุกรมหายไป เกตพัวพันตอนนี้วางซ้อนกันในเลเยอร์ร่วม เพราะ flow set ตะวันตกทั้งหมดถูกหมุนในเบสิสร่วมเดียว และอันตรกิริยาถูกปล่อยออกมาเป็นเลเยอร์ของคู่ที่ไม่ซ้อนกัน
FlowSetSynthesis จับคู่รูปแบบกับดัชนี Qubit สัมบูรณ์ ซึ่งปลอดภัยที่นี่เพราะทุก flow set ของแฮมิลโทเนียนนี้ครอบคลุมรีจิสเตอร์ทั้งหมดเท่านั้น product formula แบบเฟอร์มิออนจะลดแต่ละตัวประกอบให้เหลือเฉพาะโหมดที่มันแตะจริง ดังนั้นการจัดกลุ่มที่ชุดของมันครอบคลุมเพียงบางส่วนของโซ่ จะมาในรูปที่ถูกเปลี่ยนป้ายใหม่ และรูปแบบข้างต้นจะไม่ตรงกัน
ภาพวาดทั้งสองแสดงวงจรหลัง decompose(reps=6) ซึ่งเขียนทุกอย่างใหม่เป็นเบสิส U และ CX ดังนั้นเกต CZ, Rx และ Rzz ที่ FlowSetSynthesis ปล่อยออกมาจึงมองไม่เห็นในรูปนั้น นี่ตั้งใจ: เพื่อให้วงจรทั้งสองอยู่ในเบสิสเดียวกัน ซึ่งเป็นวิธีเดียวที่จำนวนและความลึกสองคิวบิตข้างต้นจะเปรียบเทียบกันได้ สิ่งที่น่าสังเกตในรูปเหล่านี้คือ โครงสร้างเลเยอร์ ไม่ใช่ป้ายชื่อเกต
8. ความลึกคงที่เมื่อขยายขนาด
คำถามที่น่าสนใจไม่ใช่จำนวนที่สี่โหมด แต่คือมัน ขยายขนาด อย่างไร เลเยอร์ brickwork CZ สองชั้นไม่โตตามความยาวโซ่ ดังนั้นความลึกสองคิวบิตของหนึ่งขั้น Trotter ควรคงที่ วัดโดยตรงบนแฮมิลโทเนียน Fermi-Hubbard เต็มรูปแบบ ซึ่งไกลเกินกว่าที่จำลองด้วยกำลังเดรัจฉานได้:
>>> def evolution_stats(num_sites, product_formula):
...     operator = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
...     operator.groups = flow_set_groups(operator)
...
...     circuit = FermionicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, operator, time=total_time, synthesis=FermionicLieTrotter()
...         ),
...         circuit.modes,
...     )
...     circuit = circuit.decompose()  # one Evolution per flow set, as in step 5
...
...     pass_manager = flow_set_pass_manager(circuit.register, product_formula)
...     decomposed = pass_manager.run(circuit).decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     return decomposed.count_ops()["cx"], decomposed.depth(two_qubit)
>>>
>>> sites = [4, 10, 20, 50, 100]
>>> flow = [evolution_stats(n, FlowSetSynthesis()) for n in sites]
>>> lie_trotter = [evolution_stats(n, LieTrotter()) for n in sites]
>>>
>>> [depth for _, depth in flow]
[12, 12, 12, 12, 12]
>>> [depth for _, depth in lie_trotter]
[23, 47, 87, 207, 407]
ความลึกสองคิวบิต คงที่ที่ 12 ตั้งแต่สี่โหมดถึง 100 ขณะที่ LieTrotter โตเชิงเส้นไปถึง 407 flow set ช่วยให้ทำงานขนานได้เล็กน้อย ภายใน ไปป์ไลน์ แต่แต่ละชุดยังถูก Trotterize ทีละพจน์ การโตจึงเพียงช้าลง ไม่ได้หายไป:
>>> import matplotlib.pyplot as plt
>>>
>>> figure, axes = plt.subplots(1, 2, figsize=(9, 3.5), layout="constrained")
>>> for panel, index, title in zip(axes, (1, 0), ("two-qubit depth", "CX count")):
...     _ = panel.plot(sites, [stat[index] for stat in lie_trotter], "o-", label="qubit-level")
...     _ = panel.plot(sites, [stat[index] for stat in flow], "s-", label="flow set")
...     _ = panel.set(xlabel="modes", title=title)
...     _ = panel.legend()
>>> figure
<Figure size ... with 2 Axes>

จำนวนเกตโตเชิงเส้นทั้งสองแบบ (มี พจน์ที่ต้องใช้ และหลีกเลี่ยงไม่ได้) แต่การสังเคราะห์แบบ flow set ใช้มันในเลเยอร์ขนานจำนวนคงที่ นี่คือผลลัพธ์ความลึกคงที่ของเอกสารอ้างอิง [1]
ความลึก 12 แบ่งไปตามสาม flow set เป็น 0 + 4 + 8 ที่ทุกความยาวโซ่ flow set ตะวันออกมีส่วนร่วม ศูนย์ มันคือการหมุน Rx ล้วนๆ flow set ตะวันตกมีต้นทุน 4 จากเลเยอร์ brickwork CZ สองชั้นขาเข้าและสองชั้นขาออก ถ้าตัดอันตรกิริยาออก ความลึกสองคิวบิตจะเหลือ สี่ ที่ทุกความยาวโซ่ ส่วนที่เหลือ แปด คืออันตรกิริยาที่พจน์ Rzz กระทำต่อทั้งเพื่อนบ้านใกล้สุดและใกล้รองลงมา จึงต้องมีเลเยอร์ที่ไม่ซ้อนกันสี่ชั้น แต่ละชั้นมีต้นทุนเกต CX สองตัว สี่เป็นค่าที่เหมาะสมที่สุดที่นี่: ทุก Qubit ภายในมีเกต Rzz สี่ตัว (สองตัวต่อเพื่อนบ้านแต่ละข้าง และสองตัวต่อเพื่อนบ้านใกล้รองลงมาแต่ละข้าง) และเข้าร่วมได้ทีละตัวเท่านั้น จึงไม่มีตารางเวลาใดทำได้ดีกว่า
สองในสามของความลึกคืออันตรกิริยา ซึ่งแสดงว่าการเข้ารหัสนี้เก่งเรื่องการกระโดด (hopping) และจึงเก่งเรื่องพลวัตของโซ่เฟอร์มิออนอิสระ อย่างไรก็ตาม สังเกตว่าอันตรกิริยาไม่สลับที่กับ hopping การตัดมันออก ไม่ใช่ การประมาณของ Fermi-Hubbard แต่เป็นแบบจำลองอื่น จุดที่สมดุลสำหรับปัญหาหนึ่งๆ น่าสำรวจ
9. ตรวจสอบพลวัต
ภายใต้แผนที่ domain-wall รูปแบบการครอบครองจะกลายเป็นสตริงพาริตีสะสม ดังนั้นสถานะเริ่มต้นจึงถูกเตรียมต่างจาก Jordan-Wigner นี่คือผลในทางปฏิบัติที่มองข้ามได้ง่ายของการ delocalize พาริตี ตัวช่วยจากขั้นตอนที่ 4 ให้ป้ายที่ถูกต้อง:
>>> occupations = [1, 0, 1, 0]
>>> initial_label = "".join(str(b) for b in reversed(domain_wall_bits(occupations)))
>>> initial_label
'00110'
เมื่อเตรียมสถานะแล้ว ยังเหลือสองคำถาม และควรถามแยกกัน: การสังเคราะห์แบบ flow set คำนวณสิ่งที่ ถูกต้อง หรือไม่ และคำนวณได้ ถูกกว่า หรือไม่?
มาดูความถูกต้องก่อน FlowSetSynthesis และ LieTrotter ของ Qiskit ได้รับ flow set ที่เข้ารหัสแล้วชุดเดียวกันจากการทำ Trotterization แบบเฟอร์มิออนเดียวกัน ดังนั้นต้องให้ยูนิทารีเดียวกันจนถึงเฟสรวม Clifford แบบกำหนดเองจัดระเบียบงานใหม่ แต่ไม่เปลี่ยนผลลัพธ์ สเตตเวกเตอร์สุ่มตรวจจับความคลาดเคลื่อนได้ถูกกว่าการสร้างยูนิทารีเต็มมาก:
>>> from qiskit.quantum_info import Statevector
>>>
>>> rng = np.random.default_rng(1234)
>>>
>>> def agrees_up_to_one_phase(reps, samples=3):
...     """Compare both qubit-side syntheses of the same fermionic Trotterization."""
...     step = trotter_steps(reps)
...     trotter = flow_set_pass_manager(step.register, LieTrotter()).run(step)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     trotter, flow = trotter.decompose(reps=6), flow.decompose(reps=6)
...     dimension = 2**trotter.num_qubits
...     residuals, phases = [], []
...     for _ in range(samples):
...         vector = rng.normal(size=dimension) + 1j * rng.normal(size=dimension)
...         state = Statevector(vector / np.linalg.norm(vector))
...         a = state.evolve(trotter).data
...         b = state.evolve(flow).data
...         overlap = np.vdot(a, b)
...         phases.append(overlap / abs(overlap))
...         residuals.append(np.linalg.norm(b - a * overlap / abs(overlap)))
...     # the SAME global phase must work for every input state
...     spread = max(abs(phase - phases[0]) for phase in phases)
...     return bool(max(residuals) < 1e-9), bool(spread < 1e-9)
>>>
>>> [agrees_up_to_one_phase(reps) for reps in (1, 3)]
[(True, True), (True, True)]
ทั้งสองส่วนของการตรวจสอบนั้นสำคัญ โอเวอร์แลปที่มีขนาดหนึ่งบนสถานะเดียวจำเป็นแต่ไม่เพียงพอ: การสังเคราะห์ที่เฟสซึ่งขึ้นกับสถานะผิดก็ยังแสดงให้เห็นได้ การกำหนดให้เฟส เดียวกัน ในหลายสถานะสุ่มคือสิ่งที่อุดช่องว่าง การตรวจสอบมากกว่าหนึ่งค่า reps ก็สำคัญเช่นกัน เพราะยืนยันว่าความสอดคล้องอยู่รอดผ่านการสลับสอดแทรกของ flow set ไม่ใช่เป็นจริงเฉพาะการกวาดครั้งเดียว
ดังนั้นการเลือกการสังเคราะห์ฝั่ง Qubit จึงไม่ส่งผลต่อความแม่นยำ ซึ่งทำให้การเปรียบเทียบต้นทุนมีความหมาย คำถามที่เหลือคือการเข้ารหัสโดยรวมได้อะไรเมื่อเทียบกับทางเลือกที่ชัดเจน: Jordan-Wigner ธรรมดาบน num_sites Qubit โดยไม่มี ancilla และไม่มี Clifford แบบกำหนดเอง ทั้งการเข้ารหัสและการสังเคราะห์ฝั่ง Qubit ต่างกันระหว่างสองคอลัมน์ แต่การตรวจสอบข้างต้นแสดงว่าอย่างหลังไม่อาจกระทบผลลัพธ์ สิ่งที่ฟิเดลิตีทดสอบจึงเป็นการเข้ารหัส ทั้งสองไปป์ไลน์ยังเริ่มจากการทำ Trotterization แบบเฟอร์มิออน เดียวกัน ดังนั้นความต่างของฟิเดลิตีใดๆ จะบ่งชี้บั๊ก ไม่ใช่การแลกเปลี่ยน สองคอลัมน์คือ การเข้ารหัส คือ flow set เทียบกับ Jordan-Wigner:
>>> def jordan_wigner_pass_manager(mode_register, product_formula):
...     """The same pipeline under plain Jordan-Wigner: one qubit per mode."""
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         transfer_vertex_jordan_wigner, product_formula=product_formula
...     )
...     qubit_register = QuantumRegister(mode_register.size, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from scipy.linalg import expm
>>>
>>> jw_state = np.zeros(2**num_sites, dtype=complex)
>>> jw_state[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> reference_jw = expm(-1j * total_time * jw_matrix) @ jw_state
>>> reference_flow = expm(-1j * total_time * flow_matrix) @ (isometry @ jw_state)
>>>
>>> def cost_and_fidelity(reps):
...     step = trotter_steps(reps)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     jw = jordan_wigner_pass_manager(step.register, LieTrotter()).run(step)
...     flow, jw = flow.decompose(reps=6), jw.decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     evolved_flow = Statevector.from_label(initial_label).evolve(flow).data
...     evolved_jw = Statevector(jw_state).evolve(jw).data
...     return (
...         abs(np.vdot(evolved_flow, reference_flow)) ** 2,
...         flow.count_ops()["cx"],
...         flow.depth(two_qubit),
...         abs(np.vdot(evolved_jw, reference_jw)) ** 2,
...         jw.count_ops()["cx"],
...         jw.depth(two_qubit),
...     )
>>>
>>> for reps in (1, 2, 4, 8):
...     flow_f, flow_cx, flow_d, jw_f, jw_cx, jw_d = cost_and_fidelity(reps)
...     print(
...         f"{reps} step(s):  flow set {flow_f:.6f}"
...         f" ({flow_cx:3d} CX, depth {flow_d:3d})"
...         f"   JW {jw_f:.6f} ({jw_cx:3d} CX, depth {jw_d:3d})"
...     )
1 step(s):  flow set 0.590661 ( 22 CX, depth  12)   JW 0.590661 ( 18 CX, depth  14)
2 step(s):  flow set 0.926656 ( 44 CX, depth  24)   JW 0.926656 ( 36 CX, depth  26)
4 step(s):  flow set 0.982053 ( 88 CX, depth  48)   JW 0.982053 ( 72 CX, depth  50)
8 step(s):  flow set 0.995395 (176 CX, depth  96)   JW 0.995395 (144 CX, depth  98)
อ่านคอลัมน์ฟิเดลิตีก่อน: เหมือนกันทุกหลักที่พิมพ์ ในปริภูมิฮิลเบิร์ตสองแบบภายใต้การเข้ารหัสสองแบบ นั่นคือการทำ Trotterization แบบเฟอร์มิออนที่ส่องผ่านออกมา การประมาณถูกตรึงในขั้นตอนที่ 5 ก่อนเลือกการเข้ารหัสใดๆ ดังนั้นทั้งสองวงจรจึงมีความคลาดเคลื่อนเท่ากับสูตรอันดับหนึ่งบนสาม flow set พอดี และมันลดลงประมาณสี่เท่าเมื่อจำนวนขั้นเพิ่มเป็นสองเท่า
สิ่งที่การเข้ารหัสต่างกันคือต้นทุน และการแลกเปลี่ยนนี้ควรกล่าวให้ชัด flow set ใช้เกตพัวพัน มากกว่า: 22 เทียบกับ 18 ที่หนึ่งขั้น สาเหตุไม่ใช่ ancilla เพราะมันไม่มีเกตสองคิวบิตของตัวเอง สาเหตุคืออันตรกิริยา ตามที่ขั้นตอนที่ 3 เตือนไว้: การ delocalize พาริตีเปลี่ยนพจน์ ZZ เพื่อนบ้านใกล้สุดสามพจน์ให้เป็นเจ็ดพจน์ที่ครอบคลุมเพื่อนบ้านใกล้สุด และ ใกล้รองลงมา และแต่ละพจน์ต้องใช้เกต CX สองตัว นั่นคือราคาที่จ่ายเพื่อให้ hopping ถูกลง
มันยังชนะแค่เฉียดฉิวด้านความลึกที่ขนาดนี้ (12 เทียบกับ 14) เพราะสี่โหมดเล็กเกินกว่าจะเห็นอาการเชิงเส้นกำกับ ประเด็นคือ การขยายขนาด ที่วัดในขั้นตอนที่ 8: ความลึก 12 นั้นคงที่ ขณะที่ความลึกของ Jordan-Wigner โตตามโซ่ ที่ 14 โหมดมันเป็น 12 เทียบกับ 34 แล้ว
การเรียก decompose() ข้างต้นเป็นสิ่งจำเป็น ด้วยเหตุผลอิสระสองข้อ
evolve() และ Operator ใช้นิยามที่ แม่นตรง ของ PauliEvolutionGate โดยข้ามการสังเคราะห์ฝั่ง Qubit แบบกำหนดเอง การตรวจสอบกับวงจรที่ไม่ถูก decompose จะรายงานฟิเดลิตีสมบูรณ์แม้กับการสังเคราะห์ที่ตั้งใจให้ผิด
เช่นเดียวกันนี้ใช้กับระดับที่สูงขึ้นหนึ่งขั้น คือการสังเคราะห์แบบเฟอร์มิออน เกต Evolution ที่ไม่เคยถูก decompose จะไปยังขั้นตอนเฟอร์มิออนเป็น Qubit ทั้งก้อน ซึ่งแมปมันโดยไม่ดู Evolution.synthesis เลย ดังนั้น reps จะไม่มีผลใดๆ อย่างเงียบๆ trotter_steps จากขั้นตอนที่ 5 ทำการ decompose นั้น ส่วนไปป์ไลน์ที่ตั้งค่าเมธอดด้วย F2FSynthesis จะได้การขยายแบบเดียวกันจากพาสแทน
เป็นการตรวจสอบข้ามขั้นสุดท้าย ความหนาแน่นของไซต์ ที่คำนวณในปริภูมิที่เข้ารหัสต้องให้ผลเหมือน Jordan-Wigner การตรวจสอบนี้เกี่ยวกับ การเข้ารหัส ไม่ใช่วงจร จึงไม่มีการประมาณ Trotter เข้ามาเกี่ยวข้อง การวิวัฒน์ตามเวลาทั้งสองคำนวณแบบแม่นตรงด้วยการยกกำลังเมทริกซ์ของแฮมิลโทเนียนแต่ละตัว ดังนั้นความคลาดเคลื่อนใดๆ จะชี้ไปที่การเข้ารหัสไม่ใช่ product formula:
>>> time = 0.8
>>> state_jw = np.zeros(2**num_sites, dtype=complex)
>>> state_jw[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> evolved_jw = expm(-1j * time * jw_matrix) @ state_jw
>>> evolved_flow = expm(-1j * time * flow_matrix) @ (isometry @ state_jw)
>>>
>>> for j in range(num_sites):
...     v_flow = to_matrix(
...         SparseObservable.from_sparse_list([("ZZ", [j, j + 1], 1.0)], num_qubits)
...     )
...     v_jw = to_matrix(SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_sites))
...     density_flow = (1 - np.vdot(evolved_flow, v_flow @ evolved_flow).real) / 2
...     density_jw = (1 - np.vdot(evolved_jw, v_jw @ evolved_jw).real) / 2
...     print(f"site {j}:  {density_flow:.10f}  {density_jw:.10f}")
site 0:  0.6507935456  0.6507935456
site 1:  0.5963201678  0.5963201678
site 2:  0.3365016619  0.3365016619
site 3:  0.4163846247  0.4163846247
ความหนาแน่นตรงกันถึงทศนิยมสิบตำแหน่ง
สิ่งที่ควรจดจำ
-
จัดกลุ่มก่อนแมป flow set ถูกนิยามบนกราฟอันตรกิริยาเฟอร์มิออนแบบมีทิศทาง ดังนั้นการจัดกลุ่มจึงถูกเลือกขณะที่โครงสร้างของปัญหายังมีอยู่ แอตทริบิวต์
groupsนำมันเข้าไปในวงจร ซึ่งdecompose()ครั้งเดียวจะเปลี่ยนให้เป็นเกตEvolutionหนึ่งตัวต่อ flow set -
Ancilla ซื้อโครงสร้าง การใช้ Qubit เพิ่มหนึ่งตัวเปลี่ยน flow set ทั้งชุดให้เป็นเพาลีน้ำหนัก 1 ซึ่งการวิวัฒน์ไม่ต้องใช้เกตพัวพันเลย เอกสารอ้างอิง [1] สังเกตการแลกเปลี่ยนนี้ในภาพรวม อัตราส่วน Qubit ต่อเฟอร์มิออนที่มากขึ้นยอมให้วงจรวิวัฒน์ที่ตื้นขึ้น
-
การเข้ารหัสแบบกำหนดเองคือหนึ่งฟังก์ชัน แมปตัวดำเนินการถ่ายโอนทั่วไปหนึ่งตัวไปเป็นสตริงเพาลี
map_transfer_vertex_generators()และMapperFnEvolutionSynthesisทำส่วนที่เหลือ -
การแมปและการจัดกลุ่มเพียงอย่างเดียวไม่พอ การแยกการวิวัฒน์ตาม flow set เพียงชะลอการโตเชิงเส้นของความลึก การสังเคราะห์ทีละพจน์ของแต่ละชุดยังทิ้งข้อเท็จจริงที่ว่าพจน์ของมันสลับที่กันได้ มีเพียงการให้
EvolutionSynthesisที่รู้จัก flow set เท่านั้นที่ทำให้ความลึกคงที่ การเข้ารหัสแบบกำหนดเอง การจัดกลุ่ม และการสังเคราะห์แบบกำหนดเองเสริมกัน: ต้องมีทั้งสามอย่าง -
Product formula สองตัว สองหน้าที่
FermionicLieTrotterตรึงการประมาณในปริภูมิเฟอร์มิออน ที่ซึ่งการจัดกลุ่มยังมองเห็นได้ ดังนั้นมันเพียงตัวเดียวกำหนดความคลาดเคลื่อน Trotter และจำนวนขั้น จากนั้นEvolutionSynthesisฝั่ง Qubit ตัดสินเพียงว่าแต่ละชุดถูกทำให้เป็นจริงได้ถูกแค่ไหน: ขั้นตอนที่ 9 ยืนยันว่าสองตัวเลือกให้ยูนิทารีเดียวกัน การแยกสองสิ่งนี้คือสิ่งที่ทำให้ปรับความแม่นยำและต้นทุนได้อย่างอิสระ ดู การสังเคราะห์เกต Evolution ในปริภูมิเฟอร์มิออน -
ตรวจสอบมัน การเข้ารหัสที่เป็นไปตามความสัมพันธ์การสลับที่ อาจยังแทนแฮมิลโทเนียนอีกตัวหนึ่งได้ หากตัวคูณหรือเครื่องหมายผิด การตรวจสอบความสัมพันธ์ intertwining (หรือถูกกว่านั้นคือสเปกตรัม) จะจับสิ่งนี้ได้
FlowSetSynthesis ข้างต้นถูกเขียนขึ้นโดยตั้งใจสำหรับการเข้ารหัส นี้ บนโซ่ 1 มิติ มันจับคู่รูปแบบกับป้ายเพาลีเฉพาะที่การเข้ารหัสสร้างขึ้น และแจ้งข้อผิดพลาดกับอย่างอื่น แทนที่จะถอยกลับไปใช้ product formula ทั่วไปอย่างเงียบๆ การ implement ทั่วไปมีสองครึ่ง การอ่านโครงสร้าง flow set จาก groups ของตัวดำเนินการคือสิ่งที่ F2FSynthesisPlugin สำหรับ evolution ทำอยู่แล้ว ส่วนการหา Clifford ที่ทำให้เป็นแนวทแยงจากกลุ่มสเตบิไลเซอร์ ตามที่อธิบายในหัวข้อ IV C ของเอกสารอ้างอิง [1] คือครึ่งที่ยังคงเฉพาะเจาะจงกับการเข้ารหัส
นอกจากนี้ การ delocalize พาริตีทำให้พจน์อันตรกิริยา มีน้ำหนัก 2 แทนที่จะเป็นแนวทแยงใน Qubit เดี่ยว ซึ่งเป็นต้นทุนคู่ตรงข้ามกับพจน์ hopping ที่ถูกลง
ถัดไป: สองมิติ
ทุกอย่างข้างต้นเป็นหนึ่งมิติ และตั้งใจเช่นนั้น บนโซ่ flow set คือทิศทางลูกศรสองแบบ และการเข้ารหัสต้องการ ancilla ตัวเดียว ความง่ายทั้งสองอย่างนี้ไม่คงอยู่ในสองมิติ ซึ่งเป็นที่ที่ต้องการการเข้ารหัสแบบท้องถิ่น
บนแลตทิซระนาบ flow set คือเส้นทางมีทิศทาง (หรือการรวมกันของเส้นทางมีทิศทางที่ไม่มีจุดยอดร่วม) ผ่านกราฟอันตรกิริยา และการหาชุดเล็กๆ ของเส้นทางเช่นนั้นที่ครอบคลุมทุกเส้นเชื่อมกลายเป็นปัญหาเชิงจัดหมู่ในตัวเอง ไม่ใช่การจำแนกสองบรรทัดอีกต่อไป การเข้ารหัสก็เปลี่ยนลักษณะเช่นกัน แทนที่จะใช้ ancilla ตัวเดียวสำหรับทั้งโซ่ พวกมันเพิ่มหนึ่งตัวต่อไซต์หรือเซลล์ของแลตทิซ Verstraete-Cirac จับคู่ทุกไซต์เฟอร์มิออนกับ Qubit ช่วยของมันเอง ได้อัตราส่วน Qubit ต่อโหมดเท่ากับ ขณะที่ Derby-Klassen วางหนึ่งตัวที่ศูนย์กลางของ plaquette คี่แต่ละอัน ได้อัตราส่วน เลย์เอาต์รีจิสเตอร์จึงมีโครงสร้างสองมิติจริงๆ และกลุ่มสเตบิไลเซอร์ที่ต้องฉายลงไปก็ไม่ธรรมดาอีกต่อไป แฮมิลโทเนียนที่เข้ารหัสซื่อตรงเฉพาะบน ปริภูมิย่อย ซึ่งเปลี่ยนทั้งการเตรียมสถานะและสูตรการตรวจสอบจากขั้นตอนที่ 4
ส่วนที่คู่มือนี้สร้างขึ้นคือส่วนที่นำไปใช้ต่อได้: CustomF2QLayout สำหรับรีจิสเตอร์ที่ขนาดต่างจากจำนวนโหมด map_transfer_vertex_generators() สำหรับตัวการเข้ารหัสเอง MapperFnEvolutionSynthesis สำหรับเชื่อมมันเข้ากับ Transpiler และ EvolutionSynthesis แบบกำหนดเองเพื่อให้โครงสร้าง flow set ให้ผลตอบแทน มีเพียงการเข้ารหัสและการแยก flow set เท่านั้นที่ต่างออกไป
คู่มือ flow set 2 มิติ ต่อจากตรงนี้ โดยทำงานผ่านการเข้ารหัส Verstraete-Cirac บนแลตทิซสี่เหลี่ยมจัตุรัส: สี่ flow set, Clifford ความลึก 2 สำหรับแต่ละชุด และการฉายสเตบิไลเซอร์ที่การตรวจสอบต้องใช้ต่อมา
A. Gandon, S. Piccinelli, M. Rossmannek, F. Tacchino, A. Baiardi, J. Nys, and I. Tavernelli, Stabilizer-based quantum simulation of fermion dynamics with local qubit encodings (2026), arXiv:2512.11418v2.