สร้าง Circuit วิวัฒนาการตามเวลาแบบ Krylov (SKQD)
แนวคิดในคู่มือนี้ใช้ได้เฉพาะใน Python API ในปัจจุบัน ฟังก์ชันที่เทียบเท่ากันจะมีใน C API ในรุ่นถัดไป
Sample-based Krylov Quantum Diagonalization (SKQD) เป็นรูปแบบหนึ่งของการทำให้ปริภูมิย่อยเป็นแนวทแยงแบบ quantum-centric แทนที่จะสุ่มตัวอย่างจาก ansatz แบบแปรผันเพียงตัวเดียว (เช่นใน sample-based quantum diagonalization (SQD) แบบธรรมดา) หรือกลุ่มของ Circuit วิวัฒนาการตามเวลาแบบสุ่ม (เช่นใน SqDRIFT) มันสุ่มตัวอย่างฐาน Krylov: ครอบครัวของสถานะ
ที่ได้จากการให้สถานะอ้างอิง วิวัฒน์ตามพหุคูณที่เพิ่มขึ้นของขั้นเวลาคงที่ Bitstring ที่สุ่มได้จาก Circuit ทั้ง ตัวนี้เติมปริภูมิย่อย Krylov ซึ่ง Hamiltonian จะถูกทำให้เป็นแนวทแยงด้วยวิธีคลาสสิกในภายหลัง
คู่มือนี้ทำซ้ำขั้นตอนการสร้าง Circuit ของอัลกอริทึม SKQD สำหรับแบบจำลอง Anderson แบบสิ่งเจือปนเดี่ยว (SIAM) ซึ่งเป็นสิ่งเจือปนแม่เหล็กที่เชื่อมกับแบธที่ไม่มีอันตรกิริยา ตามเอกสารตีพิมพ์ของ SKQD
ขั้นตอนการสุ่มตัวอย่างของ SKQD ใช้ได้ก็ต่อเมื่อสถานะพื้นเป็นแบบ sparse ในฐานเชิงคำนวณ: การทำให้เป็นแนวทแยงแบบคลาสสิกต้องสร้างสถานะพื้นขึ้นใหม่ได้จาก bitstring ที่สุ่มได้ในจำนวนที่จัดการได้ ดังที่แสดงด้านล่าง ความ sparse นั้นไม่ได้เกิดขึ้นเอง แต่เป็นสมบัติของฐานอนุภาคเดี่ยวที่ใช้แสดงปัญหา การเลือกฐานให้ถูกต้องคือหัวใจของการสร้างนี้
1. สร้าง Hamiltonian ของ SIAM เป็นตัวดำเนินการเฟอร์มิออน
แบบจำลอง Anderson แบบสิ่งเจือปนเดี่ยววางออร์บิทัลสิ่งเจือปนที่มีอันตรกิริยาหนึ่งตัว (ดัชนี ) ให้สัมผัสกับแบธที่ไม่มีอันตรกิริยาซึ่งมี ไซต์เรียงเป็นโซ่ Hamiltonian ของมันแยกเป็นส่วนหนึ่งตัว และส่วนสองตัว
โดยส่วนหนึ่งตัวรวมพลังงานบนไซต์ของสิ่งเจือปน (ศักย์เคมี ) การไฮบริไดเซชันระหว่างสิ่งเจือปนกับแบธ และการกระโดดของแบธระหว่างเพื่อนบ้านใกล้สุด
และส่วนสองตัวมีแรงผลักคูลอมบ์บนไซต์ บนสิ่งเจือปนเท่านั้น
คู่มือนี้ทำงานที่จุดสมมาตรอนุภาค-โฮล สองส่วนนี้แมปโดยตรงไปยังอินทิกรัลหนึ่งตัว h1e (การกระโดดของแบธ การไฮบริไดเซชันของสิ่งเจือปน พลังงานบนไซต์ของสิ่งเจือปน) และอินทิกรัลสองตัวเดี่ยว h2e (เทอมคูลอมบ์ของสิ่งเจือปน) ก่อนอื่นประกอบมันในฐานตำแหน่ง ซึ่งเป็นที่ที่แบบจำลองถูกนิยามโดยธรรมชาติ
>>> import numpy as np
>>>
>>> norb = 8
>>> nelec = (norb // 2, norb // 2)  # half filling
>>> hopping, onsite, hybridization = 1.0, 10.0, 1.0
>>> chemical_potential = -0.5 * onsite
>>>
>>> # one-body integrals: bath hopping, impurity hybridization, and impurity on-site energy
>>> h1e = np.zeros((norb, norb))
>>> np.fill_diagonal(h1e[:, 1:], -hopping)
>>> np.fill_diagonal(h1e[1:, :], -hopping)
>>> h1e[0, 1] = h1e[1, 0] = -hybridization
>>> h1e[0, 0] = chemical_potential
>>>
>>> # two-body integrals: on-site Coulomb repulsion on the impurity orbital
>>> h2e = np.zeros((norb,) * 4)
>>> h2e[0, 0, 0, 0] = onsite
2. เปลี่ยนไปใช้ฐานโมเมนตัม
ส่วนแบธของ SIAM เป็นโซ่เฟอร์มิออนอิสระ จึงถูกทำให้เป็นแนวทแยงได้โดยเปลี่ยนไปใช้ฐานโมเมนตัม นี่คือขั้นตอนตัดสินสำหรับ SKQD เพราะแบธมีความไม่แปรเปลี่ยนภายใต้การเลื่อน สถานะพื้นจึงไม่ sparse ในฐานตำแหน่ง แต่ sparse ในฐานโมเมนตัม ซึ่ง Hamiltonian ของแบธเป็นแนวทแยง การหมุนออร์บิทัลอนุภาคเดี่ยวที่ทำการเปลี่ยนนี้เป็นพีชคณิตเชิงเส้นเฉพาะปัญหา มันทำให้เมทริกซ์การกระโดดของแบธเป็นแนวทแยงโดยไม่แตะออร์บิทัลสิ่งเจือปน แล้วย้ายสิ่งเจือปนไปยังไซต์กลาง:
>>> def momentum_basis(norb):
...     """Orbital rotation from the position to the momentum basis."""
...     n_bath = norb - 1
...     hopping_matrix = np.zeros((n_bath, n_bath))
...     np.fill_diagonal(hopping_matrix[:, 1:], -1)
...     np.fill_diagonal(hopping_matrix[1:, :], -1)
...     _, vecs = np.linalg.eigh(hopping_matrix)
...     orbital_rotation = np.zeros((norb, norb))
...     orbital_rotation[0, 0] = 1.0
...     orbital_rotation[1:, 1:] = vecs
...     new_index = n_bath // 2
...     perm = np.r_[1:(new_index + 1), 0, (new_index + 1):norb]
...     return orbital_rotation[:, perm]
...
>>> orbital_rotation = momentum_basis(norb)
ต่างจาก workflow แบบแปรผัน ที่นี่หมุนอินทิกรัลของ Hamiltonian ไปยังฐานโมเมนตัม เพื่อให้ Circuit ทั้งหมด (ทั้ง Hamiltonian และสถานะ) อยู่ในฐานที่สถานะพื้นเป็น sparse และ bitstring ที่สุ่มได้จึงให้ข้อมูล การหมุนอินทิกรัลหนึ่งตัวและสองตัวเป็นการเปลี่ยนฐานมาตรฐานของเทนเซอร์โครงสร้างอิเล็กทรอนิกส์:
>>> rotation = orbital_rotation.T.conj()
>>> h1e_momentum = np.einsum("ab,Aa,Bb->AB", h1e, rotation, rotation.conj(), optimize="greedy")
>>> h2e_momentum = np.einsum(
...     "abcd,Aa,Bb,Cc,Dd->ABCD",
...     h2e,
...     rotation,
...     rotation.conj(),
...     rotation,
...     rotation.conj(),
...     optimize="greedy",
... )
เนื่องจากการหมุนทำให้ออร์บิทัลสิ่งเจือปนคงที่ (กระทำเฉพาะกับแบธ) อันตรกิริยาบนไซต์จึงไม่เปลี่ยน h2e_momentum ยังคงเป็นเทอมจำนวน-จำนวนเดียว เช่นเดียวกับ h2e สิ่งเดียวที่เปลี่ยนคือสิ่งเจือปนถูกย้ายไปที่ดัชนีกลาง เห็นได้โดยตรงจากเทนเซอร์อินทิกรัล ซึ่งแต่ละตัวมีสมาชิกที่ไม่เป็นศูนย์หนึ่งตัว:
>>> print(f"h2e nonzero at:          {np.argwhere(np.abs(h2e) > 1e-12).tolist()}")
h2e nonzero at:          [[0, 0, 0, 0]]
>>> print(f"h2e_momentum nonzero at: {np.argwhere(np.abs(h2e_momentum) > 1e-12).tolist()}")
h2e_momentum nonzero at: [[3, 3, 3, 3]]
ความเป็นเฉพาะที่นี้เองที่ทำให้อันตรกิริยาสังเคราะห์ได้ถูกในภายหลัง
ประกอบอินทิกรัลหนึ่งตัวเป็น FermionOperator ด้วยตัวสร้างอินทิกรัลอิเล็กทรอนิกส์ from_1body_tril_spin_sym() ซึ่งคาดหวังให้อินทิกรัลถูกอัดในลำดับสามเหลี่ยมล่าง ส่วนสองตัวเป็นเทอมจำนวน-จำนวนเดียว ดังนั้นแทนที่จะส่งผ่านกลไกอินทิกรัลสองตัว ให้สร้างมันโดยตรงด้วย cre()/ann(): ตัวดำเนินการคูลอมบ์บนไซต์ สำหรับโหมดสิ่งเจือปน (โหมด ของมันอยู่ที่ดัชนี p โหมด ของมันอยู่ที่ดัชนี p + norb ในเลย์เอาต์สปินแบบบล็อก) ตัวสร้างทั้งสองทำสปินคู่ให้ออร์บิทัลเชิงพื้นที่ norb ตัวเป็นโหมดเฟอร์มิออน 2 * norb โหมด
เก็บส่วนหนึ่งตัว และส่วนสองตัว ไว้เป็นตัวดำเนินการแยกกัน แทนที่จะรวมกันทันที ให้ตรงกับเทอม และ ของสมการในส่วนที่ 1 การสร้างแต่ละชิ้นเพียงครั้งเดียว (ในทั้งสองฐาน) ทำให้นำกลับมาใช้ด้านล่างได้ เมื่อรวมกันจะได้ Hamiltonian เต็มสำหรับการทำเป็นแนวทแยงแบบแม่นตรงในฐานใดก็ได้ ส่วนเดี่ยว ๆ (ฐานโมเมนตัม) คือตัวดำเนินการที่ขั้น Trotter วิวัฒน์ในขั้นตอนที่ 4
>>> from qiskit_fermions.operators import FermionOperator, ann, cre
>>>
>>> # U n_imp_up n_imp_down: the impurity's up/down modes sit at `imp` and `imp + norb` in the
>>> # block-spin layout (the impurity is orbital 0 in the position basis, orbital 3 in the
>>> # momentum basis -- the single relocated index found above)
>>> imp_pos, imp_mom = 0, 3
>>>
>>> one_body_position = FermionOperator.from_1body_tril_spin_sym(
...     h1e[np.tril_indices(norb)], norb
... )
>>> two_body_position = FermionOperator.from_dict(
...     {(cre(imp_pos), ann(imp_pos), cre(imp_pos + norb), ann(imp_pos + norb)): onsite}
... )
>>> one_body_momentum = FermionOperator.from_1body_tril_spin_sym(
...     h1e_momentum[np.tril_indices(norb)], norb
... )
>>> two_body_momentum = FermionOperator.from_dict(
...     {(cre(imp_mom), ann(imp_mom), cre(imp_mom + norb), ann(imp_mom + norb)): onsite}
... )
>>>
>>> hamiltonian_position = (
...     (one_body_position + two_body_position).normal_ordered().simplify(atol=1e-14)
... )
>>> hamiltonian_momentum = (
...     (one_body_momentum + two_body_momentum).normal_ordered().simplify(atol=1e-14)
... )
การเปลี่ยนฐานเป็นการแปลงคล้ายแบบยูนิทารี จึงไม่เปลี่ยนสเปกตรัม ยืนยันว่าตัวดำเนินการถูกต้องโดยเปรียบเทียบค่าไอเกนต่ำสุดในเซกเตอร์ กับการทำเป็นแนวทแยงแบบแม่นตรง FermionOperator เปิดเผย LinearOperator ของ SciPy (หนุนด้วยเคอร์เนลคูณเมทริกซ์-เวกเตอร์ full configuration interaction (FCI) แบบเนทีฟ) จึงส่งต่อให้ scipy.sparse.linalg.eigsh() ได้โดยตรง
>>> import ffsim
>>> import scipy.sparse.linalg
>>>
>>> linop = ffsim.linear_operator(hamiltonian_momentum, norb, nelec)
>>> reference_energy, ground_state = scipy.sparse.linalg.eigsh(linop, k=1, which="SA")
>>> reference_energy = reference_energy[0]
>>> ground_state = ground_state[:, 0]
>>> print(f"exact ground-state energy: {reference_energy:.6f}")
exact ground-state energy: -13.422492
ผลตอบแทนของการเปลี่ยนฐานคือความ sparse เพื่อให้เห็นภาพชัด ให้นับว่าต้องใช้ดีเทอร์มิแนนต์ในฐานเชิงคำนวณกี่ตัวจึงจะครอบคลุมน้ำหนักสถานะพื้น 99% และเปรียบเทียบฐานโมเมนตัมกับฐานตำแหน่ง พลังงานไม่ขึ้นกับฐาน แต่จำนวนดีเทอร์มิแนนต์ขึ้น:
>>> def determinants_for(vec, fraction=0.99):
...     weights = np.sort(np.abs(vec) ** 2)[::-1]
...     return int(np.searchsorted(np.cumsum(weights), fraction) + 1)
...
>>> # the same Hamiltonian in the position basis has an identical spectrum, but a dense ground state
>>> position_linop = ffsim.linear_operator(hamiltonian_position, norb, nelec)
>>> position_energy, position_ground = scipy.sparse.linalg.eigsh(position_linop, k=1, which="SA")
>>>
>>> print(f"position-basis energy: {position_energy[0]:.6f}")
position-basis energy: -13.422492
>>> print(f"determinants for 99% weight: {determinants_for(position_ground[:, 0])} (position)")
determinants for 99% weight: 2563 (position)
>>> print(f"determinants for 99% weight: {determinants_for(ground_state)} (momentum)")
determinants for 99% weight: 21 (momentum)
ตัวดำเนินการทั้งสองมีพลังงานเท่ากัน แต่สถานะพื้นในฐานตำแหน่งกระจายอยู่บนดีเทอร์มิแนนต์หลายพันตัว ขณะที่ฐานโมเมนตัมรวมมันไว้ที่ประมาณ 20 ตัว นี่คือเหตุผลที่การสุ่มตัวอย่าง SKQD ใช้ได้ในฐานโมเมนตัมแต่ไม่ใช่ฐานตำแหน่ง
3. เตรียมสถานะอ้างอิง
สถานะอ้างอิงของ SKQD คือการซ้อนทับของการกระตุ้นทั้งหมดของอิเล็กตรอนที่อยู่ใกล้ระดับแฟร์มีที่สุดไปยังโหมดโมเมนตัมว่างที่ใกล้ที่สุด เอกสารตีพิมพ์ของ SKQD สร้างมันด้วยเครือข่ายของ XXPlusYYGate ที่เขียนด้วยมือ มันดูมีสหสัมพันธ์สูง (มีแอมพลิจูดในฐานเชิงคำนวณที่ไม่เป็นศูนย์หลายร้อยตัว) แต่เครือข่ายของการหมุนสองโหมดที่คงจำนวนเป็นการดำเนินการอนุภาคเดี่ยว (เฟอร์มิออนแบบเกาส์เซียน) ดังนั้นสถานะที่มันสร้างจึงเป็น Slater determinant เดี่ยว นั่นหมายความว่าคุณเตรียมมันได้ด้วย Gate PrepareSlaterDeterminant ตัวเดียว เมื่อกำหนดการหมุนอนุภาคเดี่ยวที่เครือข่ายนั้น implement
เนื่องจาก XXPlusYYGate แต่ละตัวทำหน้าที่เป็นการหมุน Givens บนคู่โหมด การหมุนนั้นจึงสร้างได้โดยตรงในภาพอนุภาคเดี่ยว (เมทริกซ์ Givens หนึ่งตัวต่อหนึ่ง Gate) แทนที่จะใส่ Gate สองคิวบิตด้วยมือ Gate ก่อตัวเป็นลายอิฐของการหมุนระหว่างเพื่อนบ้านที่แผ่ออกจากระดับแฟร์มีเป็นชั้นที่ขยายตัว กระจายอิเล็กตรอนใกล้ระดับแฟร์มีแต่ละตัวไปยังโหมดว่างที่อยู่เหนือมันขึ้นไป:
>>> def fermi_level_rotation(norb, nocc, n_excited=3):
...     """Orbital rotation exciting the near-Fermi electrons into the nearest empty modes."""
...     cos, sin = np.cos(np.pi / 4), np.sin(np.pi / 4)
...     fermi = nocc - 1  # highest occupied mode; the Fermi level sits between it and mode `nocc`
...     # Nearest-neighbor Givens rotations fanning out from the Fermi level in expanding layers:
...     # layer `depth` couples the mode `depth` steps below the level to the one above it, mixing
...     # the `n_excited` highest-occupied modes with the empty modes just above them. A final
...     # rotation carries amplitude up into the topmost empty mode of the window.
...     network = [
...         (lower, lower + 1)
...         for depth in range(n_excited)
...         for lower in range(fermi - depth, fermi + depth + 1, 2)
...     ]
...     network.append((fermi + n_excited, fermi + n_excited + 1))
...     unitary = np.eye(norb, dtype=complex)
...     for i, j in network:
...         givens = np.eye(norb, dtype=complex)
...         givens[i, i] = givens[j, j] = cos
...         givens[i, j], givens[j, i] = sin, -sin
...         unitary = givens @ unitary
...     return unitary
...
>>> reference_rotation = fermi_level_rotation(norb, nelec[0])
การหมุนข้างต้นแสดงในฐานโมเมนตัม ให้ตรงกับ Hamiltonian อิเล็กตรอนใกล้ระดับแฟร์มีคือโหมดโมเมนตัมที่ถูกครอบครองที่มีพลังงานสูงสุด และเครือข่ายกระตุ้นมันไปยังโหมดว่างที่มีพลังงานต่ำสุด นี่คือเหตุผลที่ต้องสร้างสถานะอ้างอิงหลังการเปลี่ยนฐานของขั้นตอนก่อนหน้า ไม่ใช่ก่อน
การเตรียม Slater determinant ทำแยกตามเซกเตอร์สปิน เพราะแต่ละเซกเตอร์มีรูปร่าง (อิเล็กตรอน, ออร์บิทัล) ของตัวเอง Gate PrepareSlaterDeterminant ตัวเดียว (การครอบครอง โดยเติมโหมด nocc ต่ำสุด ร่วมกับการหมุนอนุภาคเดี่ยว) เตรียมหนึ่งเซกเตอร์ Gate เดียวกันถูกใช้หนึ่งครั้งบนโหมดอัลฟา 0..norb และหนึ่งครั้งบนโหมดเบตา norb..2*norb เพราะทั้งสองเซกเตอร์สปินใช้การครอบครองและการหมุนอ้างอิงเดียวกันที่นี่:
>>> from qiskit_fermions.circuit.library import PrepareSlaterDeterminant
>>>
>>> occupation = [i < nelec[0] for i in range(norb)]
>>> reference_preparation = PrepareSlaterDeterminant(occupation, reference_rotation)
Gate แบบประกาศนี้มาแทนเครือข่าย XXPlusYYGate ที่เขียนด้วยมือ โดย Transpiler สร้างการสังเคราะห์การหมุน Givens ให้
4. ประกอบ Circuit แบบ Krylov
แต่ละ Circuit แบบ Krylov คือการเตรียมสถานะอ้างอิงตามด้วยวิวัฒนาการภายใต้ แยก Hamiltonian เป็นส่วนหนึ่งตัวและสองตัว แล้วทำ Trotter ให้วิวัฒนาการตามการแยกนั้น นี่คือการเลือกที่ตัดสินความลึกของ Circuit วิวัฒนาการหนึ่งตัว เป็นการดำเนินการเฟอร์มิออนอิสระ (เฟอร์มิออนแบบเกาส์เซียน) จึงเป็นการหมุนฐานอนุภาคเดี่ยว (OrbitalRotation ด้วยยูนิทารี ) แทนที่จะต้อง Trotter แบบ Pauli ทีละเทอม วิวัฒนาการสองตัว กระทำเฉพาะกับเทอมอันตรกิริยาบนไซต์เดียว การสร้างขั้นด้วยวิธีนี้ทำให้ Transpiler ปล่อยลายอิฐตื้น ๆ ของการหมุน Givens บวก Gate อันตรกิริยาสองคิวบิตหนึ่งตัว ซึ่งเป็นโครงสร้างตื้นที่เอกสารตีพิมพ์ของ SKQD สร้างด้วยมือ
เรามีส่วนสองตัวอยู่แล้ว มันคือตัวดำเนินการ two_body_momentum ที่สร้างในขั้นตอนที่ 2 (เทอมบนไซต์เดียว) วิวัฒนาการหนึ่งตัว ไม่ขึ้นกับสปิน จึงเป็น OrbitalRotation ต่อเซกเตอร์หนึ่งตัวด้วยยูนิทารี ที่ใช้หนึ่งครั้งกับแต่ละเซกเตอร์สปิน โครงสร้างขนานเดียวกับการเตรียมสถานะอ้างอิง
แต่ละ Circuit แบบ Krylov วิวัฒน์เป็นเวลารวม ซึ่งทำได้ด้วยผลคูณ Trotter อันดับสองของ ขั้นขนาด เพื่อให้ความคลาดเคลื่อนต่อขั้นคงที่เมื่อมิติ Krylov เพิ่มขึ้น แต่ละขั้นคั่นการหมุนหนึ่งตัวเต็มรูป (หนึ่งต่อเซกเตอร์สปิน) ไว้ระหว่างครึ่งขั้นสองครั้งของวิวัฒนาการสองตัว (ราคาถูก เทอมเดียว) มิติ Krylov คือจำนวน Circuit เช่นนี้ โดย dim มีค่าตั้งแต่ 0 (สถานะอ้างอิงเท่านั้น) ถึง
>>> import scipy.linalg
>>>
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import Evolution, OrbitalRotation
>>>
>>> num_modes = 2 * norb
>>> time_step = 0.2
>>>
>>> half_exp_h2 = Evolution(num_modes, two_body_momentum, time_step / 2)
>>> full_exp_h1 = OrbitalRotation(scipy.linalg.expm(-1j * time_step * h1e_momentum))
>>>
>>> def krylov_circuit(dim):
...     # closes over the fermionic gates defined in the outer scope:
...     # `reference_preparation`, `half_exp_h2` and `full_exp_h1`
...     circuit = FermionicCircuit(num_modes)
...     circuit.append(reference_preparation, range(norb))
...     circuit.append(reference_preparation, range(norb, num_modes))
...     for _ in range(dim):  # second-order Trotter product of `dim` steps
...         circuit.append(half_exp_h2, circuit.modes)
...         circuit.append(full_exp_h1, range(norb))
...         circuit.append(full_exp_h1, range(norb, num_modes))
...         circuit.append(half_exp_h2, circuit.modes)
...     return circuit
Circuit ที่สร้างที่นี่ยังไม่มีการวัด เพราะ Circuit เฟอร์มิออนชุดเดียวกันนี้ยังขับการจำลองแบบแม่นตรงในขั้นตอนที่ 6 ด้วย และการวัดไม่ใช่การดำเนินการยูนิทารี ขั้นตอนที่ 5 เพิ่มมันด้วย FermionicCircuit.measure_all() ซึ่งอ่านโหมด i ลงในบิตคลาสสิก i
ควรวัด Circuit เฟอร์มิออน มากกว่า Circuit ที่ transpile แล้ว การวัดแบบเฟอร์มิออนระบุชื่อโหมดที่มันอ่าน ดังนั้น layout และ routing จึงพามันไปกับ Qubit ที่โหมดนั้นไปอยู่ และ bitstring ที่สุ่มได้ถูกจัดดัชนีตามโหมด หากวัด Circuit ที่ transpile แล้วแทน คุณต้องยกเลิก final_index_layout() เอง และจะได้ผลลัพธ์ที่สลับลำดับโดยไม่แจ้งเตือนหากลืม วิธีนี้อาศัยการเข้ารหัส Jordan-Wigner แบบฐานการครอบครองที่ preset ใช้ ซึ่งแต่ละโหมดถูกแบกโดย Qubit หนึ่งตัว
5. Transpile ไปเป็น Circuit ของ Qubit
การ transpile FermionicCircuit แมป Gate เฟอร์มิออนของมันไปเป็น Gate ของ Qubit ซึ่งใช้การแมป Jordan-Wigner jordan_wigner() Gate OrbitalRotation สังเคราะห์เป็นลายอิฐของการหมุน Givens และ Evolution เทอมเดียวลดรูปเป็น Gate อันตรกิริยาสองคิวบิตหนึ่งตัว
เนื่องจาก Gate เฟอร์มิออนทุกตัวที่นี่มีการสังเคราะห์เริ่มต้น คุณจึงใช้ generate_preset_jw_pass_manager() ที่สำเร็จรูปได้โดยตรง แทนที่จะประกอบแต่ละขั้นด้วยมือ อาร์กิวเมนต์แบบคีย์เวิร์ดใด ๆ จะถูกส่งต่อไปยังขั้น Qubit ส่ง optimization_level=0 เพื่อให้ภาพที่ตรงไปตรงมาและไม่ปรับแต่งของความลึกที่สังเคราะห์ได้ การสร้างครอบครัว Circuit แบบ Krylov ทั้งหมดจึงเป็นลูปบนมิติ Krylov เก็บ FermionicCircuit ที่ยังไม่ transpile ไว้ข้างกับ Circuit ของ Qubit ที่ transpile แล้ว ตัวเฟอร์มิออนขับการจำลองแบบแม่นตรง (statevector) ในขั้นตอนที่ 6 จึงต้องไม่มีการวัด measure_all(inplace=False) คืนสำเนาที่มีการวัดเพื่อ transpile และปล่อยต้นฉบับไว้ไม่ถูกแตะ และสำเนานั้นคือสิ่งที่ Backend จะรัน
>>> from qiskit_fermions.transpiler.presets import generate_preset_jw_pass_manager
>>>
>>> pass_manager = generate_preset_jw_pass_manager(optimization_level=0)
>>>
>>> def krylov_circuits(krylov_dim):
...     fermionic_circuits, circuits = [], []
...     for dim in range(krylov_dim):
...         fermionic_circuit = krylov_circuit(dim)
...         fermionic_circuits.append(fermionic_circuit)
...         measured = fermionic_circuit.measure_all(inplace=False)
...         circuits.append(pass_manager.run(measured))
...     return fermionic_circuits, circuits
...
>>> krylov_dim = 5
>>> fermionic_circuits, circuits = krylov_circuits(krylov_dim)
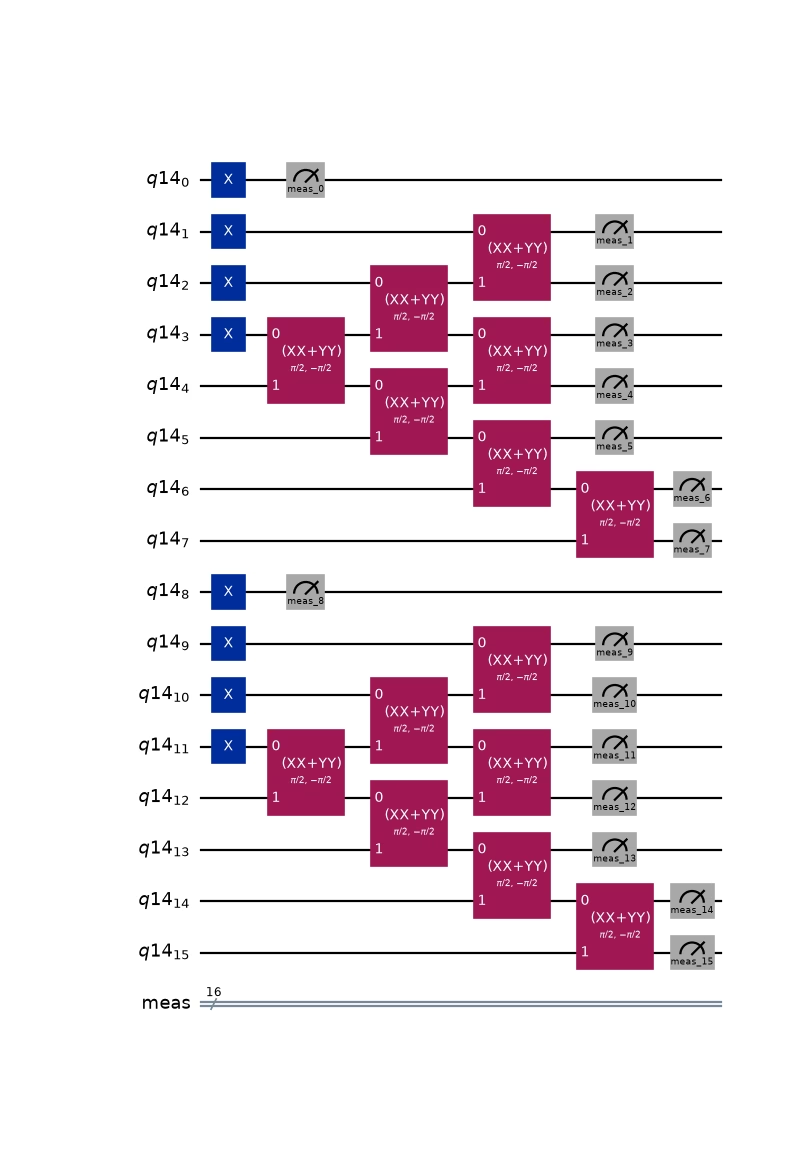
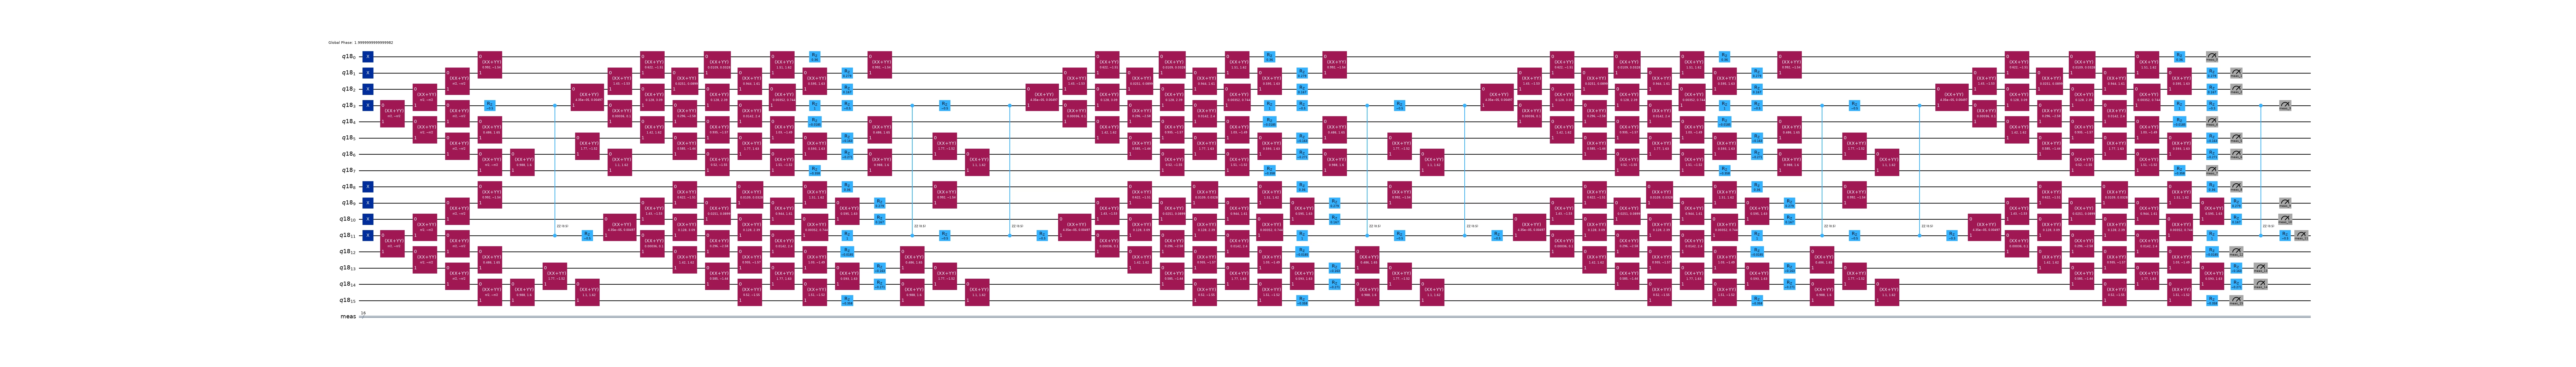
มิติ Krylov ปรากฏโดยตรงในความลึกสองคิวบิตของ Circuit การเตรียมสถานะอ้างอิงเป็นต้นทุนคงที่ และกำลังของ Krylov ที่เพิ่มขึ้นแต่ละระดับเพิ่มขั้น Trotter อันดับสองของตัวดำเนินการวิวัฒนาการตามเวลาอีกหนึ่งขั้น
>>> two_qubit = lambda instr: instr.operation.num_qubits == 2
>>> [circuit.depth(two_qubit) for circuit in circuits]
[4, 12, 21, 30, 39]
การแยก Hamiltonian ทำให้ความลึกเหล่านี้อยู่ในระดับปานกลาง วิวัฒนาการหนึ่งตัวเป็นการหมุนออร์บิทัลจริง จึงสังเคราะห์เป็นลายอิฐของ XXPlusYYGate บน Qubit ที่อยู่ติดกัน แต่ละครึ่งขั้นของอันตรกิริยาบนไซต์เป็น RZZGate ตัวเดียวที่เชื่อมสองโหมดสปินของสิ่งเจือปน เป็นเทอมราคาถูกที่ผลคูณอันดับสองคั่นไว้รอบการหมุน การส่ง Hamiltonian ทั้งหมดให้ Gate Evolution ตัวเดียวแทนจะ Trotter แบบ Pauli ส่วนหนึ่งตัวทีละเทอม แพร่สายอักขระ Z แบบ Jordan-Wigner ที่ยาวข้ามการคัปปลิงสิ่งเจือปน-แบธ (ระยะไกล) และทำให้ความลึกพองขึ้นหนึ่งระดับขนาด
Circuit แรกเตรียมเฉพาะดีเทอร์มิแนนต์อ้างอิง ส่วน Circuit สุดท้ายมีขั้น Trotter มากที่สุด (สี่ขั้นในกรณีนี้):
>>> circuits[0].draw("mpl", fold=-1, measure_arrows=False)
<Figure size ... with 1 Axes>
>>> circuits[-1].draw("mpl", fold=-1, measure_arrows=False)
<Figure size ... with 1 Axes>
6. สุ่มตัวอย่าง bitstring จาก Circuit แบบ Krylov
บนฮาร์ดแวร์ คุณจะรัน Circuit ที่ transpile แล้วและวัดผล นี่คือเวอร์ชันไร้สัญญาณรบกวน (statevector) ของขั้นตอนนั้น แสดง bitstring ที่ SKQD จะรวบรวม จำลอง FermionicCircuit ที่ยังไม่ transpile แต่ละตัวด้วย ffsim.apply_unitary() และสุ่มตัวอย่างสถานะเวกเตอร์ที่ได้ด้วย ffsim.sample_state_vector()
Gate PrepareSlaterDeterminant ทำงานแบบตรวจสอบแล้วหมุนภายใต้การจำลอง (ตรวจว่าสถานะขาเข้าครอบครองดีเทอร์มิแนนต์อ้างอิงของมัน แล้วจึงใช้การหมุน) ดังนั้นอินพุตจึงเป็นดีเทอร์มิแนนต์การครอบครองธรรมดา: โหมด nocc ต่ำสุดถูกเติมต่อสปิน โดยไม่มีการหมุน Gate ใช้ reference_rotation เอง
>>> from collections import Counter
>>>
>>> reference = ffsim.slater_determinant(
...     norb, (list(range(nelec[0])), list(range(nelec[1])))
... )
>>>
>>> shots = 1000
>>> counts = Counter()
>>> for dim, fermionic_circuit in enumerate(fermionic_circuits):
...     statevector = ffsim.apply_unitary(reference, fermionic_circuit, norb=norb, nelec=nelec)
...     samples = ffsim.sample_state_vector(
...         statevector, norb=norb, nelec=nelec, shots=shots, seed=dim
...     )
...     counts += Counter(samples)
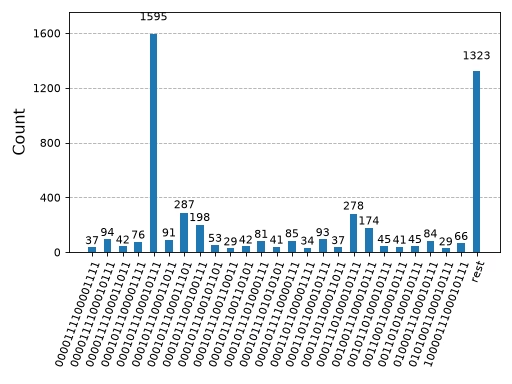
เมื่อรวมตัวอย่างจาก Circuit แบบ Krylov ทั้งห้าตัว ขอบเขตรองรับเล็กมาก: bitstring ที่แตกต่างกันไม่กี่ร้อยตัวจากดีเทอร์มิแนนต์ ตัวในเซกเตอร์ (4, 4) ความกระจุกตัวนี้ ซึ่งเป็นผลโดยตรงของความ sparse ในฐานโมเมนตัมที่ยืนยันในขั้นตอนที่ 2 ทำให้การทำเป็นแนวทแยงแบบคลาสสิกในภายหลังทำได้จริง
การพล็อตค่านับด้วย qiskit.visualization.plot_histogram() ทำให้เห็นความเบาบางได้ชัดเจน คอนฟิกูเรชันไม่กี่แบบมีสัดส่วนสูงสุด โดยมีดีเทอร์มิแนนต์อ้างอิงเป็นอันดับหนึ่ง
>>> from qiskit.visualization import plot_histogram
>>>
>>> plot_histogram(dict(counts), number_to_keep=25)
<Figure size ... with 1 Axes>
7. ทำ Diagonalize ในสเปซย่อยที่สุ่มได้
บิตสตริงที่สุ่มได้คืออินพุตของส่วนคลาสสิกของ SKQD โดย Hamiltonian จะถูกโปรเจกต์ลงบนสเปซย่อยที่คอนฟิกูเรชันที่สุ่มได้แผ่ขึ้นมา แล้วทำ diagonalize ในสเปซนั้น ขั้นตอนนี้ส่งต่อให้แพ็กเกจ qiskit-addon-sqd ซึ่ง diagonalize_fermionic_hamiltonian() จะรันลูป sample-based quantum diagonalization ทั้งหมด โดยสร้างสเปซย่อยจากแบตช์ของคอนฟิกูเรชันที่สุ่มได้ ทำ diagonalize Hamiltonian ในสเปซนั้น และปรับปรุงสเปซย่อยซ้ำ ๆ ด้วยการกู้คืนคอนฟิกูเรชัน (configuration recovery) คือการพลิกค่า occupation เพื่อซ่อมคอนฟิกูเรชันที่ละเมิดสมมาตรของจำนวนอนุภาคที่ทราบ การกู้คืนคอนฟิกูเรชันออกแบบมาเพื่อแก้ความเสียหายจากสัญญาณรบกวนของฮาร์ดแวร์ ซึ่งทำให้บิตสตริงที่สุ่มได้ตกไปอยู่ในเซกเตอร์จำนวนอนุภาคที่ผิด แต่การสุ่มในที่นี้ไม่มีสัญญาณรบกวน จึงไม่มีอะไรต้องซ่อมในส่วนนั้น
ตัวแก้ใช้ค่านับที่สุ่มได้ในรูปแบบ BitArray ซึ่งสร้างโดยตรงจาก counts ที่รวมไว้ในขั้นตอนที่ 6 ให้ระบุ num_bits อย่างชัดเจน เพราะถ้าไม่ระบุ ความกว้างจะถูกอนุมานจากบิตสตริงที่กว้างที่สุดที่สุ่มได้ ซึ่งจะแคบกว่า 2 * norb เมื่อไม่มีตัวอย่างใดที่ครอบครองโหมดสุดท้าย และตัวแก้จะปฏิเสธอาร์เรย์นั้น ตัวแก้ทำ diagonalize ในฐานโมเมนตัมเดียวกับที่ส่วนอื่นของการสร้างใช้ จึงรับอินทิกรัล h1e_momentum และ h2e_momentum จากขั้นตอนที่ 2 ได้โดยตรง โดยไม่ต้องจัดเรียงใหม่ พลังงานที่กู้คืนได้ตรงกับค่าอ้างอิงที่แม่นตรงด้วยความคลาดเคลื่อนต่ำกว่าหนึ่งมิลลิฮาร์ทรีมาก จากคอนฟิกูเรชันที่สุ่มได้เพียงไม่กี่ร้อยแบบ เนื่องจากพลังงาน SQD เป็นขอบเขตบนแบบ variational ของสถานะพื้นฐานจริง ค่านี้จึงอยู่ที่หรือสูงกว่า reference_energy เสมอ (ยังคงอยู่ในขอบเขตจากขั้นตอนที่ 2):
>>> from qiskit.primitives import BitArray
>>> from qiskit_addon_sqd.fermion import diagonalize_fermionic_hamiltonian
>>>
>>> bit_array = BitArray.from_counts(dict(counts), num_bits=2 * norb)
>>>
>>> # record each iteration's batch results so we can watch the energy converge
>>> result_history = []
>>> result = diagonalize_fermionic_hamiltonian(
...     h1e_momentum,
...     h2e_momentum,
...     bit_array,
...     samples_per_batch=100,
...     norb=norb,
...     nelec=nelec,
...     num_batches=3,
...     max_iterations=3,
...     symmetrize_spin=True,
...     callback=result_history.append,
...     seed=np.random.default_rng(24),
... )
>>> print(f"SQD estimate: {result.energy:.4f} (exact: {reference_energy:.4f})")
SQD estimate: -13.4224 (exact: -13.4225)
แสดงผลการรันเป็นภาพ ได้แก่การลู่เข้าของพลังงานตลอดรอบการวนซ้ำ และ occupancy เฉลี่ยของออร์บิทัลเชิงพื้นที่แต่ละตัวในสถานะพื้นฐานที่กู้คืนได้ พลังงานต่อรอบคือค่าต่ำสุดในบรรดาแบตช์ของรอบนั้น และ occupancy คือผลรวมของ orbital_occupancies ในสองเซกเตอร์สปิน แม้ไม่มีสัญญาณรบกวนให้แก้ พลังงานก็ยังลดลงในแต่ละรอบ แต่ละรอบทำ diagonalize ภายใน num_batches แบตช์ ที่มีคอนฟิกูเรชันเพียง samples_per_batch แบบที่สุ่มย่อยจากพูล และการปรับปรุงซ้ำจากการส่งต่อบิตสตริง (bitstring carryover) ช่วยให้คอนฟิกูเรชันที่ตกอยู่ในแบตช์เหล่านั้นดีขึ้นเรื่อย ๆ พลังงานที่กู้คืนได้จึงดีขึ้น:
>>> import matplotlib.pyplot as plt
>>> from matplotlib.ticker import MaxNLocator
>>>
>>> min_energies = [min(batch, key=lambda r: r.energy).energy for batch in result_history]
>>> occupancies = np.sum(result.orbital_occupancies, axis=0)
>>>
>>> fig, axs = plt.subplots(1, 2, figsize=(12, 5))
>>> _ = axs[0].plot(range(len(min_energies)), min_energies, marker="o", label="SQD energy")
>>> _ = axs[0].axhline(reference_energy, color="gray", linestyle="--", label="exact energy")
>>> _ = axs[0].set_xlabel("iteration")
>>> _ = axs[0].set_ylabel("energy")
>>> _ = axs[0].set_title("Energy vs SQD iteration")
>>> _ = axs[0].xaxis.set_major_locator(MaxNLocator(integer=True))
>>> _ = axs[0].legend()
>>> _ = axs[1].bar(range(norb), occupancies)
>>> _ = axs[1].set_xlabel("spatial orbital")
>>> _ = axs[1].set_ylabel("average occupancy")
>>> _ = axs[1].set_title("Occupancy per spatial orbital")
>>> fig
<Figure size ... with 2 Axes>
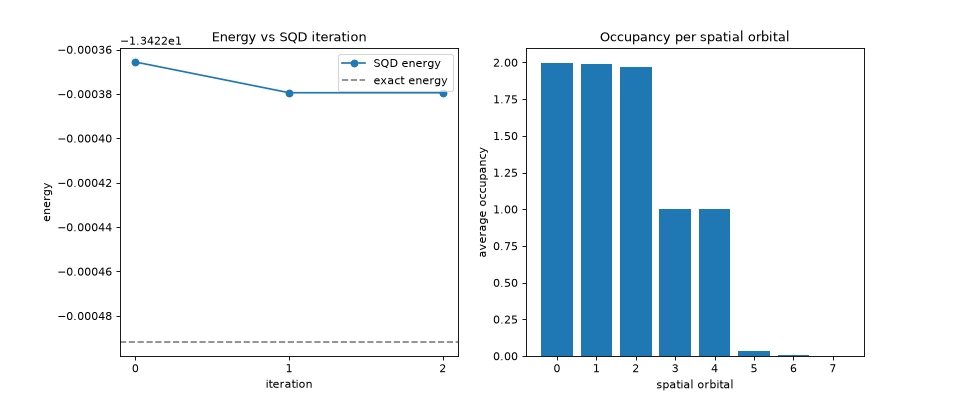
นี่คือการปิดลูป SKQD วงจรฐานโมเมนตัมของขั้นตอนที่ 1–5 สร้างตัวอย่างที่เบาบาง (ขั้นตอนที่ 6) และการทำ diagonalize แบบอิงตัวอย่างข้างต้นแปลงตัวอย่างนั้นกลับเป็นพลังงานสถานะพื้นฐาน
ขั้นตอนถัดไป
คู่มือนี้รันไปป์ไลน์ SKQD ทั้งหมดบนตัวจำลอง statevector ที่ไม่มีสัญญาณรบกวน บนฮาร์ดแวร์จริง circuits ที่ทรานสไพล์แล้วจะถูกรันและวัดผลแทนการสุ่ม statevector ในขั้นตอนที่ 6 โดยค่านับที่ได้จะป้อนเข้าสู่การทำ diagonalize ในขั้นตอนที่ 7 ได้เหมือนเดิม ดูเอกสารประกอบ Qiskit เพื่อขอความช่วยเหลือเกี่ยวกับการรันวงจร และดูบทช่วยสอน SQD addon สำหรับข้อมูลเกี่ยวกับการประมวลผลหลังการทำ diagonalize ในสเปซย่อย รวมถึงพฤติกรรมกับตัวอย่างที่มีสัญญาณรบกวน ซึ่งเป็นกรณีที่การกู้คืนคอนฟิกูเรชันทำงานหนักที่สุด
อ่านคู่มือความสัมพันธ์ของ ffsim เพื่อทำความเข้าใจว่าทำไม ffsim.apply_unitary() และ ffsim.sample_state_vector() จึงทำงานได้โดยตรงกับวงจรเฟอร์มิออนของแพ็กเกจนี้ และทำไมเซกเตอร์จำนวนอนุภาคคงที่ที่ใช้ในขั้นตอนที่ 6 จึงทำให้ความเบาบางของฐานโมเมนตัมที่แสดงในขั้นตอนที่ 2 สุ่มได้อย่างมีประสิทธิภาพ