Error mitigation
บทเรียนนี้ให้ความรู้พื้นฐานเกี่ยวกับเทคนิค error mitigation ต่างๆ เพื่อช่วยให้ผู้ใช้สร้างความเข้าใจเชิงสัญชาตญาณว่าควรใช้เมื่อไรและอย่างไรจึงดีที่สุด ที่สำคัญคือ การใช้งานเทคนิคเหล่านี้ในยุคปัจจุบันจะใช้เครื่องมือที่ซับซ้อนกว่า เช่น Samplomatic, Shaded Lightcones และ Executor ซึ่ง workflow เหล่านั้นจะอยู่ในบทเรียนถัดไป
วิดีโอนี้ให้ภาพรวมของเทคนิค error mitigation ส่วนข้อความด้านล่างเพิ่มรายละเอียดและสำรวจวิธีเหล่านี้โดยใช้ Qiskit
ภาพรวมของเทคนิค error mitigation
Error mitigation หมายถึงกระบวนการใดๆ ที่พยายามลดผลกระทบของข้อผิดพลาดในการคำนวณเชิงควอนตัมหลังจากที่มันเกิดขึ้นแล้ว ซึ่งต่างจาก suppression ที่พยายามป้องกันไม่ให้เกิดข้อผิดพลาด และต่างจาก error correction ที่เข้ารหัสข้อมูลข้าม qubit กายภาพจำนวนมากแล้วตรวจสอบความสอดคล้องของข้อมูลนั้นเพื่อรักษาข้อมูลใน qubit ตรรกะตัวเดียว ตลอดบทเรียนนี้ เทคนิค error mitigation เข้าใจได้ดีที่สุดในฐานะวิธีสร้างตัวประมาณค่า (estimator) ที่ดีขึ้นของค่าคาดหวังในอุดมคติ หรือตัวสุ่มตัวอย่าง (sampler) ที่ดีขึ้นของการแจกแจงความน่าจะเป็น ไม่ใช่ วิธีแก้ไขสถานะควอนตัมระหว่างการรัน เราจะตรวจสอบวิธี error mitigation ด้านล่าง ซึ่งทั้งหมดมีใน Qiskit และ addon ของมัน และเป็นเครื่องมือที่น่าสนใจในการไล่ตามความได้เปรียบเชิงควอนตัม
Twirled readout error extinction (TREX) ทำให้กระบวนการวัดเป็นแบบสุ่มโดยใช้การดำเนินการ Pauli ที่เลือกแบบสุ่มก่อนการวัด แล้วย้อนผลที่ทราบของมันกับ bitstring ที่สังเกตได้ด้วยวิธีคลาสสิก ภายใต้สมมติฐานเรื่องสัญญาณรบกวนในการวัดที่เหมาะสม วิธีนี้จะแปลงแชนเนลข้อผิดพลาดในการอ่านค่าให้อยู่ในรูปที่ง่ายและสมมาตรกว่า ซึ่งสอบเทียบและลดผลได้ง่ายขึ้น
Matrix-free measurement mitigation (M3) เป็นเทคนิคลดข้อผิดพลาดในการวัดที่ขยายขนาดได้ และไม่ต้องสร้าง assignment matrix หรือตัวผกผันของมันอย่างชัดเจน
Zero noise extrapolation (ZNE) ประมาณค่าที่ observable จะมีเมื่อไม่มีสัญญาณรบกวน โดยขยายสัญญาณรบกวนขึ้นด้วยตัวคูณที่ทราบค่าอย่างจงใจ แล้วอนุมานย้อนกลับไปยังกรณีที่ไม่มีสัญญาณรบกวน วิธีนี้ต้องการให้สัญญาณรบกวนขยายตัวในลักษณะที่คาดการณ์ได้ ซึ่งความสามารถในการคาดการณ์นี้อาจต้องใช้วิธีอื่นที่กล่าวถึงในบทเรียนนี้ (pulse stretching, gate folding และ probabilistic error amplification (PEA))
Probabilistic error cancellation (PEC) เป็นหนึ่งในเทคนิค error mitigation ที่ทรงพลังที่สุด แต่ก็ใช้การคำนวณมากที่สุดเช่นกัน วิธีนี้ทำงานโดยเรียนรู้พฤติกรรมสัญญาณรบกวนของระบบ แล้วพยายามหักล้างสัญญาณรบกวนนั้นด้วยการสร้างค่าประมาณที่ไม่เอนเอียงของการคำนวณในอุดมคติทางสถิติ PEC ให้ผลลัพธ์เป็น observable ที่แก้ไขทางสถิติ ไม่ใช่ผลลัพธ์ที่ผ่านการแก้ไขข้อผิดพลาด
ต่อไปเราจะเจาะลึกแต่ละวิธีเหล่านี้
M3
ข้อผิดพลาดในการวัดเป็นหนึ่งในแหล่งสัญญาณรบกวนที่คงอยู่นานที่สุดและขึ้นกับฮาร์ดแวร์มากที่สุดในอุปกรณ์ควอนตัมยุคใกล้ แม้สถานะควอนตัมจะถูกเตรียมและวิวัฒน์อย่างถูกต้อง ขั้นตอนการอ่านค่าสุดท้ายก็อาจรายงานผลลัพธ์ใน computational basis ที่แท้จริงผิดไปได้ ข้อผิดพลาดเหล่านี้เกิดจากการแยกแยะสถานะกายภาพที่สอดคล้องกับ และ ได้ไม่สมบูรณ์ การคลายตัวระหว่างการวัด และความไม่สมบูรณ์ของอุปกรณ์อิเล็กทรอนิกส์สำหรับการวัด ผลคือการแจกแจงของ bitstring ที่สังเกตได้มักเป็นเวอร์ชันที่บิดเบือนของการแจกแจงจริง (ในอุดมคติ) โดยความน่าจะเป็นถูกกำหนดให้ผลลัพธ์อื่นผิดไป
Measurement mitigation แก้ปัญหานี้โดยสร้างแบบจำลองอย่างชัดเจนว่าผลการวัดถูกกำหนดผิดอย่างไร ในสูตรมาตรฐาน พฤติกรรมนี้ถูกจับไว้ด้วย assignment matrix ซึ่งสมาชิก แทนความน่าจะเป็นที่จะบันทึกผลลัพธ์ เมื่อสถานะ basis ที่แท้จริงคือ ถ้าสัญญาณรบกวนในการวัดเป็นแบบคลาสสิกและนิ่ง เวกเตอร์ความน่าจะเป็นที่สังเกตได้ จะสัมพันธ์กับการแจกแจงในอุดมคติ ด้วยความสัมพันธ์เชิงเส้นอย่างง่าย
โปรดสังเกตว่า assignment matrix เป็นแผนที่สโตแคสติกแบบคลาสสิก ไม่ใช่ quantum channel มันกระทำกับค่าที่อ่านได้แบบคลาสสิก ไม่ใช่กับสถานะควอนตัมที่ถูกสุ่มตัวอย่างเพื่อให้ได้ค่าที่อ่านนั้น
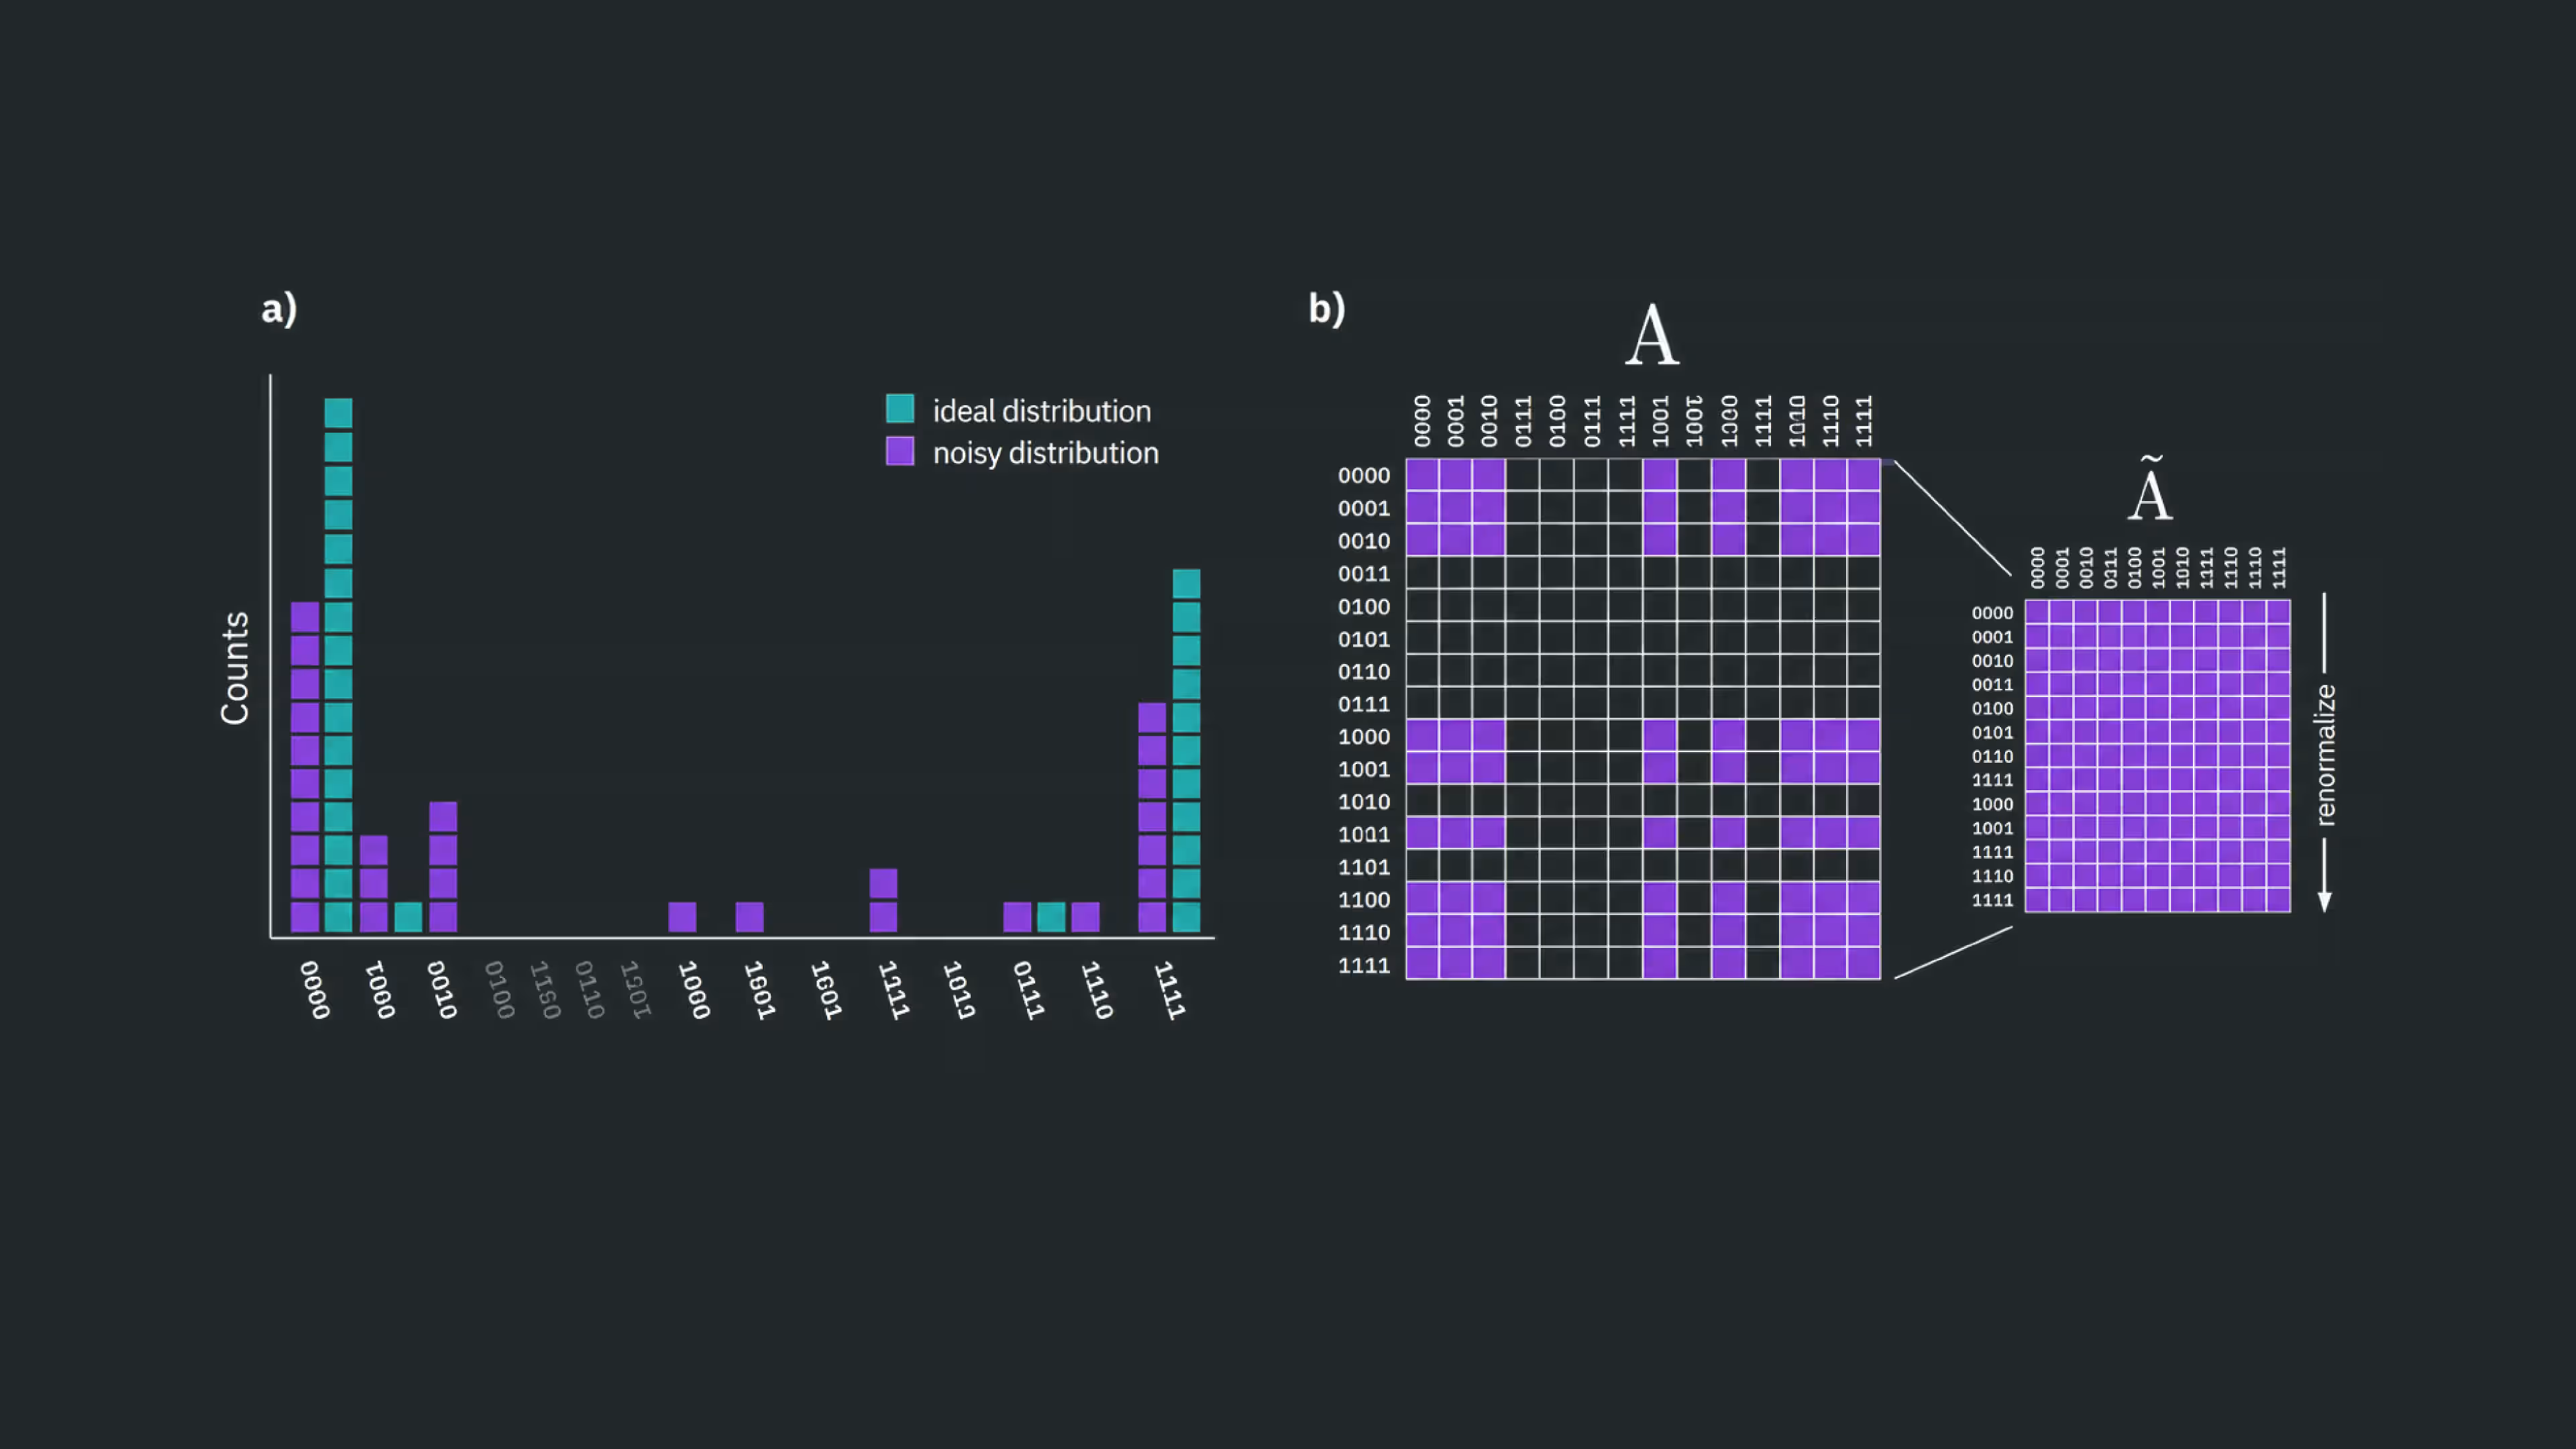
Matrix-free measurement mitigation (M3) ใช้โครงสร้างนี้เพื่อสร้างค่าประมาณที่ผ่านการลดผลของ โดยไม่ต้องสร้างหรือผกผันเมทริกซ์ เต็มรูปแบบเลย ซึ่งทำไม่ได้เมื่อมี qubit จำนวนมาก แต่ M3 อาศัยข้อเท็จจริงที่ว่างานควอนตัมยุคใกล้จำนวนมากให้การแจกแจงที่มียอดแหลมหรือเอนโทรปีต่ำ การลดผลจึงโฟกัสเฉพาะเซตย่อยของผลลัพธ์ที่มีส่วนสำคัญต่อการแจกแจงที่สังเกตได้
เพื่อสร้างแบบจำลองการกำหนดค่า ต้องรันการทดลองสอบเทียบเพิ่มเติมบนฮาร์ดแวร์ควอนตัม ซึ่งโดยทั่วไปคือการเตรียมสถานะ computational basis ที่ทราบแล้วบันทึกว่าระบบวัดรายงานมันอย่างไร ภาระการสอบเทียบเพิ่มขึ้นตามจำนวน qubit ที่วัด ขณะที่ต้นทุนการคำนวณของการลดผลขึ้นกับโครงสร้างของการแจกแจงที่สังเกตได้ ต้นทุนนี้น้อยกว่าที่ต้องใช้เพื่อระบุลักษณะ assignment matrix ขนาด แบบเต็มอย่างชัดเจนมาก แม้ภาระการสอบเทียบนี้มีอยู่จริง แต่ก็เบาเมื่อเทียบกับเทคนิคระดับวงจรอย่าง zero-noise extrapolation หรือ probabilistic error cancellation ทำให้ M3 เป็นเครื่องมือที่ใช้งานได้จริงและใช้กันอย่างกว้างขวางในการลดข้อผิดพลาดในการอ่านค่าในการทดลองควอนตัมยุคใกล้
โปรดทราบว่าการสอบเทียบมีประโยชน์เฉพาะเมื่อกระบวนการวัดยังคงเสถียรเพียงพอระหว่างการรันสอบเทียบกับการทดลองเป้าหมาย
ก่อนอื่นเราจะทำกรณีง่ายๆ ด้วยมือเพื่อแสดงว่ามันทำงานอย่างไร แล้วใช้เครื่องมือที่มีอยู่ใน Qiskit เพื่อแสดงการใช้ M3 ในขนาดที่สมจริงขึ้น
ตัวอย่างเล็กของ M3
เริ่มด้วยการสร้างสถานะ Bell อย่างง่าย
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "mthree": "mthree", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
import numpy as np

qc = QuantumCircuit(2, 2)
qc.h(0)
qc.cx(0, 1)
qc.measure([0, 1], [0, 1])
<qiskit.circuit.instructionset.InstructionSet at 0x714a5fa4d630>
เราใช้ซิมูเลเตอร์ที่มีแบบจำลองสัญญาณรบกวนได้ เพราะตัวอย่างนี้จำกัดอยู่ที่วงจรขนาดเล็กมาก เรากำหนดค่าแบบจำลองสัญญาณรบกวนอย่างชัดเจนให้มีข้อผิดพลาดในการอ่านค่าในรูปแบบดังนี้
if true=0: [95% chance of reading 0, 5% chance of reading 1]
if true=1: [8% chance of reading 0, 92% chance of reading 1]
อัตราข้อผิดพลาดในการอ่านค่าเหล่านี้สูงกว่าที่พบในคอมพิวเตอร์ควอนตัม IBM® จริงมาก เราเลือกค่าสูงเพื่อวัตถุประสงค์ด้านการสอน เพื่อให้เห็นผลของ M3 ได้ชัดเจน
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, ReadoutError

ro_error = ReadoutError([[0.95, 0.05], [0.08, 0.92]])

noise_model = NoiseModel()
noise_model.add_readout_error(ro_error, [0])
noise_model.add_readout_error(ro_error, [1])

backend_noisy = AerSimulator(noise_model=noise_model)
เรารันวงจรบนซิมูเลเตอร์ที่มีสัญญาณรบกวนเพื่อสังเกตผลของข้อผิดพลาดในการอ่านค่าได้
result = backend_noisy.run(qc, shots=5000, seed_simulator=123).result()
raw_counts = result.get_counts()
raw_counts
{'01': 290, '11': 2165, '10': 304, '00': 2241}
ในตัวอย่างจำลองของเรา เรากำหนดข้อผิดพลาดในการอ่านค่า ให้แบบจำลองสัญญาณรบกวนเอง แต่เมื่อใช้ คอมพิวเตอร์ควอนตัมจริง ข้อผิดพลาดในการอ่านค่าไม่เป็นที่ทราบล่วงหน้า ต้องประมาณจากการทดลอง สำหรับเรื่องนี้ เราสร้างวงจรที่เตรียม qubit ในสถานะ computational basis ที่ทราบคือ หรือ แล้ววัดมัน หากไม่มีข้อผิดพลาดในการอ่านค่า เราจะวัดได้สถานะที่เตรียมไว้พอดี จากการเก็บสถิติของการวัดเหล่านี้ เราสร้าง assignment matrix ที่อธิบายข้อผิดพลาดในการอ่านค่าได้ ในตัวอย่างจำลองนี้ มันควรดูคล้ายกับที่เรากำหนดไว้
สำหรับระบบที่สมจริงขึ้น ต้องสะสมสถิติสำหรับ qubit กายภาพแต่ละตัว ซึ่งบางครั้งไม่ใช่เรื่องง่าย เพราะการ transpile จับคู่วงจรนามธรรมกับฮาร์ดแวร์และหมายเลข qubit เปลี่ยนไป เราจะกลับมาดูเรื่องนี้ในตัวอย่างถัดไป ในตัวอย่างซิมูเลเตอร์นี้ เรากำหนดแบบจำลองข้อผิดพลาดในการอ่านค่าเดียวกันให้ทุก qubit ดังนั้นการระบุลักษณะครั้งเดียวก็เพียงพอ
# Define a function to make a state and measure it.
def measure_state(state):
    qc = QuantumCircuit(1, 1)
    if state == 1:
        qc.x(0)
    qc.measure(0, 0)
    return backend_noisy.run(qc, shots=5000, seed_simulator=123).result().get_counts()
# Use the function to get statistics on readout errors
cal_counts_0 = measure_state(0)  # True state = 0
cal_counts_1 = measure_state(1)  # True state = 1

cal_counts_0, cal_counts_1
({'1': 244, '0': 4756}, {'0': 420, '1': 4580})
# Create the normalized readout error matrix

# def normalize(d):
#    s = sum(d.values())
#    return {k: v/s for k,v in d.items()}
# p0 = normalize(cal_counts_0)
# p1 = normalize(cal_counts_1)

p0 = {k: v / sum(cal_counts_0.values()) for k, v in cal_counts_0.items()}
p1 = {k: v / sum(cal_counts_1.values()) for k, v in cal_counts_1.items()}

A_1q = np.array(
    [
        [p0["0"], p1["0"]],  # row: measured 0, columns true 0/1
        [p0["1"], p1["1"]],
    ]
)
A_1q
array([[0.9512, 0.084 ],
       [0.0488, 0.916 ]])
โปรดสังเกตว่านี่ใกล้เคียงกับเมทริกซ์ข้อผิดพลาดในการอ่านค่าที่ใช้สร้างซิมูเลเตอร์มาก
อีกครั้ง บนคอมพิวเตอร์ควอนตัมจริงเราจะมีสถิติแบบนี้สำหรับ qubit กายภาพหลายตัว สำหรับซิมูเลเตอร์นี้ เราสมมติว่า qubit สองตัวมีข้อผิดพลาดในการอ่านค่าที่เหมือนกันและเป็นอิสระต่อกัน ทำให้สร้าง assignment matrix สองควิบิต A_2q เป็นผลคูณเทนเซอร์ของเมทริกซ์หนึ่งควิบิตที่สอดคล้องกันได้ และโปรดสังเกตว่าจุดประสงค์ของ M3 ไม่ใช่ การสร้าง assignment matrix ทั้งหมด แต่ M3 โฟกัสที่เซตย่อยของผลลัพธ์ที่มีส่วนสำคัญต่อการแจกแจงที่สังเกตได้ เราจะสร้างเมทริกซ์ทั้งหมดสำหรับตัวอย่างเล็กมากของเราเพื่อดูว่ามันทำงานอย่างไร การใช้งาน M3 ใน qiskit-ibm-runtime ซับซ้อนกว่าตัวอย่างจำลองนี้ เพราะต้องรองรับ qubit จำนวนมากที่มีลักษณะการอ่านค่าต่างกัน โดยยังคงหลีกเลี่ยงการสร้าง assignment matrix เต็มรูปแบบ
A_2q = np.kron(A_1q, A_1q)
print(A_2q)
[[0.89794576 0.07107    0.07107    0.005625  ]
 [0.04965424 0.87653    0.00393    0.069375  ]
 [0.04965424 0.00393    0.87653    0.069375  ]
 [0.00274576 0.04847    0.04847    0.855625  ]]
สำหรับตัวอย่างนี้ เราสมมติว่าข้อผิดพลาดในการอ่านค่าบน qubit ต่างตัวเป็นอิสระต่อกัน ทำให้สร้าง assignment matrix สองควิบิตเป็นผลคูณเทนเซอร์ของเมทริกซ์หนึ่งควิบิตที่สอดคล้องกันได้
เราได้ผลลัพธ์ดิบและผลลัพธ์ที่ผ่านการลดผลมาเปรียบเทียบกัน
bitstrings = ["00", "01", "10", "11"]
# Normalize raw counts
raw_probs = np.array([raw_counts.get(b, 0) for b in bitstrings], dtype=float)
raw_probs /= raw_probs.sum()
raw_probs
array([0.4482, 0.0592, 0.0598, 0.4328])
ถึงตอนนี้ เราได้ระบุลักษณะจากการทดลองแล้วว่ากระบวนการวัดบิดเบือนความน่าจะเป็นของผลลัพธ์ในอุดมคติอย่างไร เป้าหมายของเราตอนนี้คือย้อนความบิดเบือนนี้และนำการแก้ไขที่ได้ไปใช้กับความน่าจะเป็นดิบ
เนื่องจากเราทำการผกผันเชิงเส้นไม่ใช่การแก้ไขทางกายภาพ "ความน่าจะเป็น" ที่ได้จึงไม่จำเป็นต้องเป็นบวกเสมอไป quasi-probability ที่เป็นลบน้อยมากเป็นสิ่งที่คาดไว้ และสะท้อนว่า measurement mitigation ให้ตัวประมาณค่า ไม่ใช่การแจกแจงความน่าจะเป็นทางกายภาพ
# Explicit inversion is feasible only for very small systems
# This is why M3 avoids creating the entire A matrix.

A_inv = np.linalg.inv(A_2q)

# Note: mitigated_probs might contain negative values.
# This is expected and reflects estimator, not physical, probabilities.

mitigated_probs = A_inv @ raw_probs
print(mitigated_probs)
[ 4.96000451e-01 -4.69852308e-04 2.17747967e-04 5.04251654e-01]
เราแปลงค่าเหล่านี้เป็น counts สำหรับการวาดกราฟ
shots = sum(raw_counts.values())  # e.g., 5000
ideal_probs = [0.50, 0.00, 0.00, 0.50]  # ideal Bell distribution
# Convert probabilities to integer counts for plotting only.
# Not physically meaningful when probabilities are negative

def probs_to_counts(bitstrings, probs, shots):
    """
    Convert a probability vector into a Qiskit-style counts dictionary.
    Ensures integer shot counts and correct normalization.
    """
    counts = {}
    # First convert to raw integer counts
    int_counts = [round(p * shots) for p in probs]
    # Fix rounding error by adjusting the last entry
    diff = shots - sum(int_counts)
    int_counts[-1] += diff
    # Build dict
    for b, c in zip(bitstrings, int_counts):
        if c > 0:
            counts[b] = c
    return counts

mitigated_counts = probs_to_counts(bitstrings, mitigated_probs, shots)
ideal_counts = probs_to_counts(bitstrings, ideal_probs, shots)
สุดท้าย เราดูการแจกแจงดิบ การแจกแจงที่ผ่านการลดผล และการแจกแจงในอุดมคติ "counts" ที่ผ่านการลดผลด้านล่างเป็นเพียงตัวช่วยในการแสดงภาพ ซึ่งได้จากการปรับสเกล quasi-probability ที่ผ่านการลดผล
from qiskit.visualization import plot_histogram

plot_histogram(
    [raw_counts, mitigated_counts, ideal_counts],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
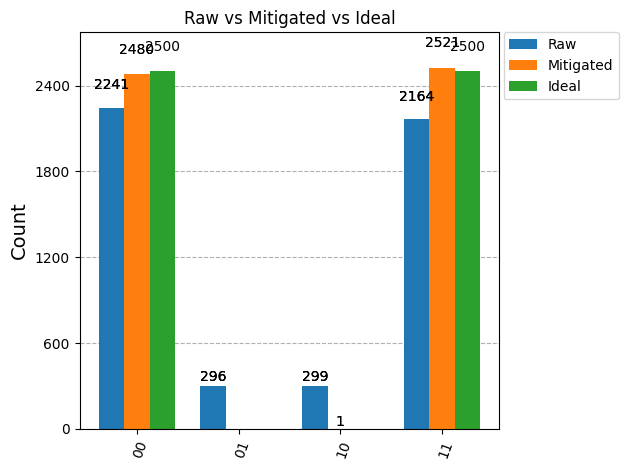
ชัดเจนว่าผลลัพธ์ที่ผ่าน M3 ใกล้เคียงกับการแจกแจงในอุดมคติมากกว่ามาก และเราเห็นได้ว่าเพราะอะไร
การใช้ M3 กับ workflow ที่สมจริงขึ้นซับซ้อนกว่ามาก ลองพิจารณา:
- คอมพิวเตอร์ควอนตัมจริงมี qubit กายภาพจำนวนมาก แต่ละตัวมีลักษณะข้อผิดพลาดในการอ่านค่าของตัวเอง ข้อผิดพลาดเหล่านี้ต้องถูกสร้างแบบจำลองและรวมเข้าด้วยกันอย่างเหมาะสม
- assignment matrix เต็มรูปแบบโตแบบเอกซ์โพเนนเชียลตามจำนวน qubit และไม่นานก็ไม่สามารถสร้างอย่างชัดเจนได้ นี่คือเหตุผลที่ M3 โฟกัสที่เซตย่อยของผลลัพธ์ที่มีส่วนสำคัญต่อการแจกแจงที่สังเกตได้ แทนที่จะสร้าง assignment matrix ทั้งหมด
- สำหรับปัญหาจริงที่สนใจ การแจกแจงในอุดมคติอาจไม่เป็นที่ทราบ
ด้วยเหตุผลทั้งหมดนี้ workflow การลดผลแบบเต็มจึงถูกรวมไว้ใน addon mthree ของ Qiskit
ตัวอย่าง M3 ที่ใหญ่ขึ้น
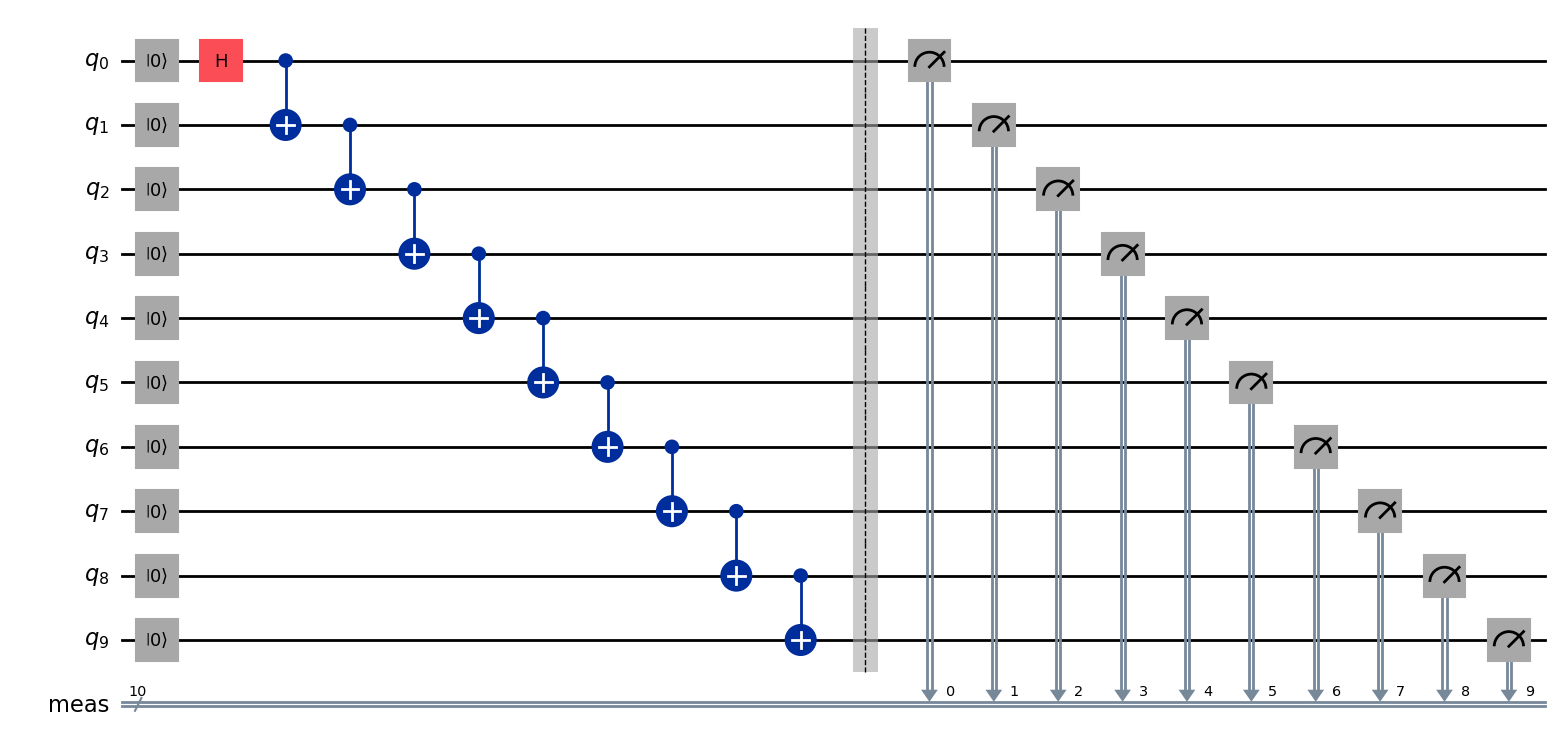
ตอนนี้เราใช้ M3 กับวงจรที่ใหญ่ขึ้น ซึ่งการหา subspace ที่เกี่ยวข้องของ ด้วยมือจะยุ่งยาก แต่ก็ยังง่ายพอที่เราจะรู้การแจกแจงในอุดมคติ นั่นคือสถานะ GHZ เราเริ่มด้วยการ import แพ็กเกจ mthree และกำหนดวงจรควอนตัม GHZ
import numpy as np
from qiskit import QuantumCircuit

# from qiskit_ibm_runtime.fake_provider import FakeCasablancaV2
import mthree

num_qubits = 10

qc = QuantumCircuit(num_qubits)
qc.reset(range(num_qubits))
qc.h(0)
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)
qc.measure_all()
qc.draw("mpl")
เพื่อรันสิ่งนี้บนคอมพิวเตอร์ควอนตัมจริง เรา import qiskit_ibm_runtime และแพ็กเกจอื่นที่จำเป็น เราใช้ SamplerV2 เพื่อให้ได้การแจกแจงของผลลัพธ์
# Import packages needed for using real quantum computers

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime.executor_sampler import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# --------- Configuration ----------
service = QiskitRuntimeService(channel="ibm_quantum_platform", instance="your crn here")

# backend_real = service.backend("ibm_fez")     # adjust if needed
backend_real = service.least_busy(simulator=False, operational=True)
ตอนนี้เรา transpile วงจรไปยัง backend ของเรา เราตั้งระดับการ optimize เป็น 0 ในที่นี้เพื่อโฟกัสที่ผลของ M3 โดยไม่เพิ่มเครื่องมืออื่น นั่นหมายความว่า fidelity สุดท้ายจะไม่สะท้อนสิ่งที่ทำได้บนฮาร์ดแวร์ IBM Quantum® เมื่อใช้เครื่องมือทั้งชุดที่มี แต่ทำให้เราโฟกัสที่ประโยชน์ของ M3 โดยเฉพาะได้
# Exclude any optimization to focus only on M3 effects
opt_level = 0
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend_real)
qc_isa = pm.run(qc)
ตอนนี้เรากำหนดค่า Sampler โดยปิดเทคนิค error suppression เพิ่มเติม เช่น dynamical decoupling และ twirling อีกครั้ง
shots = 8192

# No twirling
sampler_no_twirl = Sampler(mode=backend_real)
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = False
sampler_no_twirl.options.default_shots = shots
sampler_no_twirl.options.dynamical_decoupling.enable = False
สุดท้าย เรารัน job ของเรา
# This job took 7 seconds on ibm_fez. Your actual execution time can vary.
job = sampler_no_twirl.run([qc_isa])
res_real = job.result()
job_id = job.job_id()
print("job number for real  ", job_id)
job number for real d7ark4e5nvhs73a2fu6g
เราดึง counts ดิบจากวงจรข้างต้นได้
counts_real = []
for i in range(len(res_real)):
    counts_real.append(res_real[i].data.meas.get_counts())
ตอนนี้เรารัน mthree บน backend ของเราเพื่อระบุลักษณะแบบจำลองการกำหนดค่าที่ใช้สำหรับ measurement mitigation เราปรับสเกลการแจกแจงดิบโดยใช้ข้อมูลนั้น โปรดทราบว่าบางครั้งอาจได้ความน่าจะเป็นที่เป็นลบน้อยมาก (จึงเรียกว่า quasi-probability)
# Added 6 sec on ibm_fez, on top of original 7 sec to run circuits. Your time might differ.
mit_real = mthree.M3Mitigation(backend_real)
mappings_real = mthree.utils.final_measurement_mapping(qc_isa)
mit_real.cals_from_system(mappings_real)
quasis_real = mit_real.apply_correction(counts_real, mappings_real)
การแก้ไขของ mthree ให้ quasi-probability ไม่ใช่ counts เราปรับสเกลเป็น counts ด้วยมือได้ ฟังก์ชันช่วยด้านล่างแปลงเป็น counts และปัดเป็นจำนวนเต็ม นอกจากนี้ สำหรับวงจรขนาดใหญ่ จะมีสตริงที่ผิดพลาดจำนวนมากที่มี counts น้อยมาก แต่ทำให้ฮิสโตแกรมรก ฟังก์ชันช่วยตัวที่สองด้านล่างตัดสตริงที่มี counts น้อยกว่าเกณฑ์ที่เราเลือกออก เพื่อให้เห็นพจน์หลักของการแจกแจงได้ชัดเจน
def quasidistribution_to_counts(quasi_list, shots):
    return [
        {bitstr: int(round(float(prob) * shots)) for bitstr, prob in quasi.items()}
        for quasi in quasi_list
    ]

def filter_counts_by_threshold(counts_list, t):
    filtered = []

    for counts in counts_list:
        new_counts = {}
        for bitstr, val in counts.items():
            c = int(round(float(val)))  # FORCE conversion
            if abs(c) >= t:
                new_counts[bitstr] = c
        filtered.append(new_counts)

    return filtered
quasi_counts = quasidistribution_to_counts(quasis_real, shots)
trim_threshold = 30
trimmed_quasi = filter_counts_by_threshold(quasi_counts, trim_threshold)
trimmed_raw = filter_counts_by_threshold(counts_real, trim_threshold)
เรายังสร้างการแจกแจงทางทฤษฎีในอุดมคติได้ง่ายๆ ซึ่งสถานะ all-zero และ all-one มีความน่าจะเป็นเท่ากัน และผลลัพธ์อื่นทั้งหมดมีความน่าจะเป็นเป็นศูนย์ เพื่อนำมาเปรียบเทียบ
ideal = [
    {
        "0" * num_qubits: int(round(float(shots) / 2)),
        "1" * num_qubits: int(round(float(shots) / 2)),
    }
]
สุดท้าย เราแสดงภาพผลลัพธ์ได้
from qiskit.visualization import plot_histogram

plot_histogram(
    [trimmed_raw[0], trimmed_quasi[0], ideal[0]],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
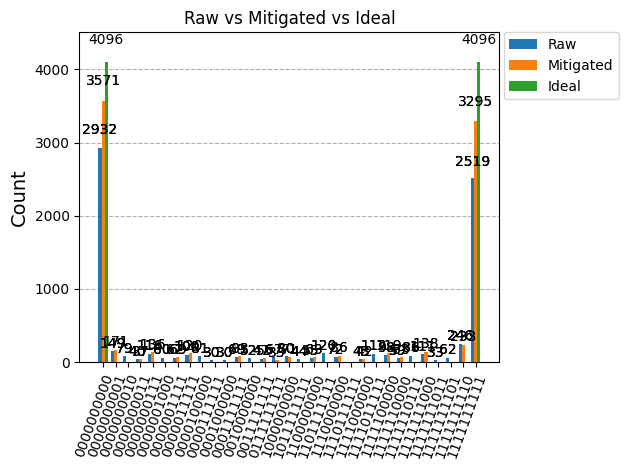
ผลลัพธ์ที่ผ่านการลดผลใกล้เคียงกับการแจกแจงในอุดมคติมากกว่าผลลัพธ์ที่ไม่ผ่านการลดผล เราวัดปริมาณนี้ได้ดีขึ้นโดยใช้ counts ของ bitstring ในอุดมคติ
def extract_all_zero_and_all_one(counts):
    """
    Extract counts for the all-0 and all-1 bitstrings.

    Parameters
    ----------
    counts : dict[str, int]
        Counts dictionary.

    Returns
    -------
    dict[str, int]
        Dictionary containing only 00...0 and 11...1 entries if present.
    """
    n = len(next(iter(counts)))  # infer bitstring length
    zero_state = "0" * n
    one_state = "1" * n

    return {k: counts[k] for k in (zero_state, one_state) if k in counts}

correct_counts_raw = extract_all_zero_and_all_one(trimmed_raw[0])
correct_counts_mitigated = extract_all_zero_and_all_one(trimmed_quasi[0])
keys = ["0" * num_qubits, "1" * num_qubits]
fidelity_raw = (
    correct_counts_raw.get(keys[0]) + correct_counts_raw.get(keys[1])
) / shots
fidelity_mit = (
    correct_counts_mitigated.get(keys[0]) + correct_counts_mitigated.get(keys[1])
) / shots
print("Percent correct raw counts: ", fidelity_raw)
print("Percent correct mitigated counts: ", fidelity_mit)
Percent correct raw counts:  0.6654052734375
Percent correct mitigated counts:  0.838134765625
เครื่องมืออย่างง่ายนี้ปรับปรุง fidelity ของเราได้ 26% เมื่อเทียบกับ fidelity ที่ไม่ผ่านการลดผล ด้วยภาระที่ค่อนข้างต่ำ ชัดเจนว่า M3 มีคุณค่ามาก แต่วงจร GHZ ถูกเลือกเพราะเป็นกรณีใช้งานที่ดี เนื่องจากมียอดแหลมมากบนสถานะผลลัพธ์สองสถานะ บางปัญหาให้ counts ที่กระจายสม่ำเสมอกว่า (สถานะเอนโทรปีสูง) สำหรับวงจรที่ลึกมากและมี qubit จำนวนมาก ข้อผิดพลาดของ gate และสัญญาณรบกวนที่ไม่เกี่ยวกับข้อผิดพลาดในการวัดมักทำให้เกิดสถานะเอนโทรปีสูง ในกรณีเช่นนั้น M3 ทำงานบนปริภูมิสถานะที่ค่อนข้างใหญ่ มีสามแนวทางที่เป็นไปได้สำหรับเรื่องนี้:
(1) ยอมรับว่านี่เป็นข้อจำกัดของ M3
(2) โปรดสังเกตว่าขอบเขตบนของปริภูมิของเมทริกซ์ที่ M3 สร้างคือ num_shots num_shots ไม่ใช่ โดยแบบแรกเล็กกว่ามากเมื่อจำนวน qubit มาก
(3) ด้วยความระมัดระวังอย่างยิ่งเท่านั้น ให้ลบ bitstring ที่มีความน่าจะเป็นต่ำมากออกจาก counts ดิบที่ป้อนให้ M3 วิธีนี้อาจทำให้เกิดความเอนเอียง และการจำกัด support ของสถานะของคุณอาจรบกวนการลู่เข้าในแนวทางอย่างวิธี Krylov ควรทำเฉพาะเมื่อคุณรู้ชัดเจนว่าทำไปเพื่ออะไรและคาดการณ์ผลทั้งหมดของมันได้ นี่คือเหตุผลที่การตัดทอนเช่นนี้ไม่ใช่ฟีเจอร์ในตัวของ M3
สำหรับข้อมูลเพิ่มเติมเกี่ยวกับ addon mthree ของ Qiskit ดูตัวอย่าง วิธีติดตั้ง ข้อมูลเบื้องหลัง และเอกสารอ้างอิง API ได้ในเอกสาร
Twirled readout error extinction (TREX)
Twirled Readout Error Extinction (TREX) เป็นเทคนิคลดข้อผิดพลาดในการวัดที่ใช้บนคอมพิวเตอร์ควอนตัมสมัยใหม่ เป้าหมายคือกำจัดความเอนเอียงที่เกิดจากข้อผิดพลาดในการอ่านค่าแบบคลาสสิก โดยไม่ต้องระบุลักษณะหรือผกผัน assignment matrix ของการวัดทั้งหมด
TREX ไม่ใช่ error correction และไม่ได้ปรับปรุง fidelity ของสถานะ แต่รับรองว่าตัวประมาณค่าคาดหวังไม่เอนเอียงต่อสัญญาณรบกวนในการอ่านค่า จนถึงระดับข้อผิดพลาดทางสถิติ โดยหาค่าเฉลี่ยจาก basis การวัดแบบสุ่มและปรับสเกลใหม่ บนฮาร์ดแวร์ IBM Quantum TREX เป็นวิธีลดผลเริ่มต้นสำหรับการประมาณค่าคาดหวัง และสอดคล้องกับ resilience_level = 1 ใน primitive Estimator ของ IBM Quantum
ธรรมชาติของข้อผิดพลาดในการอ่านค่าบนฮาร์ดแวร์ตัวนำยิ่งยวด
บน qubit ตัวนำยิ่งยวดของ IBM ข้อผิดพลาดในการอ่านค่าส่วนใหญ่มาจาก:
-
ความน่าจะเป็นของการพลิกบิตที่ไม่สมมาตร (เช่น บ่อยกว่าทิศทางตรงข้าม)
-
การคลายตัวที่ขึ้นกับสถานะระหว่างการวัดเอง
-
crosstalk ที่ไม่รุนแรงแต่ไม่ควรมองข้ามระหว่าง readout resonator ที่อยู่ติดกัน
ที่สำคัญคือ ข้อผิดพลาดเหล่านี้มักสร้างแบบจำลองเป็นกระบวนการสโตแคสติกแบบคลาสสิกที่กระทำกับผลการวัดได้ TREX ใช้แนวคิดมาตรฐานจากการปรับแต่งสัญญาณรบกวน (noise tailoring) คือการสุ่ม (twirling) ขั้นตอนการวัด TREX มักดำเนินการในสองขั้นตอน:
-
Twirling และ "untwirling" แบบคลาสสิก
-
การปรับสเกลค่าคาดหวังใหม่โดยใช้วงจรสอบเทียบ
สมมติว่าค่าคาดหวังของ observable สัมพันธ์กับค่าประมาณที่มีสัญญาณรบกวน ดังนี้:
โดยที่ เป็นตัวคูณคงที่ที่ปรับสเกลค่าประมาณ และ เป็นความเอนเอียงจากแหล่งที่อธิบายข้างต้น เราใช้ ในที่นี้เพื่อเตือนว่าเราจัดการเฉพาะข้อผิดพลาดในการอ่านค่า ยังมีข้อผิดพลาดของ gate ที่ต้องพิจารณาอยู่
ก่อนการวัดเล็กน้อย qubit แต่ละตัวจะถูก conjugate แบบสุ่มด้วยตัวดำเนินการ Pauli (เช่น I หรือ X) หลังจากนั้นผลการวัดจะถูก untwirl แบบคลาสสิก
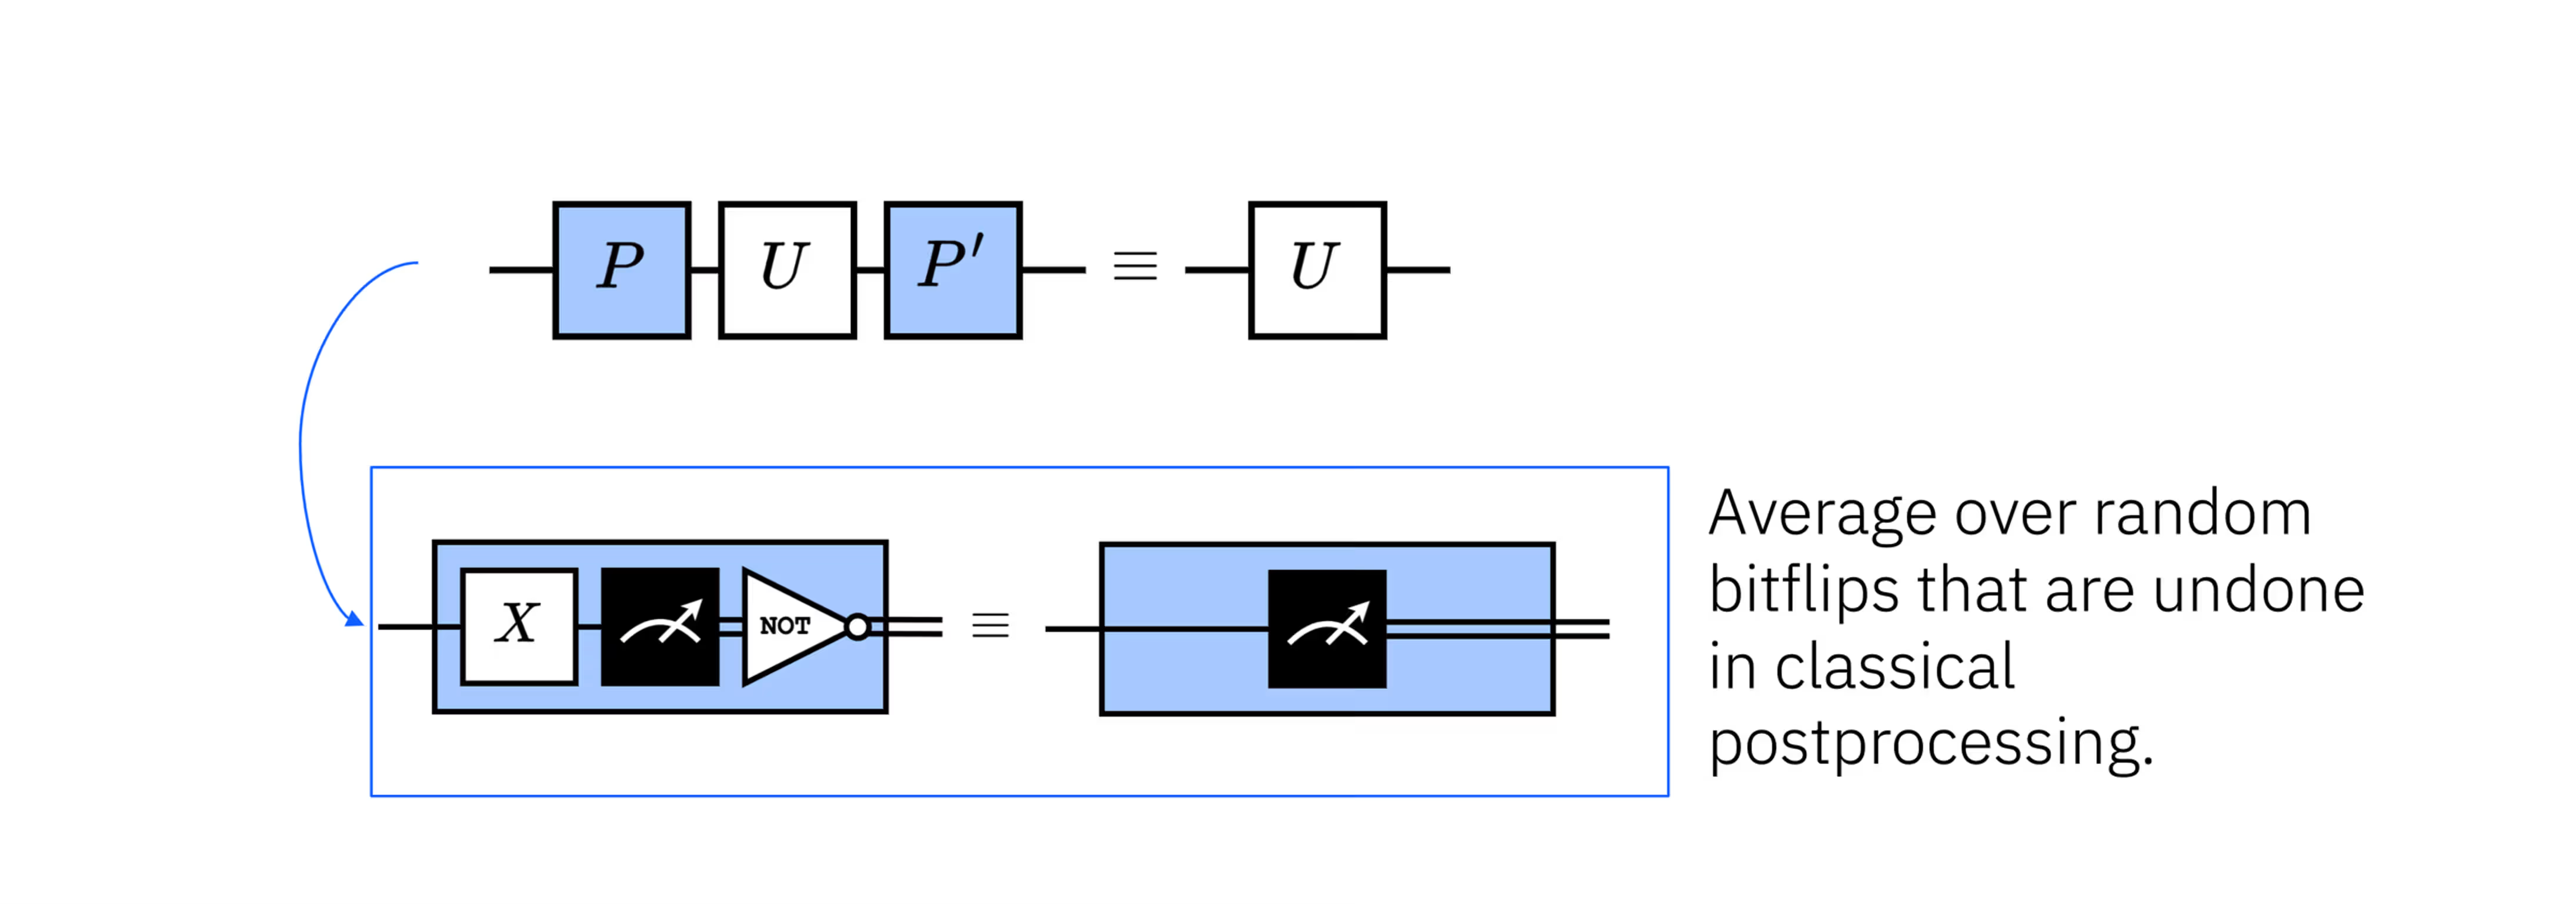
การหาค่าเฉลี่ยจากการสุ่มเหล่านี้ทำให้แชนเนลการอ่านค่าสมมาตร ผลคือความไม่สมมาตรเชิงระบบในกระบวนการอ่านค่าถูกแปลงเป็นแชนเนลข้อผิดพลาดที่สมมาตรกว่า ซึ่งผลที่เหลือจัดการได้ด้วยการสอบเทียบและการปรับสเกลใหม่ พูดง่ายๆ คือ ถ้าเช่นมีความเอนเอียงไปทางสถานะ เราจะพลาดการวัด บางส่วน ด้วยการ twirl รอบการวัด เราสลับแบบสุ่มว่าผลลัพธ์ตรรกะใดสัมพันธ์กับกระบวนการอ่านค่าทางกายภาพ แล้วย้อนการสลับนั้นแบบคลาสสิกในภายหลัง การหาค่าเฉลี่ยจากการวัดแบบสุ่มเช่นนี้จำนวนมากจะกำจัดความโน้มเอียงเชิงระบบที่ชอบผลลัพธ์หนึ่งมากกว่าอีกผลลัพธ์หนึ่ง วิธีนี้กำจัดความเอนเอียงของการวัดหลักภายใต้สมมติฐานของแบบจำลอง TREX ดังนั้นเราจึงได้:
อย่างไรก็ตาม ค่าคาดหวังอาจยังต้องปรับสเกลใหม่ ขั้นตอนที่สองคือการใช้วงจรสอบเทียบ (วงจรที่ทราบผลลัพธ์) เพื่อประมาณตัวคูณ จากนั้นนำไปใช้เพื่อให้ได้ค่าประมาณที่ดีขึ้นมาก
ค่าคาดหวังของ observable แบบ Pauli กลายเป็นตัวประมาณค่าที่ไม่เอนเอียงของค่าในอุดมคติ ไม่มีการเรียนรู้หรือผกผันแบบจำลองสัญญาณรบกวนอย่างชัดเจน ซึ่งเป็นเหตุผลที่ TREX เสถียรเชิงตัวเลขและมีต้นทุนต่ำ อีกครั้งที่ข้อผิดพลาดของ gate ยังไม่ได้รับการจัดการในที่นี้
ในการประมาณค่าคาดหวัง ของ observable อาจมีความแปรปรวนจากการสุ่มตัวอย่างจำนวนจำกัด อาจมีข้อผิดพลาดแบบ incoherent และ coherent หลายประเภท และอาจมีความเอนเอียง จากข้อผิดพลาดในการอ่านค่าด้วย ความเอนเอียงนี้เกิดจากแหล่งอย่างการเปลี่ยนสถานะที่ไม่สมมาตรที่เราได้กล่าวถึง ในทางปฏิบัติ ความเอนเอียงนี้มักสร้างแบบจำลองได้ดีเป็นแชนเนลสโตแคสติกแบบคลาสสิกที่กระทำหลังการวิวัฒน์เชิงควอนตัม TREX แปลงแชนเนลการวัดที่มีผลจริง เพื่อให้ตัวประมาณค่าของ ไม่เอนเอียงต่อข้อผิดพลาดในการอ่านค่า เรื่องนี้เห็นได้ค่อนข้างง่ายโดยใช้ตัวอย่างที่ง่ายที่สุดของ gate สำหรับ twirling คือ X ถ้ามีความไม่สมมาตรใน เมื่อเทียบกับ แต่เราสลับแบบสุ่มว่าสถานะใดกำลังถูกอ่าน (แล้วพลิกกลับทีหลังแบบคลาสสิก) ก็จะกำจัดความไม่สมมาตรเชิงระบบได้อย่างชัดเจน (แม้การสุ่มตัวอย่างจำนวนจำกัดจะยังหมายความว่าอาจมีความไม่สมมาตรเชิงสุ่มเล็กน้อยในการวัด) ในทางปฏิบัติ gate สำหรับ twirling ใน TREX ไม่ได้จำกัดอยู่แค่ I และ X แต่เท่านี้ก็พอสำหรับคำอธิบาย
TREX ช่วยให้เราได้ค่าประมาณของค่าคาดหวังที่ปราศจากความเอนเอียงจากข้อผิดพลาดในการอ่านค่า อาจยังมีความเอนเอียงจากแหล่งอื่น (เช่น coherent over-rotation) TREX มุ่งเป้าเฉพาะการอ่านค่า เนื่องจาก TREX แทนที่ความเอนเอียงเชิงระบบด้วยการทำให้สมมาตรแบบสุ่ม โดยทั่วไปจึงแปลงความเอนเอียงเป็นความแปรปรวนเชิงสุ่มเพิ่มเติม ทำให้ความแปรปรวนของตัวประมาณค่าเพิ่มขึ้นที่ต้นทุนการสุ่มตัวอย่างเท่าเดิม
ตรวจสอบความเข้าใจของคุณ
สมมติว่าเราใช้ estimator กับวงจรที่เตรียมสถานะ ในการประมาณ และสมมติต่อว่าข้อผิดพลาดในการวัดทำให้ผลลัพธ์ที่สอดคล้องกับ ถูกรายงานเป็น 10% ของเวลา ขณะที่ผลลัพธ์ที่สอดคล้องกับ ถูกรายงานเป็น เพียง 1% ของเวลา ความไม่สมมาตรระหว่างข้อผิดพลาดในการรายงานเหล่านี้ทำให้เกิดความเอนเอียงในการวัด
(a) หากไม่มีข้อผิดพลาดในการวัดเช่นนี้เลย ค่าคาดหวังในอุดมคติของ observable จะเป็นเท่าใด
(b) เมื่อมีข้อผิดพลาดในการวัดหรือการอ่านค่าที่ไม่สมมาตร ค่าคาดหวังของ observable เป็นเท่าใด
(c) พิจารณาชุดจำกัดของ gate Pauli twirling: I และ X สมมติว่า I และ X ถูกใช้แบบสุ่มด้วยความน่าจะเป็น 50% ในหลาย shot อัตราข้อผิดพลาดในการวัดยังคงเท่าเดิม จากนั้น gate Pauli (I หรือ X) ถูกย้อนแบบคลาสสิก จงทำตารางผลลัพธ์ที่เป็นไปได้ทั้งหมดและความน่าจะเป็นของแต่ละผลลัพธ์ อันเนื่องมาจากการซ้อนทับเริ่มต้น ข้อผิดพลาดในการวัดที่ไม่สมมาตร และ gate Pauli ที่กำหนดแบบสุ่ม
(d) ใช้ตารางเพื่อหาค่าคาดหวัง โดยใช้กลยุทธ์ twirling
(e) เปรียบเทียบค่าคาดหวัง: ค่าในอุดมคติ ค่าที่ไม่ใช้ twirling และค่าที่ใช้ twirling
(f) อะไรที่ถูกละไว้จากการวิเคราะห์นี้ ซึ่งพบได้ในการใช้ TREX เต็มรูปแบบ
คำตอบ
(a) คุณใช้สัญชาตญาณและสมมาตรบอกได้เลยว่า เพื่อแสดงอย่างชัดเจน:
(b) สถานะอาจยุบไปเป็น หรือ เมื่อวัด โดยแต่ละสถานะมีโอกาส 50% แต่ในส่วน 50% ที่ยุบไปเป็นสถานะ นั้น 1% ของส่วนนั้น (หรือ 0.5% ของทุกกรณี) จะถูกรายงานผิดเป็น ในส่วน 50% ที่ยุบไปเป็น นั้น 10% (หรือ 5% ของทุกกรณี) จะถูกรายงานผิดเป็น ซึ่งเหลือผลดังนี้:
- 54.5%
- 45.5% หากไม่นับข้อผิดพลาดประเภทอื่นที่เป็นไปได้ทั้งหมด เราจะได้ค่าประมาณเป็น
(c)
| Pauli | ผลการวัดในอุดมคติ | ผลลัพธ์หลัง Pauli | ข้อผิดพลาดในการอ่านค่า | ย้อน Pauli | ผลลัพธ์ที่รายงานสุดท้าย | ความน่าจะเป็น |
|---|---|---|---|---|---|---|
| I | 0 | 0 | ไม่มี | I | 0 | 50% 50% 99% = 24.75% |
| I | 0 | 0 | I | 1 | 50% 50% 1% = 0.25% | |
| I | 1 | 1 | ไม่มี | I | 1 | 50% 50% 90% = 22.5% |
| I | 1 | 1 | I | 0 | 50% 50% 10% = 2.5% | |
| X | 0 | 1 | ไม่มี | X | 0 | 50% 50% 90% = 22.5% |
| X | 0 | 1 | X | 1 | 50% 50% 10% = 2.5% | |
| X | 1 | 0 | ไม่มี | X | 1 | 50% 50% 99% = 24.75% |
| X | 1 | 0 | X | 0 | 50% 50% 1% = 0.25% |
(d) จากข้อก่อนหน้า เราทราบค่าคาดหวังของ Z ในแต่ละสถานะสุดท้ายแล้ว เพียงหาค่าเฉลี่ยถ่วงน้ำหนัก:
(e) ในกรณีที่ง่ายมากนี้ การใช้ twirling ของเราคืนค่าคาดหวังในอุดมคติได้อย่างแม่นยำ ซึ่งไม่ใช่เรื่องปกติ สิ่งที่เป็นปกติคือ twirling ย้อนความเอนเอียงอย่างที่เกิดจากการเปลี่ยนสถานะที่ไม่สมมาตร และคืนค่าคาดหวังที่ใกล้เคียงค่าในอุดมคติมากขึ้น
(f) นี่เป็นการประยุกต์ใช้แบบจำลองจำลอง อาจมีหลายสิ่งที่ขาดไป โดยเฉพาะอย่างยิ่ง เรายังไม่ได้รันวงจรสอบเทียบในที่นี้เพื่อประมาณตัวคูณปรับสเกล ซึ่งโดยทั่วไปจำเป็น
รายละเอียดการใช้งาน
TREX ถูกใช้โดยอัตโนมัติเมื่อใช้ primitive EstimatorV2 กับ resilience_level = 1 (ค่าเริ่มต้น) โปรดทราบว่ามันไม่ถูกใช้โดยอัตโนมัติกับ primitive Sampler เพราะ Sampler คืนการแจกแจงความน่าจะเป็นเต็มรูปแบบ ไม่ใช่ค่าคาดหวัง
เมื่อเปิดใช้ TREX runtime จะสร้างวงจรเวอร์ชัน twirl การวัดโดยแทรก Pauli หนึ่งควิบิตแบบสุ่มก่อนการวัดทันที การประมวลผลภายหลังแบบคลาสสิกจะย้อน Pauli เหล่านี้ เวอร์ชันของวงจรเหล่านี้เป็นแบบสุ่มข้าม shot ต่างๆ และข้าม qubit ต่างๆ ภายใน shot เดียวกันด้วย จากนั้นเวอร์ชันของวงจรทั้งหมดจะถูกรวมเป็น estimator ตัวเดียว
TREX ขยายขนาดได้ดีมาก ต้องใช้วงจรสอบเทียบเพิ่มเติม ทำให้ภาระการสุ่มตัวอย่างมักเป็นตัวคูณคงที่ขนาดเล็ก (มักเป็น 2-4 เท่า) แต่การลดผลนี้เฉพาะเจาะจงกับ observable ไม่ได้รักษาการแจกแจงไว้
TREX ถูกออกแบบให้ทำงานร่วมกับวิธี error suppression และ error mitigation จำนวนมากได้อย่างราบรื่น รวมถึงต่อไปนี้:
-
Dynamical decoupling (DD) - ทำงานในช่วงที่ว่าง ตั้งฉากกับ readout mitigation
-
Gate หรือ Pauli twirling - มักเสริมกัน TREX อาศัย twirling อยู่แล้วแต่มุ่งเป้าเฉพาะสัญญาณรบกวนจากการอ่านค่า
-
Zero-Noise Extrapolation (ZNE) - ZNE มุ่งเป้าสัญญาณรบกวนของ gate ส่วน TREX จัดการความเอนเอียงของการวัด การผสมนี้ใช้ที่ resilience level 2
-
Probabilistic error amplification และ probabilistic error cancellation ใน workflow ของ Estimator
อย่างไรก็ตาม บางวิธีไม่สามารถ (หรือไม่ควร) ใช้ร่วมกับ TREX:
-
การแก้ไขความน่าจะเป็นระดับ Sampler: TREX ไม่คืนความน่าจะเป็นของ bitstring ที่ผ่านการแก้ไข
-
การลดผลภายหลังกับข้อมูล TREX ที่ผ่านการลดผลแล้ว: การแก้ไขซ้ำซ้อนอาจนำความเอนเอียงกลับมาได้อีก
การรวม TREX เข้ากับการลดข้อผิดพลาดการอ่านค่าแบบ assignment-matrix อย่าง M3 ทำได้ยาก M3 สมมติว่าช่องสัญญาณการวัดคงที่ แต่ TREX สุ่มการวัดโดยตั้งใจ ซึ่งทำให้สมมติฐานที่ M3 ใช้ไม่เป็นจริง ในแง่นี้ เราจึงรวมสองเทคนิคนี้เข้าด้วยกันตรง ๆ ไม่ได้ อย่างไรก็ตาม ถ้าคุณใช้ measurement twirling ระหว่างการสอบเทียบที่ใช้ใน M3 คุณอาจใช้ทั้งแนวทางแบบ assignment matrix และแนวทางลดข้อผิดพลาดด้วย twirling พร้อมกันได้ (แม้ว่าแนวทาง twirling นี้จะไม่เหมือนกับ TREX เสียทีเดียว) นี่เป็นหัวข้อที่เจอซ้ำ ๆ ในการรวมเทคนิคการลดและการกดข้อผิดพลาด: การเอาเทคนิคมารวมกันแบบสุ่มสี่สุ่มห้าไม่ได้ผล แต่ถ้ารวมอย่างระมัดระวังให้เทคนิคเหล่านั้น "รู้" ถึงกันและกัน ก็ใช้ได้ผลและให้ประโยชน์มาก
TREX รับประกันแค่ว่าค่าคาดหวังจะปราศจากความเอนเอียงที่เกิดจากข้อผิดพลาดในการอ่านค่า มันไม่ได้ลดความแปรปรวน และไม่ได้ป้องกันความเอนเอียงประเภทอื่น และแน่นอนว่ามันไม่ได้แก้ข้อผิดพลาดทั้งหมด แต่ก็มักจะช่วยปรับปรุงได้มาก และทำได้ด้วยโอเวอร์เฮดที่ต่ำกว่าวิธีอื่นบางวิธีที่ต้องเรียนรู้โมเดลสัญญาณรบกวนแบบเต็มมาก TREX มักเป็นการลดข้อผิดพลาดการอ่านค่าที่ต้นทุนต่ำและทนทานที่สุด จึงเป็นค่าเริ่มต้นที่ยอดเยี่ยมสำหรับการทดลอง
TREX กับ Qiskit
ที่นี่เราสร้าง circuit สองคิวบิตแบบง่าย ๆ และใช้ Estimator ประมาณค่าคาดหวังของ observable ที่ง่ายมาก คือ ZX ค่าคาดหวังในอุดมคติคือ 1 เราจะเปรียบเทียบค่าคาดหวังเมื่อใช้และไม่ใช้ TREX
# Import packages needed for using real quantum computers

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Session
import numpy as np

# --------- Configuration ----------

backend = service.backend("ibm_fez")  # adjust if needed
สร้าง quantum circuit แบบง่าย ๆ
qc = QuantumCircuit(2)
qc.x(0)
qc.h(0)
qc.cx(0, 1)
qc.h(0)
qc.barrier()
qc.draw("mpl")

Transpile circuit โดยใช้ pass manager
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend)

qc_t = pass_manager.run(qc)
นำ layout เดียวกันจากการ transpile ไปใช้กับ observable
# Observable: X on qubit 0, Z on qubit 1, ideal expectation value is 1.0.
observable = SparsePauliOp("ZX")
observable_t = observable.apply_layout(qc_t.layout)
รันการทดลองบนคอมพิวเตอร์ควอนตัมจริง ก่อนอื่นเราเริ่มด้วย reslience_level = 1 ซึ่งเป็นค่าเริ่มต้นอยู่แล้ว แต่เราระบุไว้ชัดเจนเพื่อแยกสองกรณีออกจากกัน
# First, we run this on an ideal simulator to confirm the ideal expectation value.

from qiskit.primitives import StatevectorEstimator as Estimator

estimator = Estimator()

job = estimator.run(pubs=[(qc, observable)])

res = job.result()
val = res[0].data.evs

print("⟨ZX⟩ ideal:", val)
⟨Z₀⟩ ideal: 0.9999999999999996
# This took 27 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ with TREX:", val)
⟨Z₀⟩ with TREX: 0.9520029143897996
ตอนนี้เราตั้ง resilience_level เป็น 0 เพื่อรันโดยไม่ใช้ TREX
# This took 12 sec on ibm_fez. Your runtime might differ.
with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ without TREX:", val)
⟨Z₀⟩ without TREX: 0.8651
ค่าคาดหวังเข้าใกล้ค่าอุดมคติ (1) มากขึ้นอย่างชัดเจนเมื่อใช้ TREX ตามที่คาดไว้ แน่นอนว่านี่เป็นเพียงค่าคาดหวังค่าเดียวบนคิวบิตเดียว ต่อไปเราจะเตรียม circuit ที่ใช้ gate แบบ non-Clifford และมีหลายคิวบิต เพื่อทดสอบว่าการปรับปรุงจาก TREX ยังคงทนทานในสภาพแวดล้อมที่ต่างออกไปหรือไม่
import numpy as np

num_qubits = 20
qc = QuantumCircuit(num_qubits)
for i in range(num_qubits):
    qc.rx(np.pi * 7 / 8, i)
qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=20, num_clbits=0, params=[]), qubits=(<Qubit register=(20, "q"), index=0>, <Qubit register=(20, "q"), index=1>, <Qubit register=(20, "q"), index=2>, <Qubit register=(20, "q"), index=3>, <Qubit register=(20, "q"), index=4>, <Qubit register=(20, "q"), index=5>, <Qubit register=(20, "q"), index=6>, <Qubit register=(20, "q"), index=7>, <Qubit register=(20, "q"), index=8>, <Qubit register=(20, "q"), index=9>, <Qubit register=(20, "q"), index=10>, <Qubit register=(20, "q"), index=11>, <Qubit register=(20, "q"), index=12>, <Qubit register=(20, "q"), index=13>, <Qubit register=(20, "q"), index=14>, <Qubit register=(20, "q"), index=15>, <Qubit register=(20, "q"), index=16>, <Qubit register=(20, "q"), index=17>, <Qubit register=(20, "q"), index=18>, <Qubit register=(20, "q"), index=19>), clbits=())
ตรงนี้ มุมหมุน ไม่ได้มีอะไรพิเศษ เราแค่เลือกซูเปอร์โพซิชันที่ไม่เท่ากันของ และ เพื่อตรวจสอบผลของการเปลี่ยนสถานะที่ผิดพลาดแบบไม่สมมาตร และดูว่า TREX จัดการกับมันอย่างไร จากสถานะนี้ ค่าคาดหวังในอุดมคติของ Z บนทุกคิวบิต เมื่อไม่มีข้อผิดพลาดใด ๆ (ทั้งการอ่านค่าและอื่น ๆ) จะเป็น:
ดังนั้นเราหวังว่าจะได้ค่าคาดหวังใกล้เคียง -0.924 บนทุกคิวบิต เราจะดูว่า TREX ช่วยปรับปรุงค่าคาดหวังแต่ละค่าหรือไม่ และช่วยปรับปรุงค่าเฉลี่ยของทุกคิวบิตด้วยหรือไม่
ตรวจสอบความเข้าใจของคุณ
ตรวจสอบค่าคาดหวังข้างต้นด้วยการคำนวณโดยตรง
คำตอบ
เรา transpile โดยใช้ pass manager
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend_real)

qc_t = pass_manager.run(qc)
ตอนนี้เราสร้าง observable หนึ่งตัวต่อหนึ่งคิวบิต เพื่อให้ประมาณค่าคาดหวัง ทั้งยี่สิบค่าได้ใน workflow เดียว นั่นคือ สำหรับคิวบิตที่ เราต้องการ observable ที่เป็นเอกลักษณ์ ทั้งหมด ยกเว้นที่ตำแหน่งที่ ซึ่งเราต้องการ อย่าลืมนำ layout ที่ transpile แล้วไปใช้กับ observable ของคุณด้วย
# Observables: Z on qubit i for all i.
observables = []
for i in range(num_qubits):
    obs_string = "I" * i + "Z" + "I" * (num_qubits - i - 1)
    obs = SparsePauliOp(obs_string)
    observables.append(obs)
observables_t = [obs.apply_layout(qc_t.layout) for obs in observables]
ตอนนี้เรารันได้แล้ว เซลล์โค้ดด้านล่างใช้ session mode ถ้าคุณไม่มีสิทธิ์ใช้ session คุณสามารถเปลี่ยนเป็น batch mode เพื่อรัน workflow เดียวกันได้ แต่อาจมีเวลารอคิวระหว่าง circuit
# This took 20 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX turned off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_no_trex = job.result()
    val_no_trex = res_no_trex[0].data.evs

print("⟨Z_i⟩ without TREX:", val_no_trex)
⟨Z_i⟩ without TREX: [-0.90645 -0.89755 -0.89125 -0.9165  -0.87655 -0.91035 -0.8757  -0.87905
 -0.66035 -0.8876  -0.87125 -0.89975 -0.83745 -0.89755 -0.82645 -0.90325
 -0.84385 -0.90195 -0.85865 -0.8884 ]
# This took 36 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_trex = job.result()
    val_trex = res_trex[0].data.evs

print("⟨Z_i⟩ with TREX:", val_trex)
⟨Z_i⟩ with TREX: [-0.92086303 -0.90253698 -0.91688854 -0.93308327 -0.91273953 -0.9221892
 -0.903782   -0.93046052 -0.90348934 -0.90284174 -0.89499677 -0.91630959
 -0.89508481 -0.92233292 -0.90497141 -0.91867138 -0.91421506 -0.91646851
 -0.9268364  -0.91669818]
ที่นี่เราเปรียบเทียบค่าคลาดเคลื่อนสัมบูรณ์เฉลี่ยเมื่อใช้และไม่ใช้ TREX
ideal = np.cos(7 * np.pi / 8)

mean_abs_error_no_trex = np.mean(np.abs(val_no_trex - ideal))
mean_abs_error_trex = np.mean(np.abs(val_trex - ideal))

print("The mean absolute error without TREX is: ", mean_abs_error_no_trex)
print("The mean absolute error with TREX is: ", mean_abs_error_trex)
The mean absolute error without TREX is:  0.05238453251128674
The mean absolute error with TREX is:  0.011980732757900719
zx = list(range(num_qubits))
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(zx, val_no_trex, c="blue", linestyle="-", label="No TREX", alpha=0.7)

## Add values with DD
ax.scatter(zx, val_trex, c="red", linestyle="-", label="With TREX", alpha=0.7)

# Add ideal reference line
ax.axhline(y=-0.924, color="black", linestyle="--", linewidth=2, label="Ideal ⟨Z⟩")

# Add labels and plot
ax.set_xlabel("Qubits")
ax.set_ylabel("<Z>")
ax.legend()
ax.set_title("<Z> in RX(7pi/8)|0> state with and without TREX")
ax.grid(True)

plt.show()
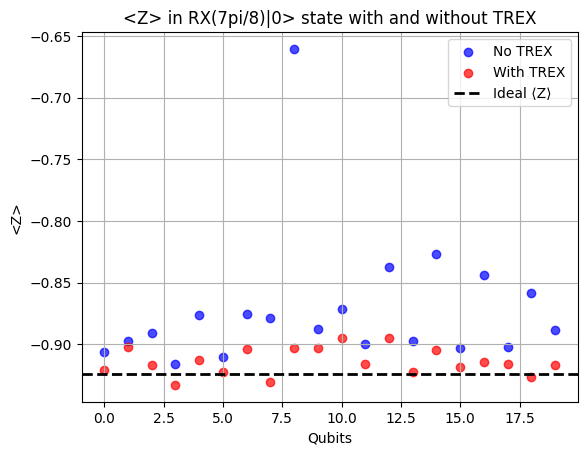
TREX ดูเหมือนจะช่วยได้จริง ค่าคาดหวังบนทุกคิวบิตดีขึ้น ยกเว้นคิวบิต 16 เพียงตัวเดียว ค่าที่หลุดจากกลุ่มแบบนี้เป็นเรื่องที่คาดไว้อยู่แล้ว เราสามารถวัดผลโดยรวมของการใช้ TREX กับ circuit ได้โดยหาค่าเฉลี่ย
mean_no_trex = sum(val_no_trex) / num_qubits
mean_trex = sum(val_trex) / num_qubits

print("Mean without TREX", mean_no_trex)
print("Mean with TREX", mean_trex)
Mean without TREX -0.8714950000000001
Mean with TREX -0.9137729590315635
โดยเฉลี่ยแล้ว TREX ทำให้ผลลัพธ์ของเราเข้าใกล้ผลลัพธ์ในอุดมคติมากขึ้นประมาณ 2.9% และเหลือผลลัพธ์ที่ต่างจากค่าอุดมคติเชิงทฤษฎีโดยเฉลี่ยเพียง 0.4% ซึ่งยอดเยี่ยม และการปรับปรุงที่โอเวอร์เฮดต่ำนี้เองคือเหตุผลที่ TREX เป็นการลดข้อผิดพลาดค่าเริ่มต้นของ Estimator แต่เราต้องย้ำอีกครั้งว่า TREX กำลังกำจัดความเอนเอียงของข้อผิดพลาดในการอ่านค่า ไม่ได้แก้ข้อผิดพลาดทั้งหมดของเรา เราเลือกสถานะเริ่มต้นที่มีโอกาสสูงที่จะได้รับผลจากความไม่สมมาตรของการอ่านค่า ผลจะต่างออกไปถ้าเราเตรียมแต่ละคิวบิตในสถานะที่ต่างกัน ลองพิจารณาเหตุผลง่าย ๆ ว่าทำไมต้องเป็นเช่นนั้น ถ้าเราปล่อยให้แต่ละคิวบิตอยู่ในสถานะพื้น จะไม่มีโอกาสสังเกต (หรือแก้ไข) ความไม่สมมาตรของข้อผิดพลาดในการอ่านค่าระหว่างสถานะ กับ เลย
Zero-noise extrapolation (ZNE)
Zero-noise extrapolation (ZNE) เป็นหนึ่งในเทคนิคลดข้อผิดพลาดที่ใช้กันอย่างแพร่หลายที่สุด กลยุทธ์โดยรวมก็เข้าใจง่าย แม้รายละเอียดการนำไปใช้จะซับซ้อน ZNE ทำงานโดย:
-
รัน circuit เป้าหมายที่ "ระดับสัญญาณรบกวน" หลายระดับ — คือการแก้ไข circuit ที่ทำให้สัญญาณรบกวนเพิ่มขึ้นในรูปแบบที่คาดเดาได้
-
ประมาณค่า observable ที่สนใจสำหรับแต่ละระดับสัญญาณรบกวน
-
extrapolate กลับไปที่สัญญาณรบกวนเป็นศูนย์โดยใช้โมเดลการฟิต (เชิงเส้น พหุนาม เอกซ์โพเนนเชียล และอื่น ๆ)
ผลลัพธ์คือค่าประมาณว่า observable จะเป็นเท่าใดในลิมิตที่ไม่มีสัญญาณรบกวนตามที่โมเดล extrapolation บ่งชี้
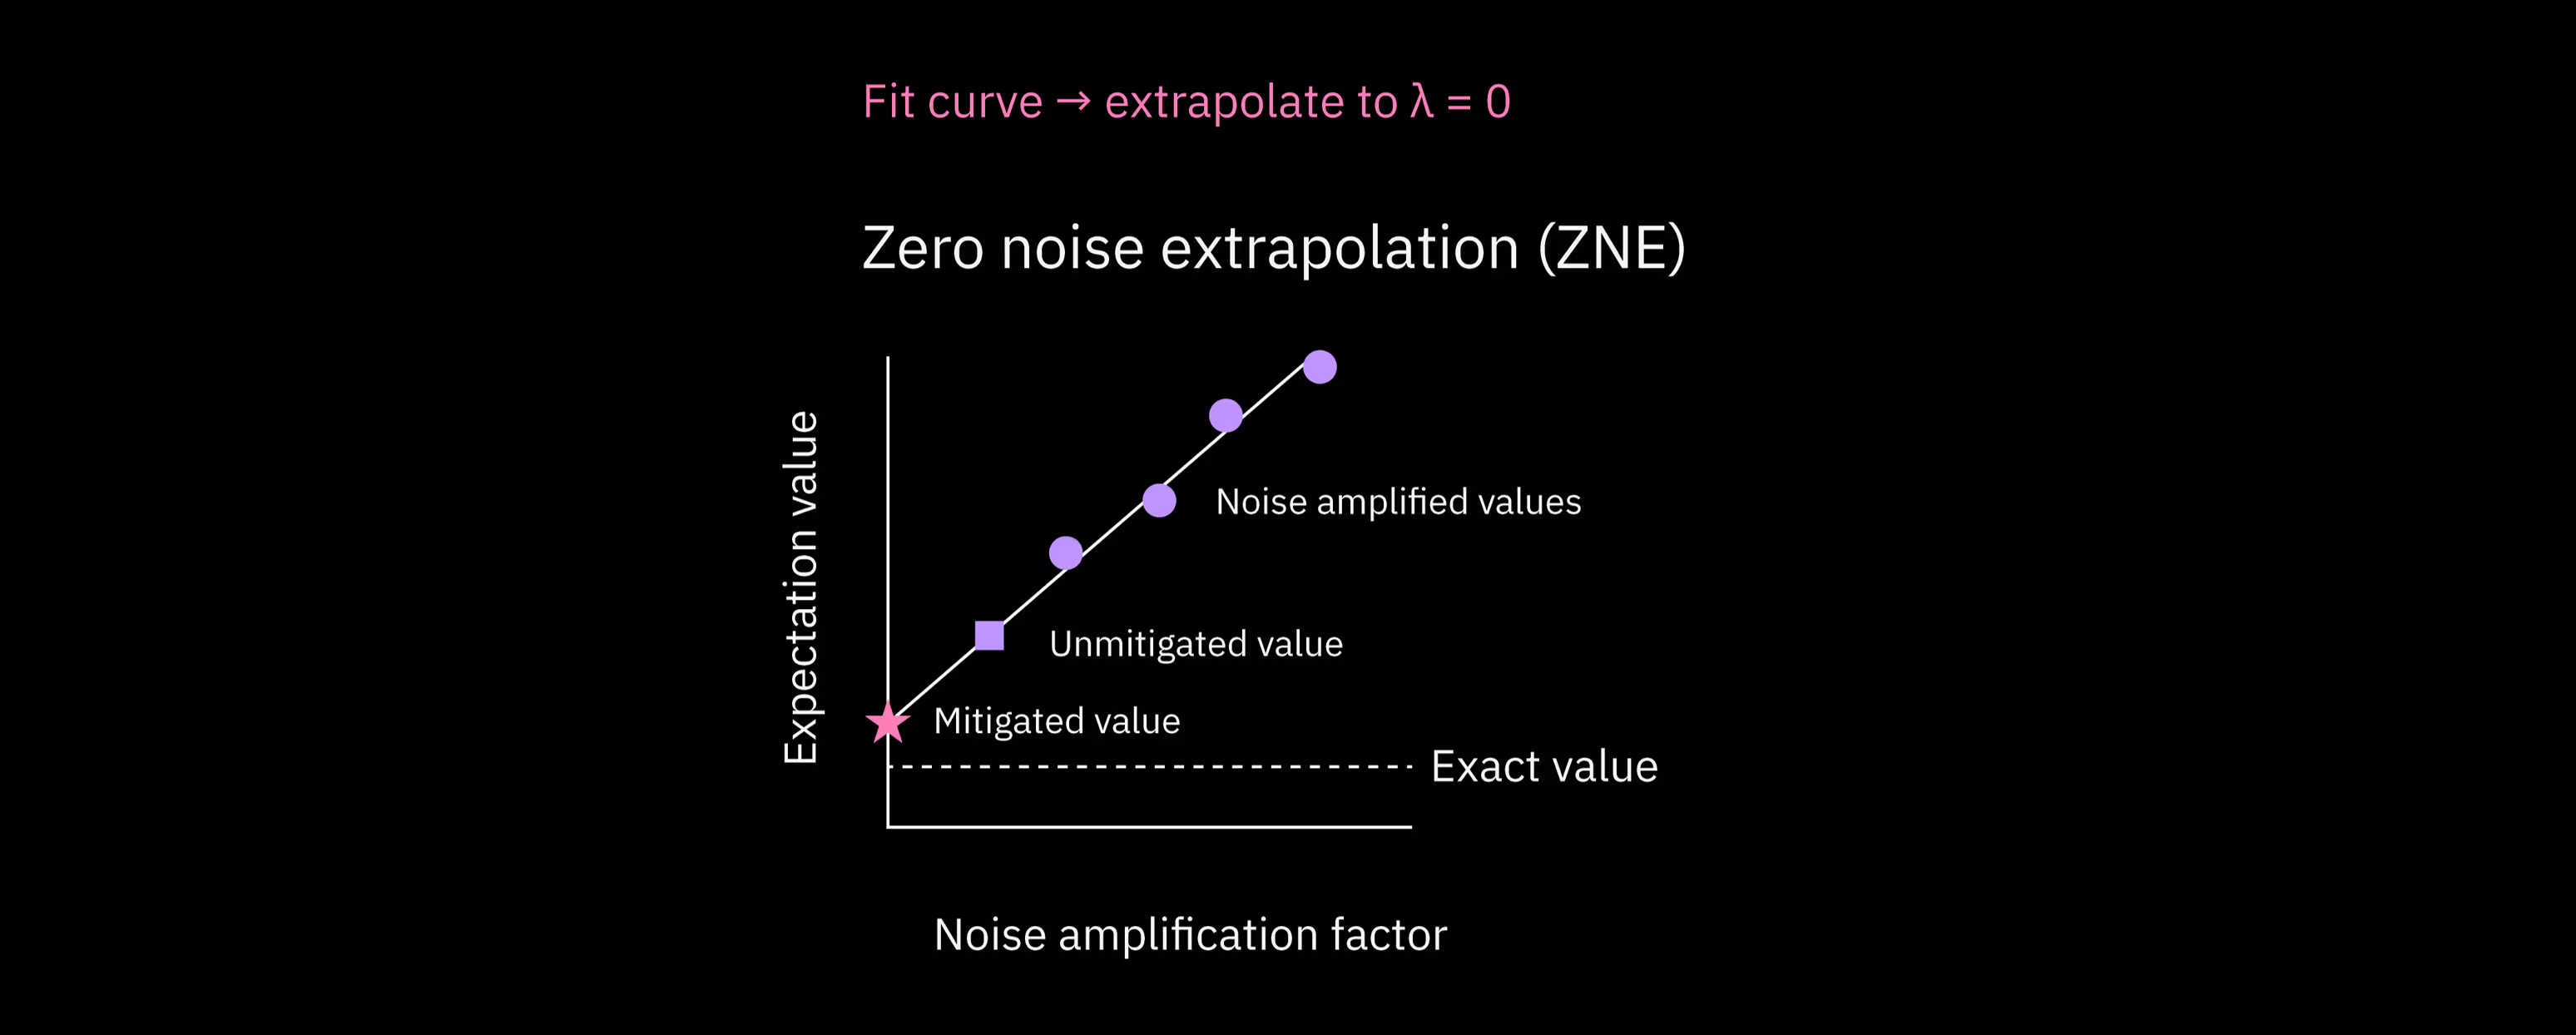
ZNE ไม่ได้รับประกันว่าสัญญาณรบกวนจะเพิ่มขึ้นอย่างราบรื่นหรือเป็นเชิงเส้นเมื่อเราแก้ไข circuit แต่มันสมมติว่าการเพิ่มสัญญาณรบกวนมีพฤติกรรมดีพอที่จะ extrapolate ได้ ความซับซ้อนของ ZNE อยู่ที่วิธีแก้ไข circuit ให้เป็นไปตามสมมติฐานนี้ให้ได้มากที่สุด เราจะดูบางแนวทางในบทเรียนนี้
การขยายทรัพยากรของ ZNE
ใน ZNE โอเวอร์เฮดส่วนใหญ่เป็นโอเวอร์เฮดเชิงควอนตัม นั่นคือ เพื่อให้ได้ค่าคาดหวังที่ ระดับสัญญาณรบกวน คุณต้องทำการทดลองกับ circuit โดยแต่ละอันมี shot จำนวนมาก เพื่อรักษาความแม่นยำทางสถิติให้คงที่ จำนวนตัวอย่างรวมมักเพิ่มขึ้นเมื่อเพิ่ม circuit ที่ปรับสัญญาณรบกวน
จำนวนระดับสัญญาณรบกวน ที่คุณตรวจสอบขึ้นอยู่กับวิธีที่ใช้ปรับสัญญาณรบกวน สำหรับเทคนิคปรับสัญญาณรบกวนแบบง่าย (เรียกว่า "gate-folding" ซึ่งจะกล่าวถึงด้านล่าง) มักอยู่ระหว่าง 3 ถึง 5 อีกวิธีหนึ่ง (probabilistic noise amplification (PNA)) รองรับตัวคูณสัญญาณรบกวนที่ไม่ใช่จำนวนเต็ม และมักให้ระดับสัญญาณรบกวนที่ต่ำกว่า gate-folding โอเวอร์เฮดรวมโดยประมาณเป็นดังนี้:
โดยที่ คือจำนวน shot พื้นฐาน อีกสิ่งที่ควรคำนึงถึงคือ ถ้าการปรับสัญญาณรบกวนเกี่ยวข้องกับการทำซ้ำ gate ความลึกของ circuit อาจเพิ่มขึ้นด้วยตัวคูณที่เป็นสัดส่วนกับค่าการปรับสัญญาณรบกวน การที่สัญญาณรบกวนเพิ่มขึ้นตามความลึกคือจุดประสงค์ แต่ก็ควรจับตาความลึกรวมไว้ด้วย
ZNE เหมาะกับปัญหาที่เข้าข่ายตามประเด็นต่อไปนี้:
-
คุณต้องการวิธีลดข้อผิดพลาดแบบอเนกประสงค์ที่ได้ผลกับข้อผิดพลาดหลายประเภท
-
ความลึกของ circuit ไม่มากเกินไป ZNE จะล้มเหลวเมื่อ circuit ที่ปรับสัญญาณรบกวนแล้วมีสัญญาณรบกวนมากเกินกว่าจะ extrapolate ได้
-
คุณยอมรับโอเวอร์เฮดด้านเวลารันในระดับปานกลางเพื่อแลกกับความแม่นยำที่ดีขึ้นได้
ในทางปฏิบัติ สิ่งนี้ทำให้ ZNE เหมาะกับ variational circuit จำนวนมาก การประมาณค่าคาดหวัง และอัลกอริทึมควอนตัมระยะใกล้อื่น ๆ มีการนำไปใช้ใน Estimator ด้วย resilience_level = 2 โปรดทราบว่า ZNE ทำการ extrapolate ในปริภูมิที่มีผลลัพธ์เดียวเป็นฟังก์ชันของสัญญาณรบกวนทั่วทั้ง circuit นั่นหมายความว่ามันเหมาะกับปัญหาการประมาณค่า แต่ไม่เหมาะกับปัญหาการสุ่มตัวอย่าง มันไม่ได้ออกแบบมาให้ใช้กับการแจกแจงของบิตสตริง
ตัวคูณสัญญาณรบกวน
เราจะเพิ่มระดับสัญญาณรบกวนใน circuit ได้อย่างไรกันแน่ มีสองวิธีหลัก แม้จะมีรูปแบบย่อยอีกมาก
-
แทนที่ gate หรือบล็อกของ gate ด้วย เนื่องจาก gate บนคอมพิวเตอร์ควอนตัมเป็น unitary เรารู้ว่า ดังนั้นในทางตรรกะ: อย่างไรก็ตาม การทำซ้ำ หรือ ทุกครั้งจะเพิ่มข้อผิดพลาดที่คล้ายหรือเหมือนกัน ทำให้เราเพิ่มระดับสัญญาณรบกวน/ข้อผิดพลาดได้ โปรดทราบว่าการแทนที่ข้างต้นพาเราจากสัญญาณรบกวนเดิมของ gate (ระดับสัญญาณรบกวน 1) ไปเป็นสามเท่าของระดับนั้นใน (ระดับสัญญาณรบกวน 3) ในทางปฏิบัติ เราทำซ้ำสอง gate สุดท้ายได้ ครั้ง: เพื่อให้ได้ระดับสัญญาณรบกวน วิธีนี้เรียกว่า gate folding และเป็นเทคนิคปรับสัญญาณรบกวนที่พบบ่อยมาก
-
ยังมีวิธีอื่นในการเพิ่มระดับสัญญาณรบกวน เช่น probabilistic error amplification (PEA) ใน PEA ก่อนอื่นเราเรียนรู้โมเดลสัญญาณรบกวนที่เหมาะสมสำหรับ circuit ซึ่งมักแสดงเป็น Pauli channel จากนั้นขยายสัญญาณรบกวนโดยสุ่มตัวอย่างจากช่องสัญญาณรบกวนที่เรียนรู้มาซึ่งถูกปรับสเกลใหม่ การปรับการสุ่มตัวอย่างทำให้คุณปรับความแรงของสัญญาณรบกวนที่มีผลได้อย่างต่อเนื่อง รวมถึงค่าที่ไม่ใช่จำนวนเต็ม
ในทางปฏิบัติ gate folding ปรับข้อผิดพลาดได้อย่างน่าเชื่อถือมาก แต่ก็อาจทำให้ circuit ลึกมากได้เช่นกัน ถ้าคุณต้องการแค่สามระดับสัญญาณรบกวน (1, 3 และ 5) นั่นหมายถึงต้องเพิ่มความลึกของ circuit เป็น 5 เท่า และยังต้องได้ผลลัพธ์ที่สมเหตุสมผล ดังนั้น ถ้า circuit เป้าหมายของคุณมีความลึกสองคิวบิตหลัง transpile ตั้งแต่ 60 ขึ้นไป PEA น่าจะเหมาะกว่า gate-folding
สามารถ fold gate ได้แบบเฉพาะที่ (คือทำซ้ำ สำหรับแต่ละ gate สองคิวบิตทันทีที่ปรากฏ) หรือจัดกลุ่มเป็นบล็อกของ gate แล้วทำซ้ำทั้งบล็อก (เช่น gate ) การ fold แบบเฉพาะที่มักเหมาะกับสมมติฐานของ ZNE มากกว่า แต่ทำได้ทั้งสองแบบ
มีรายละเอียดปลีกย่อยมากมายในการจัดการทางสถิติของผลลัพธ์ที่ปรับสัญญาณรบกวนใน ZNE ตัวอย่างเช่น ที่ระดับสัญญาณรบกวนห้าเท่า ผลลัพธ์ของคุณย่อมมีความแปรปรวนสูงกว่าและเชื่อถือได้น้อยกว่า ควรให้น้ำหนักเท่ากับจุดข้อมูลที่สัญญาณรบกวนต่ำกว่าหรือไม่ ไม่ควร อย่างไรก็ตาม เพื่อให้เห็นว่า ZNE ทำงานอย่างไร เราจะละความซับซ้อนส่วนนี้ไปบางส่วนในการทดลองโมเดลจำลองง่าย ๆ ซึ่งเราจะสร้าง circuit ที่ fold ด้วยมือ และทำ extrapolation แบบตรงไปตรงมาด้วยน้ำหนักเท่ากัน เพื่อแสดงขั้นตอนสำคัญ แต่หลังจากนั้นเราจะทำการทดลองโดยใช้ฟังก์ชัน ZNE ที่มีมาใน Qiskit และเราจะเห็นว่ามันจัดการกับความซับซ้อนที่เราข้ามไปได้ดีกว่ามาก
ZNE ด้วยมือ
เราเริ่มด้วยการเลือก quantum circuit และ observable ที่เราคำนวณค่าคาดหวังในอุดมคติเมื่อไม่มีสัญญาณรบกวนและข้อผิดพลาดได้ เราเลือกสถานะ GHZ ที่มีจำนวนคิวบิตเป็นเลขคู่ observable ของเราคือ เราเลือกสิ่งนี้ด้วยเหตุผลหลายประการ:
- ค่าคาดหวัง คำนวณได้ง่ายมากในกรณีอุดมคติ เพราะจำนวนคิวบิตเป็นเลขคู่ เราจะได้
1จากทุก คูณกัน หรือได้-1จากทุก คูณกันเป็นจำนวนคู่ครั้ง - สิ่งนี้จะค่อนข้างไวต่อข้อผิดพลาดและสัญญาณรบกวน เพราะข้อผิดพลาดเพียงครั้งเดียวบนหนึ่งคิวบิตก็พลิกผลลัพธ์โดยรวมของ shot นั้นจาก +1 เป็น -1 ได้
- ค่าคาดหวังอยู่ห่างจาก 0 ZNE อาจประสบปัญหาเมื่อค่าคาดหวังในอุดมคติใกล้ศูนย์มาก เพราะระดับสัญญาณรบกวนสูงมักทำให้ผลลัพธ์สุ่ม ทำให้เป็นบวกบ่อยพอ ๆ กับเป็นลบ ผลคือค่าสัญญาณรบกวนสูงจะให้ค่าใกล้ค่าอุดมคติ ซึ่งทำให้ extrapolation ยากมาก
เมื่อมีแรงจูงใจนี้ในใจ เรามาสร้าง circuit ของเรากัน
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
num_qubits = 10  # must be even

# # Noise amplification factors used for folding (2* integer +1 for gate folding)
noise_steps = [1, 3, 5]
ghz_amp = []

for j in noise_steps:
    qc = QuantumCircuit(num_qubits)
    qc.h(0)
    # Since CX^2 = I, odd repetitions implement folded versions of the gate.
    for i in range(num_qubits - 1):
        for gates in range(j):
            qc.cx(i, i + 1)
    qc.barrier()
    ghz_amp.append(qc)
โปรดสังเกตความละเอียดอ่อนที่ตรงนี้ แม้ว่า gate folding จะถูกอธิบายว่าประกอบด้วยตัวดำเนินการในรูป แต่ที่นี่โครงสร้างเดียวกันนั้นดูเหมือน CNOT CNOT CNOT
มาตรวจสอบให้แน่ใจว่า circuit ลำดับที่ ของเราเป็น circuit GHZ ปกติจริง ๆ:
ghz_amp[0].draw("mpl")
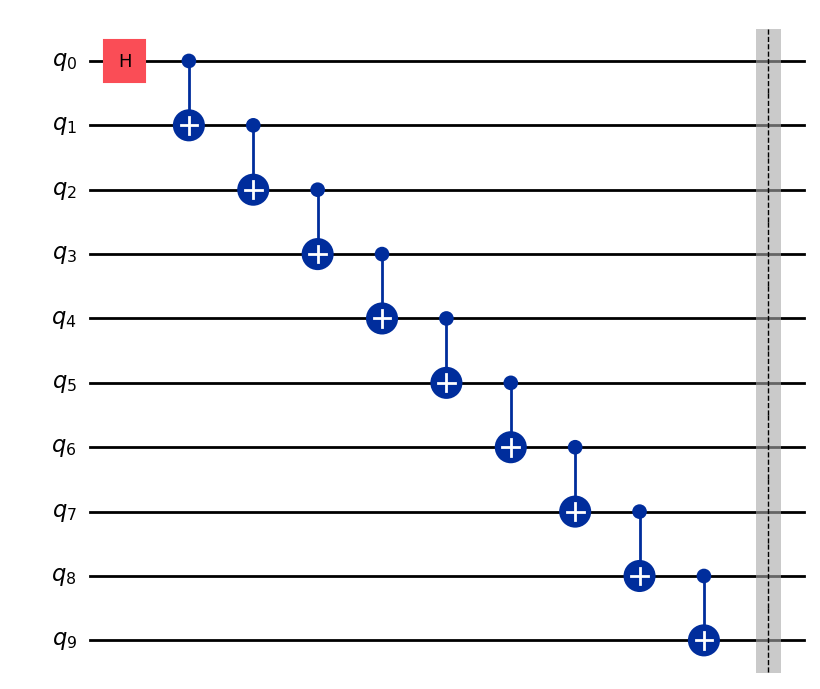
คุณสามารถดู circuit อื่น ๆ เพื่อตรวจสอบว่ามีโครงสร้างตามที่คาดไว้
ตอนนี้เราสร้าง observable ของเรา
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
observables = []
for j in range(len(noise_steps)):
    observables.append(observable)
เราสร้าง pass manager และนำไปใช้กับ circuit ของเรา จากนั้นนำ layout ไปใช้กับ observable ของเรา
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=0,
)

qcs_transpiled = []
obs_transpiled = []

for j in range(len(ghz_amp)):
    # Transpile the circuit
    qc_pm = pm.run(ghz_amp[j])
    qcs_transpiled.append(qc_pm)
    # Extract the final layout
    layout = qc_pm.layout
    # Apply the layout to the observable
    obs_transpiled.append(observable.apply_layout(layout))
จัดรูปแบบ pubs
pubs = [(qc, obs) for qc, obs in zip(qcs_transpiled, obs_transpiled)]
ตอนนี้เรารัน Estimator เราอยากเน้นที่บทบาทของ ZNE ดังนั้นเราอาจอยากตั้ง resilience_level = 0 เพื่อไม่ให้ผลของ twirling ปนกับผลของ ZNE อย่างไรก็ตาม เรายังอยากเปรียบเทียบ ZNE "ด้วยมือ" ของเรากับการตั้งค่า ZNE ที่มีมาใน Qiskit ซึ่งรวม twirling ด้วย เราจึงตั้ง resilience_level = 1 ที่นี่ การตั้ง resilience_level = 2 จะเรียกใช้การตั้งค่า ZNE ของ Qiskit ซึ่งเราจะใช้ในไม่ช้า
# This took 21 sec on ibm_fez. Your actual runtime might vary.
options = EstimatorOptions(resilience_level=1)

estimator = Estimator(
    mode=backend_real,
    options=options,
)

job = estimator.run(pubs)

res = job.result()
ตอนนี้เราพิมพ์ระดับสัญญาณรบกวนและค่าคาดหวังออกมา
# We save this for later comparisons
value_no_zne = res[0].data.evs

# Print all values used for extrapolation
print("Noise level 1: ", res[0].data.evs)
print("Noise level 3: ", res[1].data.evs)
print("Noise level 5: ", res[2].data.evs)
Noise level 1:  0.8327970939283861
Noise level 3:  0.5612869745718734
Noise level 5:  0.3130254281266217
นี่คือส่วนที่เราทำแบบสบาย ๆ ที่สุด: เราทำการฟิตเชิงเส้นกับข้อมูลเหล่านี้โดยไม่สนใจความแปรปรวนของแต่ละค่าที่ได้ และไม่ได้พยายามทำนายในเชิงทฤษฎีว่าการฟิตต้องเป็นเชิงเส้นหรือไม่ ขอย้ำอีกครั้งว่า ZNE ที่มีมาในตัวทำได้ดีกว่าสิ่งที่เราทำด้วยมือมาก
# Data
noise_factors = np.array([1, 3, 5])
values = np.array([res[0].data.evs, res[1].data.evs, res[2].data.evs])

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.12994291645044112
Zero-noise extrapolated value: 0.9588652482269501
เราลงมือพล็อตก่อนจะตีความ
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Zero-noise estimate")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
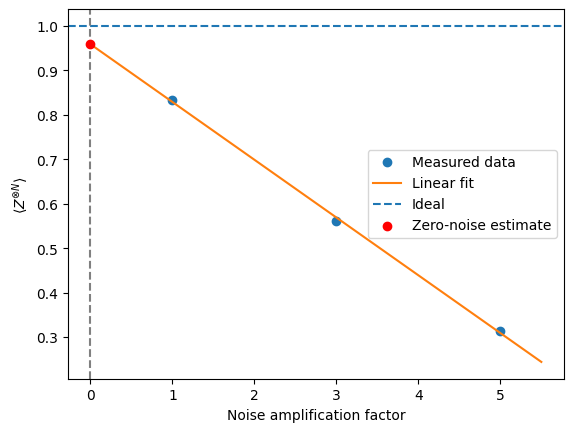
ขณะจัดทำบทเรียนนี้ จากการ extrapolate ไปยังกรณีไม่มีสัญญาณรบกวน เราได้ค่าคาดหวัง 0.959 ค่าของคุณอาจต่างออกไป ซึ่งดีกว่าค่าคาดหวังของ circuit ดิบที่ 0.83 อย่างมาก คือเข้าใกล้ค่าอุดมคติมากขึ้นราว 13% แต่คุณก็เห็นได้ว่าเราใช้จุดข้อมูลหนึ่งที่ค่าคาดหวังต่ำถึง 0.31 เห็นได้ชัดว่าจุดข้อมูลนี้คุณภาพต่ำกว่า ถ้าจุดนั้นได้น้ำหนักต่ำลงในการประมาณเชิงเส้นของเรา และเส้นตรงถูกฟิตให้เข้ากับสองจุดแรกมากขึ้น เราจะเห็นว่าค่าประมาณที่ extrapolate ไปศูนย์จะสูงกว่า (ใกล้ค่าอุดมคติมากกว่า) การพิจารณาเช่นนี้ถูกจัดการโดยอัตโนมัติใน ZNE ที่มีมาใน Estimator
ZNE ที่มีมาใน Estimator
ตอนนี้มาดูกันว่าจะเกิดอะไรขึ้นเมื่อเราใช้ฟังก์ชัน ZNE ที่มีมาใน Estimator เราเริ่มด้วยการกำหนด circuit GHZ แบบง่าย ๆ โดยไม่มี gate folding
num_qubits = 10  # must be even

qc = QuantumCircuit(num_qubits)
qc.h(0)

for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=10, num_clbits=0, params=[]), qubits=(<Qubit register=(10, "q"), index=0>, <Qubit register=(10, "q"), index=1>, <Qubit register=(10, "q"), index=2>, <Qubit register=(10, "q"), index=3>, <Qubit register=(10, "q"), index=4>, <Qubit register=(10, "q"), index=5>, <Qubit register=(10, "q"), index=6>, <Qubit register=(10, "q"), index=7>, <Qubit register=(10, "q"), index=8>, <Qubit register=(10, "q"), index=9>), clbits=())
เรากำหนด observable เดียวกับก่อนหน้านี้
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
เรากำหนด pass manager อีกครั้ง โดยใช้ optimization_level = 1 เราจะกลับมาที่ตัวเลือกนี้ด้านล่าง
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)
Transpile circuit และนำ layout ไปใช้กับ observable
# Transpile the circuit
qc_transpiled = pm.run(qc)

# Extract the final layout
layout = qc_transpiled.layout

# Apply the layout to the observable
obs_transpiled = observable.apply_layout(layout)
เรารัน Estimator โดยใช้ ZNE และ twirling และเปรียบเทียบผลลัพธ์กับการนำ ZNE ด้วยมือของเรา โดยเฉพาะอย่างยิ่ง เราเปรียบเทียบกับผลลัพธ์ที่ไม่ใช้ ZNE (value_no_zne)
# This used 18 sec on ibm_fez. Your actual QPU time might vary.

options_zne = {
    "resilience_level": 2,
    "resilience": {
        "zne": {
            "noise_factors": [1, 3, 5],
        }
    },
    "twirling": {
        "enable_gates": True,
        "enable_measure": True,
        "num_randomizations": "auto",
    },
}

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
เราดึงค่าที่แต่ละตัวคูณสัญญาณรบกวนได้ด้วยไวยากรณ์ job_zne.result()[0].data.evs_noise_factors เหมือนก่อนหน้านี้ เราสามารถใช้ผลลัพธ์เหล่านี้แบบตรงไปตรงมาเพื่อฟิตเชิงเส้นและ extrapolate ไปกรณีไม่มีสัญญาณรบกวนได้ แต่ estimator ที่ใช้ resilience_level = 2 ทำได้ดีกว่าแล้ว โดยคำนึงถึงความแปรปรวนและปัจจัยอื่น ๆ ด้านล่างเราแสดงสิ่งที่การ extrapolate เชิงเส้นจะให้ และสิ่งที่ ZNE ที่มีมาในตัวให้จริง ๆ
# Data
noise_factors = np.array([1, 3, 5])
values_qiskit_zne = np.array(job_zne.result()[0].data.evs_noise_factors)

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values_qiskit_zne, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.11745451044574956
Zero-noise extrapolated value: 0.9045922788100509
print("Exp val ideal: 1.0")
print("Exp val with no ZNE: ", value_no_zne)
print("Exp val with ZNE: ", value_zne)
print("Fractional improvement: ", (value_zne - value_no_zne) * 100 / 1.0, "%")
Exp val ideal: 1.0
Exp val with no ZNE:  0.8327970939283861
Exp val with ZNE:  0.9877508802932561
Fractional improvement:  15.495378636487 %
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Linear")
plt.scatter(0, value_zne, color="black", zorder=3, label="Proper ZNE")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
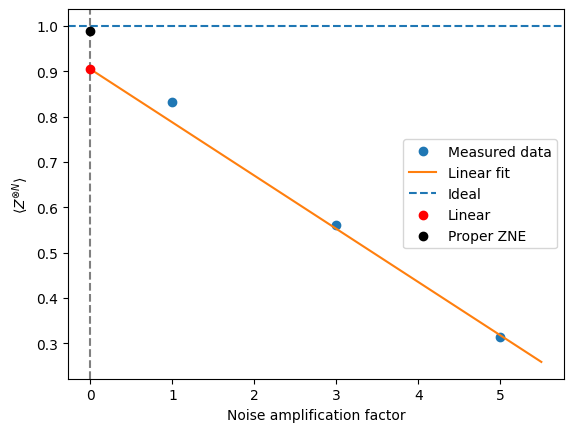
เราเห็นว่า ZNE ที่มีมาในตัวช่วยปรับปรุงค่าประมาณของเราได้มากกว่า 15% และทำได้ดีกว่าความพยายามด้วยมือของเราพอสมควร
ก่อนไปต่อ โปรดทราบว่าตลอดการสำรวจ ZNE นี้ เราตั้ง optimization_level = 1 ใน pass manager ระดับการปรับให้เหมาะสมที่สูงขึ้นช่วยลดข้อผิดพลาด และบางครั้งการลดข้อผิดพลาดนั้นอาจทำให้ข้อผิดพลาดปรับขนาดได้คาดเดายากขึ้น เช่นเดียวกับหลายกรณี มีจุดสมดุล: ลดข้อผิดพลาด ยกเว้นเมื่อเราตั้งใจเพิ่มมันด้วยตัวคูณที่ทราบ
การรวมวิธีต่าง ๆ
ZNE อาศัยสิ่งต่อไปนี้:
-
พารามิเตอร์ปรับสัญญาณรบกวน ที่นิยามไว้ชัดเจน
-
การเปลี่ยนแปลงของค่าคาดหวังตาม ที่ราบเรียบและคาดเดาได้พอสมควร
-
ช่องสัญญาณรบกวนที่มีผลเดียวกัน ที่ความแรงต่างกัน
-
ไม่มีความเอนเอียงที่ไม่เปลี่ยนตาม เข้ามา
ZNE ใช้ร่วมกับเทคนิคที่กำจัดความเอนเอียงที่ไม่ปรับตามสเกล (เช่น M3) หรือทำให้สัญญาณรบกวนสม่ำเสมอขึ้น (เช่น twirling) ได้อย่างลงตัว แต่ขัดแย้งกับเทคนิคที่พยายามหักล้างสัญญาณรบกวนทั้งหมด (PEC) หรือปรับรูปร่างมันแบบไดนามิก (DD)
โดยเฉพาะอย่างยิ่ง M3 จัดการเฉพาะข้อผิดพลาดการวัด/การอ่านค่า ซึ่งในทางปฏิบัติถือเป็นอิสระจากข้อผิดพลาดของ gate ได้ (ซึ่งเป็นจุดเน้นของกระบวนการปรับสเกลข้อผิดพลาดใน ZNE) M3 แทบไม่ขึ้นกับ gate folding จึงรวมกับ ZNE ได้อย่างลงตัว TREX ก็คล้ายกันมาก และรวมกับ ZNE ได้
Pauli twirling เน้นที่ gate ต่างจาก M3 และ TREX อย่างไรก็ตาม โปรดจำไว้ว่า Pauli twirling ไม่ได้ลดข้อผิดพลาด/สัญญาณรบกวนโดยตรง แต่เปลี่ยนมันให้คาดเดาได้ง่ายขึ้น Pauli twirling อาจเป็นประโยชน์ต่อกระบวนการ ZNE โดยทำให้ข้อผิดพลาดของ gate ปรับสเกลเป็นเชิงเส้นมากขึ้น และทำให้ extrapolation แม่นยำขึ้น
Dynamical decoupling (DD) ซับซ้อนกว่า DD เปลี่ยนพฤติกรรมของสัญญาณรบกวนแบบไดนามิกโดยหักล้างข้อผิดพลาดบางอย่างบางส่วนด้วยการเพิ่มลำดับ gate ถ้าสร้าง circuit ให้ DD ทำงานเหมือนเดิมแม้เมื่อ fold gate หรือบล็อกได้ ในหลักการก็รวม ZNE กับ DD ได้ แต่ในทางปฏิบัติ DD บางครั้งรบกวนการปรับสเกล ถ้าคุณต้องการรวมทั้งสอง สิ่งที่ควรพิจารณามีดังนี้:
- DD ถูกใช้อย่างสม่ำเสมอที่ทุกระดับสัญญาณรบกวนหรือไม่
- การ fold รักษาโครงสร้าง DD ไว้หรือไม่
- การปรับสเกลสัญญาณรบกวนที่ได้ยังมีพฤติกรรมเป็นแบบ monotonic หรือไม่
วิธีลดข้อผิดพลาดสุดท้ายที่เราจะพูดถึงเป็นแนวทางเดี่ยวนั้นใช้ร่วมกับ ZNE ไม่ได้ คือ probabilistic error cancellation
Probabilistic Error Cancellation (PEC)
ต่างจาก ZNE หรือการลดข้อผิดพลาดการวัด PEC พยายามหักล้างสัญญาณรบกวนที่ระดับ gate โดยสร้างช่องสัญญาณในอุดมคติขึ้นใหม่ในเชิงค่าคาดหวัง Probabilistic Error Cancellation (PEC) เป็นเทคนิคลดข้อผิดพลาดที่ทรงพลังและแพงที่สุดที่ครอบคลุมในบทเรียนนี้ PEC สร้างขึ้นจากการผกผันช่องสัญญาณรบกวนอย่างชัดเจน ซึ่งทำในเชิงสถิติแทนที่จะทำในเชิงกายภาพ PEC ทำงานโดย:
-
ระบุลักษณะโมเดลสัญญาณรบกวนในรูปของฐานของ "การดำเนินการข้อผิดพลาด"
-
แสดงตัวผกผันของช่องสัญญาณรบกวนเป็นการแจกแจง quasi-probability เหนือการดำเนินการทางกายภาพ
-
สุ่มตัวอย่างจากการแจกแจงนี้ระหว่างการรัน circuit เพื่อสร้างค่าประมาณแบบไม่เอนเอียงของการคำนวณในอุดมคติเชิงสถิติ
ในเชิงแนวคิด PEC เหมือนการแก้ข้อผิดพลาดเสมือน — มัน "ยกเลิก" สัญญาณรบกวนโดยรวมการดำเนินการที่มีสัญญาณรบกวนในรูปแบบสุ่มที่ถ่วงน้ำหนักอย่างระมัดระวัง แต่ในเชิงกระบวนการ PEC ไม่ได้เกี่ยวข้องกับการแก้ไขหรือตรวจจับข้อผิดพลาดโดยตรง การประมาณค่าคาดหวังในอุดมคติที่ไร้สัญญาณรบกวนแบบไม่เอนเอียงของ PEC แลกมาด้วยโอเวอร์เฮดการสุ่มตัวอย่างที่สูงมากและการพึ่งพาการระบุลักษณะสัญญาณรบกวนที่แม่นยำอย่างมาก
บนคอมพิวเตอร์ควอนตัมของ IBM PEC ควรมองเป็นเครื่องมือความแม่นยำสูงมากกว่าชั้นการลดข้อผิดพลาดแบบอเนกประสงค์ เหมาะที่สุดกับ circuit ขนาดเล็กหรือส่วนเล็ก ๆ ของ circuit ขนาดใหญ่ งาน benchmarking และการศึกษาที่ต้องการความแม่นยำสูงซึ่งยอมรับโอเวอร์เฮดเชิงควอนตัมสูงได้
การระบุลักษณะช่องสัญญาณรบกวน
ใน PEC แต่ละ gate ในอุดมคติของ quantum circuit ถูกจำลองเป็น ช่อง unitary ในอุดมคติ ตามด้วยกระบวนการสัญญาณรบกวน ให้ แทน density matrix ของสถานะควอนตัม gate ในอุดมคติแทนด้วยเมทริกซ์ unitary ซึ่งก่อให้เกิดช่องควอนตัม:
บนฮาร์ดแวร์จริง วิวัฒนาการในอุดมคตินี้ถูกสัญญาณรบกวนทำให้เสียหาย เราจำลองการทำงานจริงทางกายภาพของ gate เป็น ช่องมีสัญญาณรบกวนที่มีผล:
โดยที่ คือช่องสัญญาณรบกวนที่จับข้อผิดพลาดเชิงสุ่มที่เกี่ยวข้องกับ gate ตลอดการอภิปรายนี้ , และ เป็นการส่งเชิงเส้นที่กระทำกับตัวดำเนินการความหนาแน่น ช่องในอุดมคติ เป็น unitary และย้อนกลับได้ ในขณะที่ช่องสัญญาณรบกวน (และดังนั้น ด้วย) เป็นการส่งแบบ completely positive, trace-preserving (CPTP)
PEC สมมติว่าช่องสัญญาณรบกวน เป็นที่ทราบหรือทราบโดยประมาณ บนฮาร์ดแวร์ IBM Quantum ข้อมูลนี้มักได้จากข้อมูลการสอบเทียบอุปกรณ์ อัตราข้อผิดพลาดที่อนุมานจากการทดลอง benchmarking และโมเดลสัญญาณรบกวนแบบง่าย เช่นการประมาณแบบ Pauli หรือ depolarizing สำหรับเซต gate ขนาดเล็ก แม้ PEC ไม่ต้องการโมเดลสัญญาณรบกวนที่แม่นยำสมบูรณ์ แต่ประสิทธิภาพจะลดลงอย่างรวดเร็วเมื่อช่องสัญญาณรบกวนที่สมมติเบี่ยงเบนจากพฤติกรรมจริงของฮาร์ดแวร์
การแยกส่วนแบบ quasi-probability ของช่องสัญญาณรบกวนผกผัน
แนวคิดหลักของ PEC คือ หักล้างผลของสัญญาณรบกวนในเชิงค่าคาดหวัง โดยสร้างค่าประมาณเชิงสุ่มของตัวผกผันของช่องสัญญาณรบกวน อย่างเป็นทางการ เป้าหมายคือใช้การส่งเชิงเส้นที่ยกเลิก ได้โดยประมาณ ดังนี้:
ในเชิงค่าคาดหวังจากการรัน circuit หลายครั้ง
ตัวผกผัน ในที่นี้นิยามเป็นตัวผกผันเชิงพีชคณิตของ ที่ถือเป็นซูเปอร์ตัวดำเนินการเชิงเส้นที่กระทำกับตัวดำเนินการ ตัวผกผันนี้มีอยู่เฉพาะเมื่อ มีแรงก์เต็ม กระบวนการสัญญาณรบกวนที่ไม่มีตัวผกผันไม่สามารถลดด้วย PEC ได้อย่างแม่นยำ
เมื่อสามารถผกผันได้ PEC แสดงช่องสัญญาณรบกวนผกผันเป็น ผลรวมเชิงเส้นของการดำเนินการที่นำไปใช้ได้จริงทางกายภาพ:
ที่นี่ แต่ละ คือการดำเนินการที่มีสัญญาณรบกวนซึ่งรันบนฮาร์ดแวร์ได้ (โดยทั่วไปเป็น native gate หรือลำดับ gate สั้น ๆ) และสัมประสิทธิ์จริง เป็น การแจกแจง quasi-probability ต่างจากความน่าจะเป็นทั่วไป สัมประสิทธิ์ อาจเป็นลบหรือเกิน 1 ได้
norm ของ quasi-probability:
บอกปริมาณต้นทุนของการผกผันสัญญาณรบกวน สำหรับช่องสัญญาณรบกวนที่ไม่ธรรมดาใด ๆ บนฮาร์ดแวร์ IBM Quantum การแยกส่วนนี้มักทำ:
- ต่อ gate หรือต่อเซต gate ขนาดเล็ก
- โดยสมมติโมเดลสัญญาณรบกวนที่จำกัด (มักเป็นการประมาณแบบ Pauli-diagonal)
- โดยใช้การดำเนินการ native เฉพาะ backend และข้อจำกัดการจัดตาราง
การสร้างวงจรในอุดมคติขึ้นใหม่ด้วย Monte Carlo
เพื่อประมาณค่าคาดหวังของ observable PEC ใช้การสุ่มตัวอย่างแบบ Monte Carlo ตามการแยกส่วนข้างต้น สำหรับแต่ละครั้งที่ gate ที่มีสัญญาณรบกวนปรากฏใน circuit จะใช้ขั้นตอนต่อไปนี้:
-
สุ่มเลือกการดำเนินการ ด้วยความน่าจะเป็น:
-
กำหนดน้ำหนักแบบคลาสสิก:
-
รัน circuit สุ่มที่มีสัญญาณรบกวนที่ได้บน backend ควอนตัม
-
คูณผลลัพธ์ที่วัดได้ด้วยผลคูณของน้ำหนักสะสมทั้งหมด
-
หาค่าเฉลี่ยของผลลัพธ์ที่ถ่วงน้ำหนักจากการรัน circuit หลายครั้ง
ตัวประมาณค่า ที่ได้สอดคล้องกับ
โดยมีเงื่อนไขว่าโมเดลสัญญาณรบกวน อธิบายฮาร์ดแวร์ได้อย่างแม่นยำ ดังนั้น PEC จึง ไม่ก่อให้เกิดความเอนเอียงเชิงระบบ ในเชิงค่าคาดหวัง แต่แลกความเอนเอียงกับ ความแปรปรวนทางสถิติที่มาก การรันแต่ละครั้งให้ค่าประมาณที่มีสัญญาณรบกวนแต่ถ่วงน้ำหนัก และต้องเฉลี่ยการรันหลายครั้งเท่านั้นจึงจะได้ค่าคาดหวังในอุดมคติ
การตีความเชิงแนวคิด
บางครั้ง PEC ถูกอธิบายว่าเป็น การแก้ข้อผิดพลาดเสมือน แม้การอธิบายเช่นนี้จะไม่ผิดทั้งหมด แต่ก็ไม่ควรสับสนกับการแก้ข้อผิดพลาดควอนตัมที่แท้จริง PEC ไม่มีการเข้ารหัสเชิงตรรกะ ไม่มีการดึง syndrome และไม่มีฟีดแบ็กแบบเรียลไทม์ ข้อผิดพลาดไม่ได้ถูกป้องกันหรือแก้ไขระหว่างการรัน circuit
แต่ PEC หักล้างสัญญาณรบกวน เชิงสถิติ โดยรวมการสร้างจริงของ circuit ที่มีสัญญาณรบกวนจำนวนมากด้วยน้ำหนักคลาสสิกที่มีเครื่องหมาย ทำให้ข้อผิดพลาดหักล้างกันหลังการประมวลผลแบบคลาสสิกเท่านั้น ข้อมูลไม่ได้รับการปกป้องระหว่างการรัน ผลลัพธ์ในอุดมคติถูกสร้างขึ้นใหม่ภายหลัง
การขยายทรัพยากรและต้นทุน
ต้นทุนหลักของ PEC มาจากการขยายความแปรปรวน ความแปรปรวนของตัวประมาณค่า PEC ปรับสเกลดังนี้:
ซึ่งหมายความว่า:
การปรับสเกลนี้เป็นพื้นฐานและไม่สามารถปรับปรุงได้ด้วยการประมวลผลแบบคลาสสิกภายหลัง
สำหรับ circuit ที่มี gate ที่มีสัญญาณรบกวนจำนวนมาก แต่ละ gate ให้ปัจจัย ทำให้ quasi-probability norm รวมเพิ่มขึ้นโดยประมาณแบบคูณ:
โดยที่ คือความลึกของ circuit บนฮาร์ดแวร์ IBM Quantum สิ่งนี้มักนำไปสู่การเติบโตแบบเอกซ์โพเนนเชียลของต้นทุนการสุ่มตัวอย่างตามความลึกของ circuit โดยไวต่อข้อผิดพลาดของ gate สองคิวบิตเป็นพิเศษ การปรับสเกลนี้กำหนดขีดจำกัดเชิงปฏิบัติต่อการใช้ PEC
ปัจจุบัน PEC ใช้งานได้จริงเมื่อเข้าเงื่อนไขข้อใดข้อหนึ่งหรือทั้งหมดต่อไปนี้เท่านั้น:
-
Circuit เล็กมากหรือตื้น (มักมี gate ตัว)
-
โมเดลสัญญาณรบกวนเรียบง่ายและผ่านการตรวจสอบมาอย่างดี (เช่น สัญญาณรบกวนแบบ Pauli)
-
ยอมรับต้นทุนทางสถิติที่สูงได้
-
เป้าหมายคือความแม่นยำ ไม่ใช่ throughput
ด้วยเหตุนี้ PEC จึงมักถูกใช้กับ:
-
Subcircuit ที่แยกออกมาภายใน workflow ที่ใหญ่กว่า
-
ขั้นตอนวิวัฒนาการช่วงเวลาสั้น
-
รูทีนการเตรียมสถานะหรือการวัด
-
การทดลอง benchmarking และการตรวจสอบความถูกต้อง
ซอฟต์แวร์สแตกของ IBM (IBM Quantum Compute และเครื่องมือลดข้อผิดพลาด) สะท้อนเรื่องนี้โดยถือว่า PEC เป็นตัวเลือกเฉพาะทาง ไม่ใช่ชั้นการลดข้อผิดพลาดค่าเริ่มต้น
กรณีใช้งาน PEC ทั่วไปได้แก่:
-
การทำ benchmarking ความแม่นยำของฮาร์ดแวร์ควอนตัม
-
การตรวจสอบความถูกต้องของอัลกอริทึมควอนตัมขนาดเล็ก
-
เคมีควอนตัมที่แม่นยำสูงบนระบบที่ลดขนาดแล้ว
-
การตรวจสอบไขว้กับ ZNE หรือวิธีลดสัญญาณรบกวนอื่น ๆ
ความสัมพันธ์ของ PEC กับวิธีลดสัญญาณรบกวนอื่น ๆ
เทคนิคลดสัญญาณรบกวนอื่น ๆ หลายตัวยอมแลกความแม่นยำเพื่อให้ขยายขนาดได้ แต่ PEC ทำตรงกันข้าม คือมุ่งเน้นความแม่นยำเหนือสิ่งอื่นใด
เนื่องจาก PEC อาจใช้กับ subcircuit เท่านั้น จึงสำคัญเป็นพิเศษที่จะถามว่าวิธีลดสัญญาณรบกวนอื่นใดที่ใช้ร่วมกับมันได้ เพื่อให้คิดเรื่องความเข้ากันได้กับ PEC ได้ชัดเจน จะช่วยได้ถ้าจัดหมวดหมู่เทคนิคตามสิ่งที่มันทำกับสัญญาณรบกวน ลองดูหมวดหมู่ทั่วไปเหล่านี้
-
Noise cancellation - พยายามผกผัน error channel
-
Noise scaling - เพิ่มสัญญาณรบกวนโดยตั้งใจเพื่อทำ extrapolation
-
Noise reshaping - เปลี่ยนโครงสร้างหรือสเปกตรัมของสัญญาณรบกวน
-
Bias removal - แก้ข้อผิดพลาดที่ไม่ขยายตามสัญญาณรบกวนของ Gate
PEC อยู่ในหมวด (1) พอดี วิธีใดก็ตามที่เปลี่ยนหรือปรับสเกล noise channel ต้องตรวจสอบอย่างระมัดระวัง
ตารางสรุป (ภาพรวม)
| เทคนิค | เข้ากันได้กับ PEC | หมายเหตุ |
|---|---|---|
| ZNE | ไม่ | การยกเลิกข้อผิดพลาดเทียบกับการปรับสเกล และบางครั้งการปรับแต่งข้อผิดพลาด |
| Pauli twirling | ได้ (ต้องระวัง) | มีผลต่อพฤติกรรมของข้อผิดพลาด แต่อาจทำให้เรียนรู้ได้ง่ายขึ้น |
| TREX | ได้ | ขั้นตอนไม่ทับซ้อนกัน เข้ากันได้อย่างสมบูรณ์ |
| Dynamical decoupling | โดยทั่วไปไม่ได้ | เปลี่ยน error channel |
PEC และ ZNE จัดการแหล่งข้อผิดพลาดเดียวกัน (ข้อผิดพลาดของ Gate) ด้วยสมมติฐานหรือขั้นตอนการทำงานที่เข้ากันไม่ได้ หรือทั้งสองอย่าง ตัวอย่างเช่น ใน ZNE เราสมมติว่าข้อผิดพลาดกระจายได้ตามพารามิเตอร์ :
และข้อผิดพลาดนั้นปรับสเกลได้อย่างมีประสิทธิภาพเพื่อจำลองการกระจายนี้ PEC จะยกเลิกข้อผิดพลาดที่เราอาศัยในการปรับสเกลนั่นเอง พารามิเตอร์ จะไม่มีความหมาย อีกวิธีคิดหนึ่งคือ:
-
การใช้ ZNE ก่อน PEC เปลี่ยน noise channel ที่คุณพยายามจะผกผัน
-
การใช้ PEC ก่อน ZNE กำจัดสัญญาณรบกวนที่ ZNE อาศัยในการทำ extrapolation
ควรมอง PEC และ ZNE เป็นแนวทางลดข้อผิดพลาดทางเลือก ไม่ใช่เลเยอร์ที่นำมาประกอบกันได้ การเปรียบเทียบทั้งสองข้างกันให้ความรู้ แต่การรวมกันไม่ให้ประโยชน์
โดยทั่วไป PEC และ Pauli twirling เข้ากันได้และมักเป็นประโยชน์ Twirling อาจช่วย PEC เพราะ twirling แปลงข้อผิดพลาดแบบ coherent เป็นข้อผิดพลาด Pauli แบบสุ่ม ซึ่งทำให้ noise channel เรียบง่ายขึ้น แสดงและผกผันได้ง่ายขึ้น สำหรับ PEC สิ่งนี้มีค่ามาก ด้วยเหตุผลต่อไปนี้
-
การแยกส่วนแบบ quasi-probability ง่ายกว่ามากสำหรับ Pauli channel
-
ค่าบรรทัดฐาน quasi-probability มักเล็กลงอย่างมาก
-
ความแปรปรวนจากการสุ่มตัวอย่างลดลง
การสาธิต PEC จำนวนมากสมมติหรือสร้างสัญญาณรบกวนแบบ Pauli-twirled ไว้ในตัว สิ่งสำคัญที่ต้องชี้แจงคือ Pauli twirling ไม่ได้ลดข้อผิดพลาดด้วยตัวเอง แต่ปรับรูปร่างของสัญญาณรบกวนให้อยู่ในรูปแบบที่ probabilistic error cancellation จัดการได้มีประสิทธิภาพมากขึ้น
PEC สามารถและควรใช้ร่วมกับ TREX ได้ สองแนวทางนี้เข้ากันได้อย่างสมบูรณ์และมีบทบาทตั้งฉากกัน TREX ทำงานที่การวัดเท่านั้น ลบ readout bias ผ่าน twirl แบบสุ่มของ measurement channel และไม่กระทบสัญญาณรบกวนของ Gate หรือพลวัตของ Circuit ส่วน PEC ทำงานกับสัญญาณรบกวนของ Gate เนื่องจากข้อผิดพลาดจากการวัดเป็นแบบบวกไม่ใช่แบบประกอบ จึงไม่ขึ้นกับลำดับของ Gate ใช้ TREX ควบคู่กับ PEC ได้อย่างปลอดภัยและมักเป็นสิ่งที่ควรทำ
ลำดับของวิธีเหล่านี้เป็นไปตามที่คุณคาดไว้
- รัน Circuit ที่สุ่มตามแบบ PEC
- ใช้ TREX เพื่อลดข้อผิดพลาดจากการอ่านค่า
- ใช้การถ่วงน้ำหนักและการเฉลี่ยของ PEC
โดยทั่วไป PEC และ DD เข้ากันไม่ได้ เว้นแต่การระบุลักษณะสัญญาณรบกวนที่ใช้กับ PEC จะทำขณะเปิด DD อยู่ PEC สมมติว่า นิ่ง ทำซ้ำได้ และระบุลักษณะได้อย่างแม่นยำ DD ปรับรูปร่าง noise channel ตามเวลาอย่างชัดเจนโดยมอดูเลตอันตรกิริยาระหว่างระบบกับสิ่งแวดล้อม และก่อให้เกิดผลของการจับเวลาพัลส์ที่ไม่ธรรมดา ผลคือสัญญาณรบกวนที่มีผลจริงเมื่อมี DD ไม่ใช่ channel เดียวกับตอนไม่มี DD และซับซ้อนยิ่งขึ้นเพราะ noise channel อาจขึ้นกับการจัดตารางเวลาของ Circuit อย่างไวมาก ผลลัพธ์สุดท้ายคือการผกผันสัญญาณรบกวนจะนิยามไม่ได้หรือใช้ไม่ได้
ในทางทฤษฎีเป็นไปได้ที่จะระบุลักษณะสัญญาณรบกวนขณะเปิด DD แล้วสร้างโมเดล PEC ตามนั้น แต่เป็นเรื่องขั้นสูงมากและไม่ใช่เวิร์กโฟลว์ที่แนะนำในปัจจุบัน
การใช้ PEC ด้วยมือ
PEC ซับซ้อนและไม่แนะนำให้คุณทำด้วยมือ อย่างไรก็ตาม เราอยากไล่คณิตศาสตร์ของการประยุกต์พื้นฐานบน Qubit เดียว เพื่อทำความเข้าใจว่ากระบวนการนี้มีขั้นตอนอะไรบ้าง เราเลือกสถานะแบบผสมแต่ไม่ธรรมดา เพื่อให้เห็นผลเชิงตัวเลขได้ชัดเจน
สมมติ Qubit ที่ควรอยู่ในสถานะบริสุทธิ์
เมทริกซ์ความหนาแน่นในอุดมคติคือ:
เราเลือกเมทริกซ์ความหนาแน่นนี้เพราะมันไม่เป็นเมทริกซ์ทแยงมุม และใช้กับ Qubit เดียวเท่านั้น จึงตรวจสอบ "ด้วยมือ" ได้ไม่ยาก
ตอนนี้เราใช้โมเดลสัญญาณรบกวนที่เรียบง่ายมากแต่สมจริง คือ depolarizing channel บน Qubit เดียว ที่มีความแรงน้อย
เพื่อให้การคำนวณเป็นมิตร ให้ channel นี้เป็น completely positive, trace-preserving (CPTP) ตามที่ต้องเป็น มันเป็น noise channel ที่สมจริงสำหรับฮาร์ดแวร์จริง หรืออย่างน้อยก็สมจริงสำหรับอธิบายสัญญาณรบกวนบางส่วน นอกจากนี้ noise channel นี้ผกผันได้เชิงวิเคราะห์ในฐานะ linear map กล่าวอีกอย่างคือมีเมทริกซ์ผกผันอยู่ แต่ไม่ได้หมายความว่าเมทริกซ์นั้นตรงกับ channel ทางกายภาพแบบ CPTP และแน่นอนว่าไม่ตรงกับ unitary ที่นำไปทำบนฮาร์ดแวร์ได้
ตอนนี้เราใช้ depolarizing noise channel กับเมทริกซ์ความหนาแน่นของ Qubit เดียว และได้:
เมื่อ : และ
So:
ใช้กับสถานะของเรา:
คำนวณอย่างชัดเจน:
นี่ยังเป็นเมทริกซ์ความหนาแน่นทางกายภาพ และยังมี trace เท่ากับหนึ่ง — แต่ตอนนี้มันผสมมากขึ้น
ตอนนี้เราคำนวณ inverse channel ในอุดมคติ โดยเตรียมใจไว้มากว่ามันอาจไม่เป็นทางกายภาพ เราจะตรวจสอบว่าเป็นหรือไม่ ทางคณิตศาสตร์ linear map ผกผันคือ:
ถ้าการกระทำผกผันนี้เป็น channel ทางกายภาพที่ถูกต้องเอง เราก็คงอยากลองทำมันให้ตรงเป๊ะ แน่นอนว่าเรายังต้องหาวิธีทำด้วยการดำเนินการ unitary และขั้นตอนแบบคลาสสิก แต่การทำสิ่งนี้จะเป็นเป้าหมาย อย่างไรก็ตาม ปรากฏว่ามัน ไม่ใช่ CPTP และโดยทั่วไปไม่มีหลักประกันว่า mapping ผกผันแบบนี้จะเป็น CPTP นั่นสำคัญมากต่อการอภิปรายของเรา เพราะเป็นเหตุผลที่ PEC มีอยู่
คุณอาจเห็นได้ว่ามันไม่ใช่ CPTP เพียงแค่มองดู วิธีตรวจสอบที่แน่นอนคือนำไปใช้กับเมทริกซ์ความหนาแน่นแล้วดูว่าได้ผลลัพธ์ทางกายภาพหรือไม่ ขอทิ้งไว้เป็นแบบฝึกหัดเพื่อตรวจสอบความเข้าใจ
ตรวจสอบความเข้าใจ
ตรวจสอบว่า mapping ผกผัน ข้างต้นเป็น CPTP หรือไม่ โดยนำไปใช้กับเมทริกซ์ความหนาแน่นใหม่:
ตีความผลลัพธ์ว่าเป็นทางกายภาพหรือไม่เป็นทางกายภาพ
คำตอบ
ในฐานะเมทริกซ์ความหนาแน่นทางกายภาพ ผลนี้หมายถึงความน่าจะเป็นแบบคลาสสิกที่มากกว่า 1 ที่ระบบอยู่ในสถานะ และความน่าจะเป็นติดลบที่จะอยู่ในสถานะ ชัดเจนว่า mapping นี้ให้เมทริกซ์ความหนาแน่นที่ไร้สาระได้ นอกจากนี้ จากการพิจารณาจะเห็นว่าค่าเจาะจงของเมทริกซ์ความหนาแน่นที่ได้คือ 1.0625 และ -0.0625 หมายความว่าค่าเจาะจงไม่ได้เป็นบวกทั้งหมด ดังนั้น mapping จึงไม่เป็น "completely positive" ซึ่งคือ "CP" ใน CPTP
ตรวจสอบความเข้าใจ
ตรวจสอบด้วยการคำนวณอย่างชัดเจนว่าการดำเนินการผกผัน ข้างต้นยกเลิก noise channel และคืนสถานะที่ไร้สัญญาณรบกวน
คำตอบ
ใช้กับสถานะที่มีสัญญาณรบกวน:
นี่คือสถานะเดิมพอดี (ในระดับการปัดเศษ)
ขอย้ำเพื่อให้ชัดเจนที่สุด: เราผกผัน noise channel ตรง ๆ ไม่ได้ ตัวผกผันไม่ใช่ CPTP และไม่ใช่ channel ทางกายภาพที่ถูกต้อง อย่างไรก็ตาม เราผกผัน channel ได้อย่างมีประสิทธิภาพในรูปผลรวมเชิงเส้นของ channel ทางกายภาพ
สำหรับ depolarizing channel:
โดยที่: เป็นต้น
ตัวผกผันเขียนได้เป็น:
with:
-
= Clifford channel ที่นำไปทำได้จริงทางกายภาพ
-
= quasi-probability
-
Some
นี่คือแนวคิดหลักของ PEC:
-
สุ่ม channel ตาม ∣
-
ใส่เครื่องหมายให้ผลการวัด
-
ค่าคาดหมายลู่เข้าสู่ค่าที่ไร้สัญญาณรบกวน
เราใช้ PEC "ด้วยมือ" เพื่อประมาณค่า โดยใช้เมทริกซ์ความหนาแน่น และดูว่าจะกู้ผลลัพธ์ของ กลับมาได้หรือไม่ สำหรับ เราคาดว่า:
สังเกตด้วยว่าสำหรับเมทริกซ์ความหนาแน่นที่มีสัญญาณรบกวน เราได้:
อยู่ในอันดับของขนาดที่ถูกต้อง แต่ห่างจากกรณีอุดมคติอย่างมาก
ตอนนี้เราไล่ดูว่า ด้วยกระบวนการ PEC เราสร้างค่าคาดหมายที่ไม่เอนเอียงจากเมทริกซ์ความหนาแน่นที่มีสัญญาณรบกวนได้อย่างไร ในเวิร์กโฟลว์จริง ขั้นตอนนี้เป็นแบบความน่าจะเป็นและทำโดยอัตโนมัติ ในเวิร์กโฟลว์ "ด้วยมือ" นี้ เราจะเลือกค่าความน่าจะเป็นที่สมจริง แต่อาจสะดวกต่อการนำเสนอ ไม่ควรตีความว่าเป็นการอ้างว่า PEC สมบูรณ์แบบ นี่เป็นเพียงการแสดงสถานการณ์ที่น่าจะเกิดขึ้นได้ภายในแพ็กเกจ PEC
ระลึกว่า noise channel ของเรามีรูปแบบ:
ตัวผกผันเขียนได้ (อย่างแม่นตรง) เป็น:
based on symmetry of the transformation and the completeness of the Pauli operators. Inverting the noise channel somehow in the estimation process should yield an estimator that is unbiased and normalized. To do this, we must at least determine the coefficents and and then think about how to implement the inverse transformation. When done by a noise learner, the inversion of this noise channel would be done at the channel level, independent of a specific case like our density matrix. The coefficients and would come from this inversion.
สำหรับบทแนะนำนี้ง่ายกว่าที่จะเน้นผลของ channel ต่อเมทริกซ์ความหนาแน่นของเรา ซึ่งทำให้เราทำงานกับวัตถุที่คุ้นเคยอย่างเมทริกซ์ความหนาแน่นและค่าคาดหมายได้ เพื่อการนั้น ลองพิจารณาว่าอะไรต้องเป็นจริงเกี่ยวกับผลของการดำเนินการผกผันนี้ต่อกระบวนการประมาณค่าของเรา: ตัวประมาณค่าที่ PEC สร้างขึ้นต้องเป็น normalized และไม่เอนเอียง ซึ่งสอดคล้องกับสองเงื่อนไข:
-
Normalization: เพื่อให้แน่ใจว่าการดำเนินการนี้ไม่เปลี่ยนสเกลของ observable เราต้องการให้ เพื่อดูว่าทำไมจึงเป็นเช่นนั้น เราอาจพิจารณาการกระทำของตัวผกผันต่อเมทริกซ์ความหนาแน่น หรือพิจารณาการกระทำต่อค่าคาดหมายของสิ่งธรรมดา ๆ อย่าง เอง
-
Calibration: ในเวิร์กโฟลว์จริง เราใช้ calibration circuit เพื่อเรียนรู้พฤติกรรมของสัญญาณรบกวนในระดับ Gate จากนั้นใช้ความรู้ระดับ Gate เกี่ยวกับพฤติกรรมสัญญาณรบกวน และความเป็นเชิงเส้นของค่าคาดหมาย เพื่อนำโมเดลสัญญาณรบกวนที่เรียนรู้ไปใช้กับ Circuit ที่ใหญ่กว่า ในกรณีของเรา เราเริ่มจากความรู้เทียมว่าค่าคาดหมายในอุดมคติ แต่การหาสถานะที่เรารู้ในทางทฤษฎีว่าเป็นค่าอุดมคตินี้แล้วใช้การวัดจริงเพื่อ calibration นั้นง่ายมาก ประเด็นสำคัญคือ สำหรับ PEC โดยทั่วไปเราไม่เรียนรู้โมเดลสัญญาณรบกวนทั้งหมดของทั้ง Circuit แต่เรียนรู้โมเดลสัญญาณรบกวนเฉพาะที่ของแต่ละ Gate หรือเลเยอร์ของ Circuit แล้วใช้สิ่งเหล่านั้นสร้างการแยกส่วนแบบ quasi-probability
เราใช้เงื่อนไขเหล่านี้เพื่อหา และ เราพิจารณา ansatz
and apply it to an arbitrary single-qubit density matrix .
ระลึกว่า Pauli channel กระทำผ่านการ conjugate:
การใช้ กับ ให้:
เมื่อหา trace เราได้:
ตัวดำเนินการ Pauli แต่ละตัวเป็น unitary ดังนั้นการ conjugate รักษา trace ไว้:
Therefore,
เพื่อให้ตัวประมาณค่า PEC เป็น normalized แผนที่ผกผันที่มีผลจริง ต้องรักษา trace ของเมทริกซ์ความหนาแน่นทุกตัว นั่นคือเราต้องการ:
นี่นัยถึงเงื่อนไขบังคับ normalization:
แต่ในกรณีของเรา สิ่งนี้ให้เงื่อนไข:
ตอนนี้เราใช้ข้อมูล calibration เพื่อเชื่อมโยงค่าคาดหมายที่สังเกตได้กับค่าอุดมคติที่ทราบ
Or equivalently,
เมื่อแก้สองเงื่อนไขของเราหา และ เราได้:
สัมประสิทธิ์เหล่านี้รวมกันได้ 1 แต่มีตัวหนึ่งเป็นลบ
เรากู้ค่าคาดหมายในอุดมคติได้โดยแก้ Circuit แบบสุ่ม วัด คูณผลลัพธ์ด้วยน้ำหนักที่มีเครื่องหมาย แล้วเฉลี่ย โดยเฉพาะอย่างยิ่ง ไม่มีการสร้างเมทริกซ์ความหนาแน่นขึ้นใหม่ และไม่มีการทำ inverse channel ทางกายภาพ
ขั้นตอนสำคัญ: นี่คือ PEC
สำหรับความแรงสัญญาณรบกวนของเรา inverse channel เขียนได้เป็น:
ข้อเท็จจริงสำคัญ:
-
สัมประสิทธิ์รวมกันได้ 1
-
สัมประสิทธิ์หนึ่งตัวเป็นลบ
-
แต่ละพจน์นำไปทำได้จริงทางกายภาพ
-
ความเป็นลบถูกย้ายไปอยู่ในการประมวลผลหลังแบบคลาสสิก
เราสร้างการแจกแจงสำหรับสุ่มตัวอย่างจากค่าสัมบูรณ์ของน้ำหนัก:
(สำหรับแต่ละตัวของ X, Y, Z)
น้ำหนักรวม:
สำหรับความน่าจะเป็นในการสุ่มตัวอย่าง ให้หารด้วย W
| การดำเนินการ | ความน่าจะเป็น | เครื่องหมาย |
|---|---|---|
| ไม่ทำอะไร () | 1.1875 / 1.375 ≈ 0.864 | + |
| ใช้ X | 0.0625 / 1.375 ≈ 0.045 | - |
| ใช้ Y | 0.0625 / 1.375 ≈ 0.045 | - |
| ใช้ Z | 0.0625 / 1.375 ≈ 0.045 | - |
เครื่องหมายมาจากสัมประสิทธิ์ดั้งเดิม ไม่ใช่จากความน่าจะเป็น
แต่ละช็อตประกอบด้วยขั้นตอนเหล่านี้:
-
เตรียมสถานะ
-
ให้ฮาร์ดแวร์ทำ Circuit ที่มีสัญญาณรบกวน
-
สุ่มเลือกการดำเนินการจากตารางข้างต้นโดยใช้ความน่าจะเป็นที่เกี่ยวข้อง
-
Apply it
-
วัด ได้
-
คูณผลลัพธ์ด้วย
-
บันทึกตัวเลขนั้น
ตอนนี้เราดูตัวอย่างหลายช็อต
ช็อต 1 (กรณี identity)
สมมติว่าการดำเนินการที่สุ่มเลือกได้คือ identity (หรือก็คือไม่ทำอะไร) จากข้อโต้แย้งและตารางข้างต้น สิ่งนี้จะเกิดขึ้น 86.4% ของเวลา เนื่องจากสัมประสิทธิ์ของ ในตัวผกผันของ noise channel เป็นบวก เราจึงเลือกเครื่องหมาย การวัด Z ของเราอาจได้ อย่างใดอย่างหนึ่งได้ง่าย สมมติว่าได้
ส่วนที่ได้รับการแก้ด้วย PEC จากช็อตนี้คือ:
ช็อต 2 (identity อีกครั้ง)
สมมติว่าเราได้ เป็นการดำเนินการสุ่มอีกครั้ง (เครื่องหมายของพจน์จึงยังเป็น ในตอนแรก) แต่คราวนี้การวัด Z ได้ คราวนี้ส่วนที่ได้คือ:
ช็อต 3 (เลือก X)
คราวนี้การดำเนินการสุ่มคือ X พจน์นี้ในตัวผกผันเป็นลบ เราจึงคงเครื่องหมาย ไว้ เราใช้ X แล้ววัด Z อีกครั้ง เราอาจได้ค่าเจาะจงตัวใดตัวหนึ่ง สมมติว่าได้ ส่วนที่ได้จากพจน์นี้คือ:
ช็อต 4 (เลือก Z)
การดำเนินการสุ่มคือ Z ซึ่งให้เครื่องหมาย จากตาราง สมมติว่าเราวัด Z และได้ ส่วนที่ได้คือ:
ช็อต 5 (เลือก Y)
การดำเนินการสุ่มคือ Y ซึ่งให้เครื่องหมาย จากตาราง สมมติว่าเราวัด Z และได้ ส่วนที่ได้คือ:
การเฉลี่ยผลลัพธ์
ลองนึกภาพว่าเรารวบรวมผลลัพธ์ที่ถ่วงน้ำหนักด้วย PEC แบบนี้จำนวนมาก:
โดยการสร้าง เราใช้ identity 86.4% ของเวลา และใช้ Gate อื่นแต่ละตัว 4.5% ของเวลา ในเวิร์กโฟลว์จริง เราไม่รู้สถานะที่แท้จริงเบื้องหลังอย่างแม่นยำ และไม่รู้ noise channel ทั้งหมด แต่เรารู้ตัวประกอบถ่วงน้ำหนัก จากข้างต้น และความน่าจะเป็นสัมพัทธ์ที่เราใช้แต่ละการดำเนินการ ในเวิร์กโฟลว์จริง เราพึ่งเมทริกซ์ความหนาแน่นที่ไม่ทราบให้ผลการวัดแก่เรา ที่นี่เราจะตรวจสอบว่ากระบวนการนี้ให้ผลลัพธ์ที่ถูกต้อง
เราต้องการคำนวณค่าเฉลี่ยของการวัดที่ถ่วงน้ำหนักและมีเครื่องหมายทั้งหมด รวมถึงการใช้ตัวดำเนินการ Pauli ก่อนการวัด เรียกจำนวนช็อตทั้งหมดว่า เรียกเซตของช็อตทั้งหมดที่ใช้ Pauli ว่า และใช้ เป็นดัชนีของช็อตเหล่านี้ เรียกผลการวัดของช็อตที่ ภายใต้การใช้ Pauli ตัวที่ ว่า เราเขียนค่าเฉลี่ยนี้ได้เป็น:
ตัวดำเนินการ Pauli ถูกใช้แบบสุ่มด้วยความน่าจะเป็น ในลิมิตที่จำนวนช็อตมากมาก
เราใช้สิ่งนี้เขียนได้ว่า:
โดยที่ คือค่าคาดหมายของ Z เฉพาะบนเอนเซมเบิลของช็อตที่ใช้ สิ่งนี้มีประโยชน์เพราะเรารู้ว่าค่าคาดหมายแต่ละตัวต้องเป็นเท่าไรจากเมทริกซ์ความหนาแน่น ย้ำอีกครั้งว่าในเวิร์กโฟลว์จริง ค่าเหล่านี้จะได้จากการวัด ไม่ใช่จากเมทริกซ์ความหนาแน่นที่ทราบ
ตรวจสอบความเข้าใจ
ตรวจสอบค่าคาดหมาย ข้างต้นด้วยการคำนวณหรือการให้เหตุผลเชิงตรรกะ
คำตอบ
Y และ Z ทำเหมือนกับข้างบนทุกประการ
ตอนนี้เราเขียนค่าคาดหวังโดยรวมของเราใหม่ได้เป็น:
ถ้าเรารู้พารามิเตอร์ และ ของ noise ของ gate (หรือพารามิเตอร์เพิ่มเติมสำหรับ noise channel ที่ซับซ้อนขึ้น) ก็เพียงพอที่จะกำหนด (1) ตัวคูณน้ำหนักโดยรวม และ (2) ความน่าจะเป็นที่เราควรใช้ตัวดำเนินการ Pauli ผลลัพธ์ข้างต้นแสดงให้เห็นว่าถ้าเราทำแบบนั้น เราจะลด noise และได้ค่าคาดหวังแบบไม่เอนเอียงกลับมา ค่าเฉลี่ยของ shot ทั้งหมดนี้บรรจบที่ แม้ว่า:
-
แต่ละ shot ให้ค่าที่มีขนาดใหญ่กว่า ±1
-
บาง shot มีน้ำหนักทางสถิติเป็นลบ
-
ทุกการดำเนินการควอนตัมเป็นการดำเนินการทางกายภาพ
ภาพรวมของ workflow ของ PEC
ใน PEC ขั้นตอนทั้งหมดบนคอมพิวเตอร์ควอนตัมมีดังนี้:
-
การเรียนรู้ noise
-
การเตรียมสถานะสำหรับ circuit เป้าหมายของคุณ
-
ใช้ Pauli gate แบบสุ่มตามความน่าจะเป็นตามที่อธิบายไว้ข้างต้น
-
Measurement
noise map ผกผันที่มีประสิทธิผลถูกสร้างขึ้นทางสถิติในขั้นตอนประมวลผลภายหลังแบบคลาสสิก วิธีนี้ทำให้สามารถผกผัน noise channel ได้ทั่วไปมากขึ้น ซึ่งไม่เช่นนั้นจะต้องใช้ขั้นตอนที่ไม่เป็นไปตามหลักฟิสิกส์ เช่น ความน่าจะเป็นติดลบ
ราคาที่เราต้องจ่ายสำหรับสิ่งนี้คือความแปรปรวน (variance) ก่อนหน้านี้แต่ละ shot มี "ขนาด" เท่ากับขนาดของผลการวัดที่เป็นไปได้ คือ หลังจากปรับสเกลด้วยตัวคูณน้ำหนัก แล้ว มันจะมีขนาด (1.375 ในตัวอย่างข้างต้นของเรา)
นี่คือที่มาของ sampling overhead ของ PEC
PEC ที่มีในตัว
ตอนนี้เราจะใช้ PEC ตามที่มีอยู่ในตัวของ primitive ของ IBM Quantum สิ่งสำคัญตรงนี้คือต้องแยกให้ออกระหว่าง PEC ระดับ gate แบบเต็มกับแบบจำลองการเรียนรู้ noise เฉพาะที่สำหรับ PEC ที่ขยายขนาดได้ดีกว่า ซึ่งเป็นแบบที่ primitive ของ IBM Quantum ใช้ overhead ของการใช้ PEC แบบเต็มจะจำกัดการใช้งานไว้ที่ circuit ขนาดเล็ก ซึ่งก็ไม่เป็นไร แต่การมีเครื่องมือที่ขยายขนาดไปถึงระดับที่การคำนวณควอนตัมมีคุณค่าต่อปัญหาในโลกจริงนั้นมีประโยชน์กว่า ด้วยเหตุนี้ primitive ของ IBM Quantum จึงใช้ PEC แบบรายเลเยอร์ โดยใช้แบบจำลอง noise แบบ Pauli-Lindblad ที่เรียนรู้มา พร้อมมาตรการป้องกันเพื่อการขยายขนาดอย่างเข้มงวด ใน PEC แบบนี้ noise จะถูกเรียนรู้ต่อเลเยอร์ของ circuit ที่ซ้ำกัน ไม่ใช่ต่อ gate แต่ละตัว และแบบจำลอง noise เป็นแบบ Pauli-twirled, เฉพาะที่ (local) และมาร์คอฟ (Markovian) Clifford gate ถูกรวมเข้าไปในแบบจำลอง noise ขณะที่ non-Clifford gate เป็นตัวหลักที่กำหนดต้นทุนของการลด noise โดย sampling overhead ถูกจำกัดเพดานไว้เพื่อหลีกเลี่ยงการพุ่งขึ้นแบบเอกซ์โพเนนเชียล
เราจะใช้ PEC ที่มีอยู่ใน primitive ของ IBM Quantum ที่สองขนาด คือ ขนาดเล็ก (หกคิวบิต) และขนาดกลาง (30 คิวบิต) เพื่อดูว่าต้นทุนถูกควบคุมได้อย่างไรใน PEC เวอร์ชันนี้ ในการทดลองแต่ละขนาด เราจะเปรียบเทียบผลลัพธ์จาก PEC กับผลลัพธ์ที่ไม่มีการลด noise, กับ ZNE และกับค่าในอุดมคติอย่างชัดเจนด้วย
เราเริ่มด้วยการ import แพ็กเกจที่จำเป็นบางส่วน
import numpy as np

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp, Statevector

# from qiskit_aer import AerSimulator
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    # QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
เราเลือก observable มาประมาณค่า observable ด้านล่างคือ Hamiltonian ของสายสปินแบบ Ising ที่มีการคู่ควบเฉพาะเพื่อนบ้านใกล้สุดในองค์ประกอบ ของอันตรกิริยา และมีพจน์คิวบิตเดี่ยวใน ราวกับเกิดจากสนามภายนอกในทิศ
ไม่มีเหตุผลพิเศษในการเลือก Hamiltonian นี้ เราแค่ต้องการ observable และ circuit ที่ไม่ธรรมดา เพื่อให้การลด error ได้ทำงาน เราปรับสเกล Hamiltonian อย่างชัดเจน (โดยใช้สัมประสิทธิ์) ด้วยการหารด้วยจำนวนคิวบิต เพื่อให้พลังงานอยู่ในอันดับขนาดเดิมเมื่อเราเพิ่มจำนวนคิวบิต เราเริ่มต้นที่หกคิวบิตเท่านั้น
# This cell builds the observable

num_qubits = 6

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)
เช่นเดียวกับการเลือก Hamiltonian circuit สำหรับเตรียมสถานะด้านล่างไม่ได้ถูกเลือกด้วยเหตุผลทางฟิสิกส์ใดๆ แต่ถูกเลือกให้มีความลึกของสองคิวบิตเพียงพอ และมี non-Clifford gate มากพอที่ PEC จะเป็นประโยชน์ได้ ไม่มีเหตุผลที่จะคิดว่า circuit นี้เป็นค่าประมาณที่ดีของสถานะพื้นของสายสปินนี้ เป็นต้น
qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.5, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)
qc.rz(3.141592653589793 / 8, 2)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")
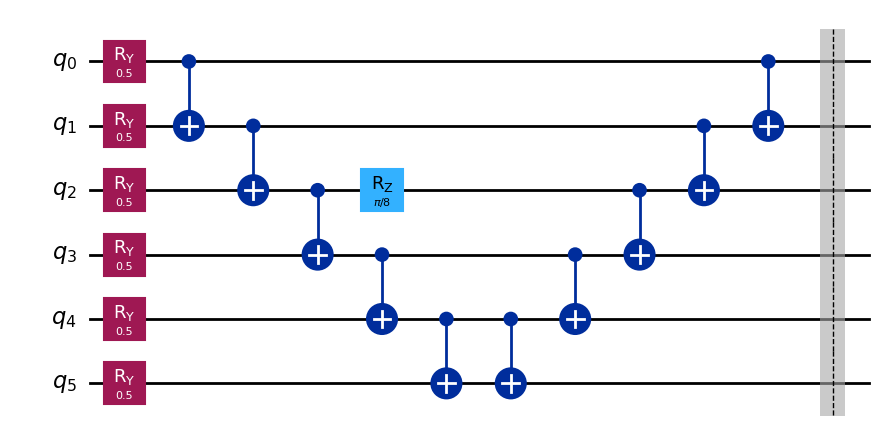
เรา transpile circuit ของเรา และนำ layout ที่ได้ไปใช้กับ observable ของเรา
# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)
เราหาค่าคาดหวังในอุดมคติโดยใช้ตัวจำลอง Statevector
# Compute the ideal final state
state = Statevector.from_instruction(qc)

# Compute expectation value
ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.6651408876730361
เราคาดว่าค่าในอุดมคติอื่นๆ จะมีขนาดใกล้เคียงกัน ตอนนี้เรารันสิ่งนี้บนคอมพิวเตอร์ควอนตัมจริงของ IBM โดยไม่มีการลด error
# This took 3 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.569677734375
ตอนนี้เราใช้ ZNE กับปัญหาเดียวกัน
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.6573718927156127
สุดท้าย เราใช้ PEC
# This took 17 sec on ibm_fez. Your actual runtime might vary.

from qiskit_ibm_runtime.options import EstimatorOptions

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

result = job_pec.result()
value_pec = result[0].data.evs

print("PEC:", value_pec)
PEC: 0.6666196849843695
ด้านล่างเราพล็อตผลลัพธ์และเปรียบเทียบกัน
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
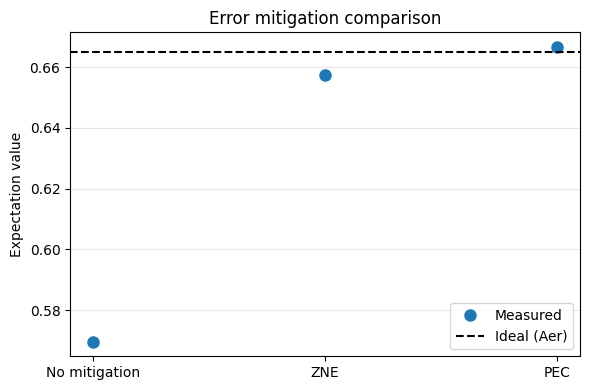
ได้ผลดีมาก ค่าประมาณของเราที่ใช้ PEC ต่างจากค่าในอุดมคติเพียง 0.2%
แต่อย่าลืมว่า overhead เชิงควอนตัมโตขึ้นแบบเอกซ์โพเนนเชียล เรากำหนด overhead สูงสุดไว้ที่ max_overhead = 100 จากเวลาและคุณภาพของผลลัพธ์ ดูเหมือนว่าเราอาจยังไม่ถึงค่าสูงสุดนั้น อย่างไรก็ตาม ถ้าเราขยายการคำนวณขึ้นและคงค่าสูงสุดนั้นไว้ เราจะชนเพดาน และผลลัพธ์ของเราจะแย่ลง
เราลองดูได้ว่าเกิดอะไรขึ้นเมื่อขยาย circuit ของเราเป็น 30 คิวบิต น่าสนใจที่บนแล็ปท็อปหลายเครื่อง ตัวจำลอง Statevector จะเริ่มหมดเวลาที่ประมาณ 24-28 คิวบิต เราอาจหาวิธีทางการคำนวณมาหลบได้ แต่ลองยอมรับความจริงว่าคอมพิวเตอร์ควอนตัมจะแก้ปัญหาบางอย่างได้ในสเกลที่คอมพิวเตอร์คลาสสิกตามไม่ทัน นั่นคือประเด็นสำคัญ แล้วเราจะทำอะไรได้เพื่อตรวจสอบผลลัพธ์การคำนวณควอนตัมในกรณีเหล่านั้น มีคำตอบที่เป็นไปได้หลายข้อ:
- ปัญหาบางอย่างแก้ยากแต่ตรวจสอบง่าย (เช่น การแยกตัวประกอบเฉพาะใน Shor's algorithm)
- ปัญหาบางอย่างมีช่วงพารามิเตอร์หรือรูปแบบของปัญหาที่ความซับซ้อนลดลง และแก้ได้แบบคลาสสิกหรือแม้แต่เชิงวิเคราะห์ เพื่อเปรียบเทียบสองสามจุด ในกรณีนี้ เราเลือก Hamiltonian ที่เป็นแบบ intrinsic (เราหารด้วยจำนวนคิวบิต) ค่าคาดหวังในอุดมคติควรค่อนข้างคงที่ ลองดูว่าค่าคาดหวังในอุดมคติเปลี่ยนไปอย่างไรตามจำนวนคิวบิต และดูว่าเราทำนายค่าที่ 30 คิวบิตแบบคลาสสิกได้หรือไม่
import numpy as np
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit
from qiskit.quantum_info import Statevector, SparsePauliOp

num_qubits_max = 24

qubits = [4, 8, 12, 16, 20, 24]
exp_vals = []
for num_qubits in qubits:
    qc = QuantumCircuit(num_qubits)

    for i in range(num_qubits):
        qc.ry(0.7, i)
    for i in range(num_qubits - 1):
        qc.cx(i, i + 1)
    for i in range(num_qubits):
        qc.rz(np.pi / 5, i)
    for i in reversed(range(num_qubits - 1)):
        qc.cx(i, i + 1)
    qc.barrier()

    terms = []
    coeffs = []

    # XX interactions
    for i in range(num_qubits - 1):
        pauli = ["I"] * num_qubits
        pauli[i] = "X"
        pauli[i + 1] = "X"
        terms.append("".join(pauli))
        coeffs.append(1.0 / (num_qubits - 1))

    # Z fields
    for i in range(num_qubits):
        pauli = ["I"] * num_qubits
        pauli[i] = "Z"
        terms.append("".join(pauli))
        coeffs.append(0.5 / num_qubits)

    observable = SparsePauliOp(terms, coeffs)

    # Compute the ideal final state
    state = Statevector.from_instruction(qc)

    # Compute expectation value
    ideal_value = np.real(state.expectation_value(observable))
    exp_vals.append(ideal_value)

print(exp_vals)

plt.figure()
plt.plot(qubits, exp_vals, "o", label="Statevector")
plt.xlabel("Number of qubits")
plt.ylabel(r"$\langle O^{\otimes N} \rangle$")
plt.legend()
plt.show()
[np.float64(0.7181764372838925), np.float64(0.7181764372838922), np.float64(0.7181764372838931), np.float64(0.7181764372838906), np.float64(0.7181764372838907), np.float64(0.7181764372838709)]
จริงตามนั้น เราเห็นว่าเราเลือก Hamiltonian และสถานะที่ไม่เปลี่ยนไปตามจำนวนคิวบิต นี่เป็นการใช้งานที่แย่มากสำหรับงานวิจัยด้านการคำนวณควอนตัม แต่ยอดเยี่ยมสำหรับการ benchmark เทคนิคการลด error เราสามารถใช้ค่าคาดหวังคงที่นี้เป็นผลลัพธ์ในอุดมคติได้อย่างมั่นใจ แม้เราจะเพิ่มจำนวนคิวบิตเพื่อทดสอบการลด error
num_qubits = 30

qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.7, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)

for i in range(num_qubits):
    qc.rz(np.pi / 5, i)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")

# This cell builds the observable

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)

# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)

# Compute the ideal final state
# This might time out above about 26 qubits. The Hamiltonian has been "normalized".
# The same expectation value calculated on the smaller example above is still valid.
# state = Statevector.from_instruction(qc)

# Compute expectation value
# ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.7181764372838709
# This took 5 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.5869884271731322
ตอนนี้เรารัน circuit ที่ใหญ่ขึ้นนี้ด้วย ZNE
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.7096089981595511
สุดท้าย เรารันตัวอย่าง 30 คิวบิตด้วย PEC
# This took 4 min 57 sec on ibm_fez. Your actual runtime might vary.

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

value_pec = job_pec.result()[0].data.evs
print("PEC:", value_pec)
PEC: 0.3481257778627795
job_id_none = job_none.job_id()
job_id_zne = job_zne.job_id()
job_id_pec = job_pec.job_id()
print("job number with no mitigation:  ", job_id_none)
print("job number with ZNE  ", job_id_zne)
print("job number with PEC  ", job_id_pec)
job number with no mitigation:   d7uc79back5s73be1cv0
job number with ZNE   d7uc7c3ack5s73be1d40
job number with PEC   d7uc9k4inasc738smhu0
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
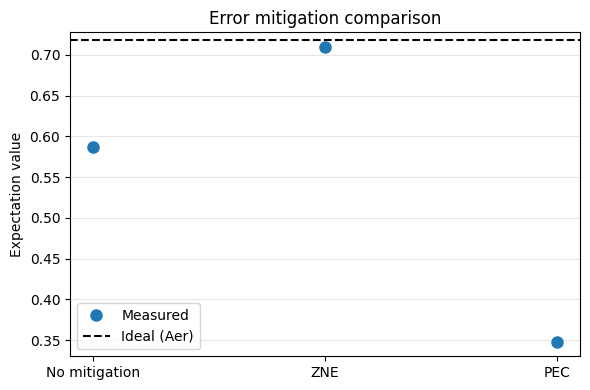
PEC ไม่เพียงใช้เวลานานกว่าตัวเลือกอื่นมาก แต่เรายังชนเกณฑ์ overhead สูงสุดอย่างชัดเจนด้วย ผลลัพธ์ของ PEC จ่ายราคาของ overhead แล้ว แต่เพดาน overhead ทำให้การหักล้างแบบจำลอง noise ที่เรียนรู้มาไม่แม่นยำพอ นี่สำคัญมาก ที่หกคิวบิต เราใช้ PEC ได้และได้ผลลัพธ์ดีขึ้น โดย overhead เชิงควอนตัมเพิ่มขึ้นเพียงเล็กน้อย (ประมาณ 5 เท่า) ที่ 30 คิวบิต เราจ่ายราคาสูงกว่ามาก (สูงกว่าประมาณ 60 เท่า) และผลลัพธ์กลับแย่กว่าค่าประมาณที่ไม่ได้ลด error นี่ไม่ได้หมายความว่า PEC ใช้กับ 30 คิวบิตไม่ได้เลย ซึ่งอาจขึ้นกับ circuit ข้อสรุปคือการเติบโตแบบเอกซ์โพเนนเชียลของ overhead เชิงควอนตัมทำให้รันกับ circuit ขนาดใหญ่ได้ยาก
ข้อสรุปสำคัญ:
-
การลด error ของการวัดมักช่วยได้และมักมี overhead ต่ำ: มันกำจัดความเอนเอียงที่ไม่ขึ้นกับความลึกของ circuit และใช้ร่วมกับเทคนิคเกือบทุกอย่างได้อย่างลงตัว
-
บางเทคนิคใช้ร่วมกันไม่ได้ แม้ในกรณีที่ใช้ร่วมกันได้ ก็ต้องแน่ใจว่าคุณรวมเข้าด้วยกันอย่างสอดคล้อง เพื่อไม่ให้เทคนิคหนึ่งไปหักล้างอีกเทคนิคหนึ่ง ตัวอย่างที่ดีคือการตรวจสอบให้แน่ใจว่าเปิด twirling ระหว่างการสอบเทียบสำหรับ M3 หากจะใช้สองวิธีนี้ร่วมกัน
-
ควรมอง PEC และ ZNE เป็นทางเลือกแทนกัน ทั้งสองแก้ปัญหาเดียวกันด้วยข้อแลกเปลี่ยนที่ตรงกันข้าม:
-
PEC: ให้ค่าคาดหวังแบบไม่เอนเอียง โดยแลกกับความแปรปรวนที่เพิ่มแบบเอกซ์โพเนนเชียล
-
โดยทั่วไป ZNE ให้ความเอนเอียงตกค้างที่ขึ้นกับแบบจำลองการ extrapolate แต่มีต้นทุนปานกลาง
-
-
DD ช่วยได้เมื่อมีช่วงว่างยาวนาน แต่มันเปลี่ยนรูปแบบจำลอง noise และอาจทำให้สมมติฐานของการ extrapolate หรือการผกผันใช้ไม่ได้
-
Pauli twirling ไม่ได้ลด noise แต่เปลี่ยนรูปของมัน และมักช่วยให้เทคนิคอื่น (ZNE และ PEC) ทำงานได้ดีขึ้น