เวิร์กโฟลว์สมัยใหม่
คอร์สนี้ครอบคลุมวิธีจัดการสัญญาณรบกวนและข้อผิดพลาดควอนตัมหลากหลายวิธี เราตั้งใจหลีกเลี่ยงโซลูชันแบบ black-box บางอย่าง เพื่อให้เห็นว่าวิธีเหล่านี้ทำงานอย่างไร ตอนนี้เราพร้อมใช้วิธีเหล่านี้ในรูปแบบที่ทันสมัยที่สุดแล้ว โดยเฉพาะอย่างยิ่ง เราจะสำรวจเครื่องมือจัดการข้อผิดพลาดที่ปรับให้เหมาะสมอย่างมาก ซึ่งซ่อนความซับซ้อนบางส่วนไว้ให้เรา เรายังสำรวจ Samplomatic และ addons เช่น shaded lightcones (SLC) ซึ่งให้เราควบคุมกระบวนการลดผลกระทบบางอย่างได้อย่างละเอียดมาก
ในวิดีโอนี้ ดร. Chris Porter ให้ภาพรวมของเครื่องมือสมัยใหม่เหล่านี้ เราวางแผนจะเพิ่มเวิร์กโฟลว์ตัวอย่างลงในบทเรียนนี้ในภายหลัง อย่างไรก็ตาม บทเรียนนี้มีข้อมูลทั้งหมดที่คุณต้องใช้เพื่อใช้เครื่องมือเหล่านี้และสอบ badge ผ่านอยู่แล้ว
ภาพรวม
primitives ของ IBM Quantum รุ่นแรก เช่น Estimator และ Sampler เปิดให้ใช้การลดผลกระทบจากข้อผิดพลาดผ่านระดับที่ตั้งไว้ล่วงหน้าจำนวนน้อย รุ่นหลังๆ ให้ควบคุมแต่ละเทคนิคได้โดยตรงมากขึ้น รวมถึงตัวเลือกกลยุทธ์ zero-noise extrapolation การกำหนดค่า Pauli twirling และพารามิเตอร์ randomization อย่างไรก็ตาม การตั้งค่าเหล่านี้ยังคงเป็นแบบ global เป็นส่วนใหญ่ และใช้กับ circuit ทั้งวงจรอย่างเท่าเทียมกัน
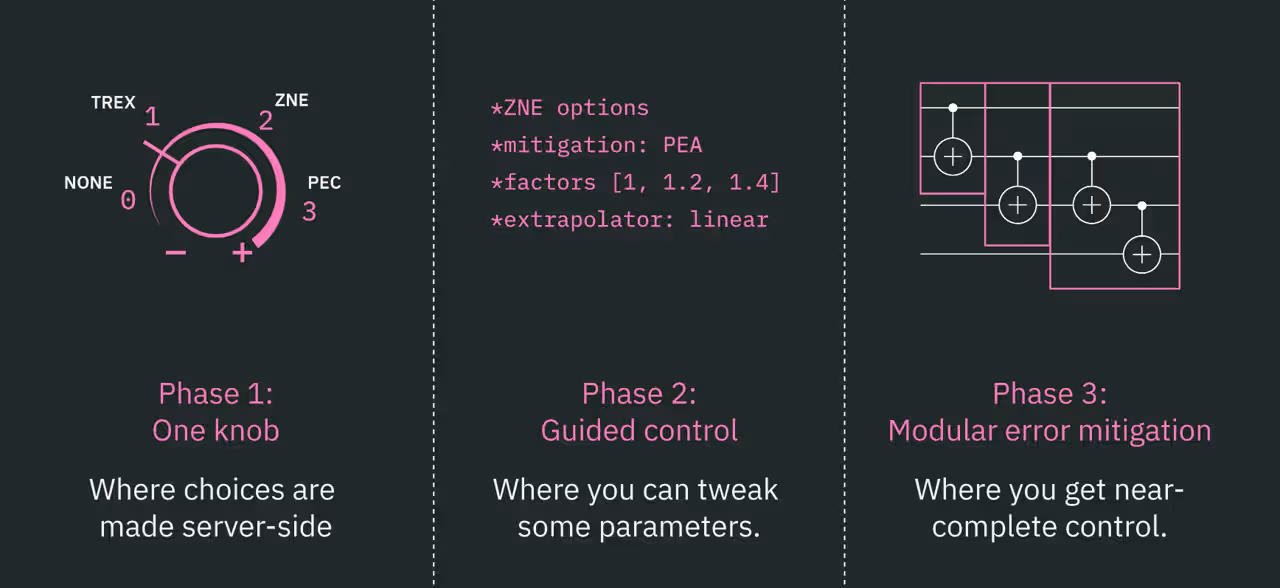
เมื่อเวิร์กโหลดควอนตัมซับซ้อนขึ้น นักพัฒนาต้องการความสามารถในการปรับกลยุทธ์การรันและการลดผลกระทบให้เหมาะกับบริเวณเฉพาะของ circuit มากขึ้น แผนภาพต่อไปนี้สรุปเครื่องมือสำคัญหลายอย่างที่บทเรียนนี้กล่าวถึง และแสดงว่าแต่ละเครื่องมืออยู่ตรงไหนในเวิร์กโฟลว์ทั่วไป
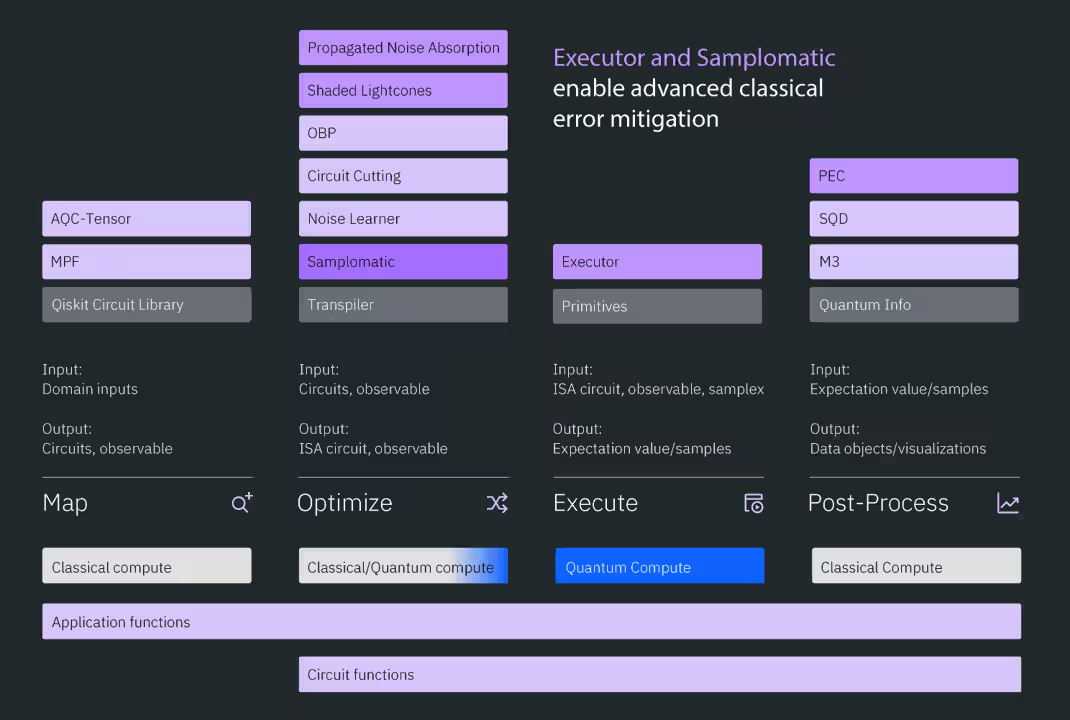
directed execution model ตอบโจทย์ความต้องการการควบคุมการรันแบบโมดูลาร์ และรวมเครื่องมือเหล่านี้หลายอย่างเข้าด้วยกัน
Directed execution model
แทนที่จะตัดสินใจเรื่องการรันโดยนัย directed execution model จะทำตามคำสั่งที่ผู้ใช้ระบุ แนวทางนี้ช่วยเพิ่มความโปร่งใส และทำให้เวิร์กโฟลว์ที่ซับซ้อนตรวจสอบและดีบักได้ง่ายขึ้น คุณสมบัติหลักบางอย่างของโมเดลนี้ได้แก่:
-
การกำหนดค่าต่อเลเยอร์ผ่านบริเวณของ circuit ที่มีป้ายกำกับ
-
การระบุเลเยอร์ที่ไม่ซ้ำและเลเยอร์ที่ซ้ำเพื่อการเรียนรู้สัญญาณรบกวนอย่างมีประสิทธิภาพ
-
เวิร์กโฟลว์การรันแบบ batch
-
การประมวลผลหลังการรันแบบมีโครงสร้าง
-
การทำงานร่วมกับ addons เช่น shaded lightcones อย่างใกล้ชิด
โมเดลนี้สร้างขึ้นรอบองค์ประกอบหลักสองอย่าง:
-
Samplomatic ซึ่งกำหนด execution recipes
-
Executor ซึ่งรัน recipes เหล่านั้นและคืนตัวอย่าง
เวิร์กโฟลว์ส่วนใหญ่ที่ใช้ Executor ก็ทำด้วย Sampler ได้เช่นกัน เพราะทั้งสองอย่างสุดท้ายแล้วสร้างตัวอย่างเหมือนกัน ข้อได้เปรียบหลักของ Executor คือประสิทธิภาพ งานอย่างการสร้างการกำหนดค่า twirling มักเร็วกว่ามากในสภาพแวดล้อม near-time ฝั่งเซิร์ฟเวอร์เมื่อเทียบกับฝั่งไคลเอนต์ Estimator และ Sampler ยังคงได้รับการสนับสนุน และอาจยังเป็นตัวเลือกที่สะดวกที่สุดสำหรับเวิร์กโหลดจำนวนมาก
อย่างไรก็ตาม ก่อนการรัน คุณต้องสร้างและเตรียม circuit Qiskit มี addons หลายตัวที่ช่วยในการสร้าง จำลอง และปรับ circuit ให้เหมาะสม สำหรับข้อมูลเพิ่มเติมเกี่ยวกับเครื่องมือใดๆ ต่อไปนี้ ให้ตามลิงก์
สร้าง quantum circuit
สำหรับบางแอปพลิเคชันหรือแนวทางใหม่ ผู้ใช้ต้องกำหนดเองว่าจะแมปปัญหาของตนเป็น quantum circuit อย่างไร อย่างไรก็ตาม ในหลายโดเมน Qiskit addons สามารถทำส่วนสำคัญของกระบวนการนี้ให้อัตโนมัติได้
Optimization mapper
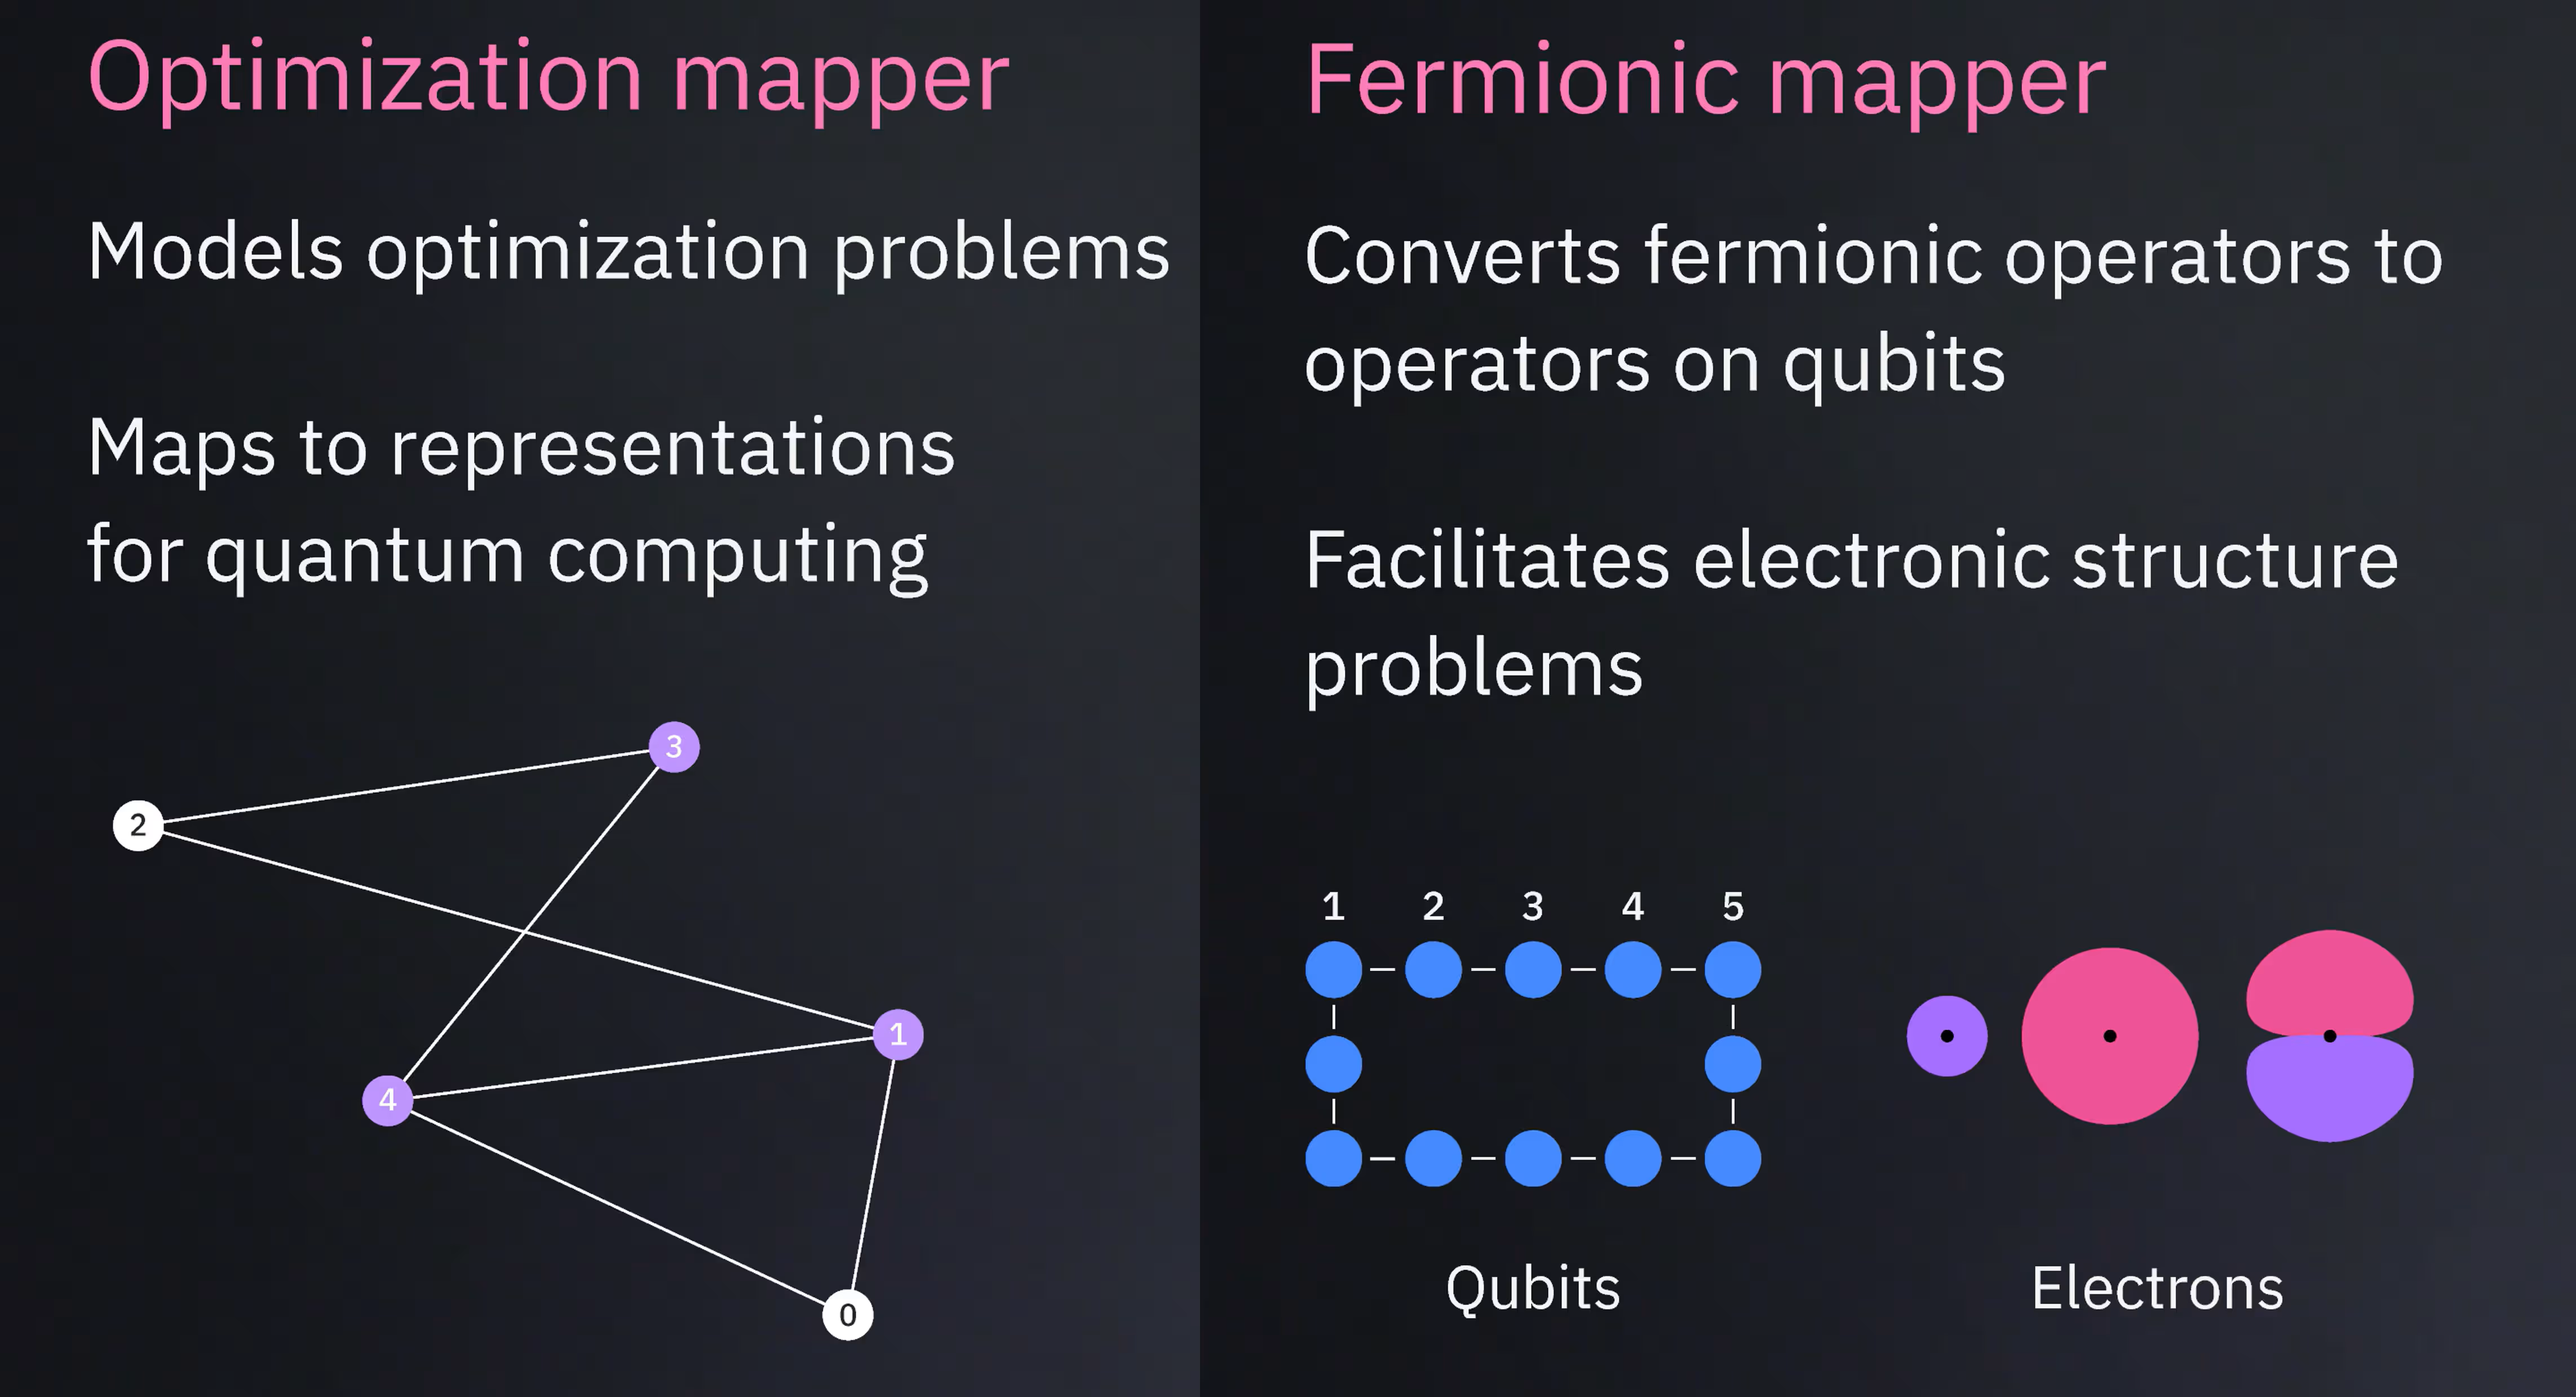
Optimization mapper ช่วยแสดงปัญหา optimization แบบคลาสสิกในรูปแบบที่เหมาะกับอัลกอริทึมควอนตัม ฟังก์ชันหลักได้แก่:
-
สร้างฟังก์ชันเป้าหมายและข้อจำกัด
-
แปลงปัญหาเป็นรูปแบบ QUBO
-
สร้างตัวแทนแบบ Hamiltonian หรือ operator
Fermionic mapper
Fermionic mapper แปลง fermionic operators เป็น qubit operators ที่เหมาะกับฮาร์ดแวร์ควอนตัม รองรับการแมปอย่าง Jordan-Wigner ซึ่งแปลง operators บน fermions ที่แยกแยะไม่ได้เป็น Pauli operators บน qubits ที่แยกแยะได้ พร้อมรักษาสถิติของ fermionic ไว้ addon นี้มีประโยชน์สำหรับเคมีควอนตัมและวิทยาศาสตร์วัสดุ
สอง addons ก่อนหน้านี้เน้นการแมปโครงสร้างปัญหาเริ่มต้นไปเป็น quantum circuit อย่างไรก็ตาม การแมปวิวัฒนาการตามเวลาของกระบวนการไปเป็น quantum circuit อย่างมีประสิทธิภาพ และการปรับ circuit ให้เหมาะสมโดยลดความลึก ก็สำคัญไม่แพ้กัน addons ถัดไปอีกสองสามตัวจะจัดการงานเหล่านี้
Multi-product formulas (MPF)
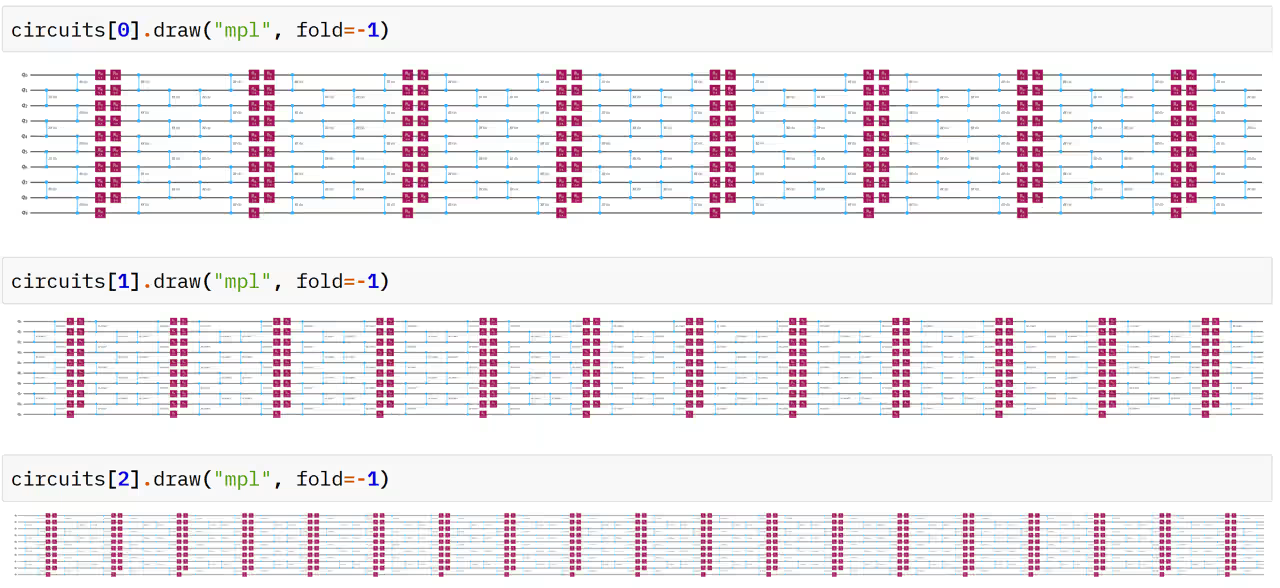
Multi-product formulas ปรับปรุงความแม่นยำของการจำลองวิวัฒนาการตามเวลาแบบควอนตัมโดยรวมการประมาณหลายแบบเข้าด้วยกัน โดยเฉพาะ คุณสร้าง circuit ที่มีจำนวน Trotter steps ต่างกัน เพื่อให้ใช้ผลรวมถ่วงน้ำหนักของผลลัพธ์จาก circuit เหล่านั้นได้ สำหรับความแม่นยำเป้าหมายที่กำหนด MPF มักใช้ circuit ที่ตื้นกว่าวิธี Trotter มาตรฐานได้ ข้อแลกเปลี่ยนคือคุณต้องรันหลาย circuit และรวมผลลัพธ์ด้วยวิธีคลาสสิก
AQC-Tensor
AQC-Tensor ทำ approximate quantum compilation โดยใช้วิธี tensor-network กรณีใช้งานทั่วไปคือแทนที่ส่วนหนึ่งของ circuit ที่ลึกด้วยการประมาณแบบ variational ที่ตื้นกว่า circuit ที่ได้สามารถให้ความแม่นยำใกล้เคียงกันโดยมีความลึกน้อยลงอย่างมาก

Transpilation
คุณใช้ transpilation มาหลายครั้งแล้วในคอร์สนี้ คุณรู้ว่าหลังจากสร้าง circuit แบบนามธรรมแล้ว ต้องเตรียมให้พร้อมสำหรับการรันบนฮาร์ดแวร์ อย่างไรก็ตาม เรายังไม่ได้สำรวจหลายขั้นตอนของ transpilation อย่างละเอียด
ขั้นตอนหลักของ transpilation ได้แก่:
-
Layout: แมป logical qubits ไปยัง physical qubits
-
Translation: เขียน operations ใหม่โดยใช้ชุด gate เนทีฟของ Backend
-
Routing: แทรกและปรับ SWAP operations ให้เหมาะสมตามที่การเชื่อมต่อของฮาร์ดแวร์ต้องการ
กระบวนการเหล่านี้สัมพันธ์กัน ตัวอย่างเช่น layout ควรลดความลึกให้น้อยที่สุดแม้หลังจากคิดรวม routing แล้ว layout ควรหลีกเลี่ยง qubits และการเชื่อมต่อที่มีแนวโน้มเกิดข้อผิดพลาดมากที่สุดด้วย ขั้นตอนเหล่านี้มักทำโดยอัตโนมัติ แต่ผู้ใช้ขั้นสูงอาจเลือกกำหนด layout เองหรือข้อจำกัดอื่นๆ เมื่อจำเป็น

หากต้องการเรียนรู้เพิ่มเติมเกี่ยวกับ transpilation ดูคู่มือ Introduction to transpilation
ตรวจสอบความเข้าใจของคุณ
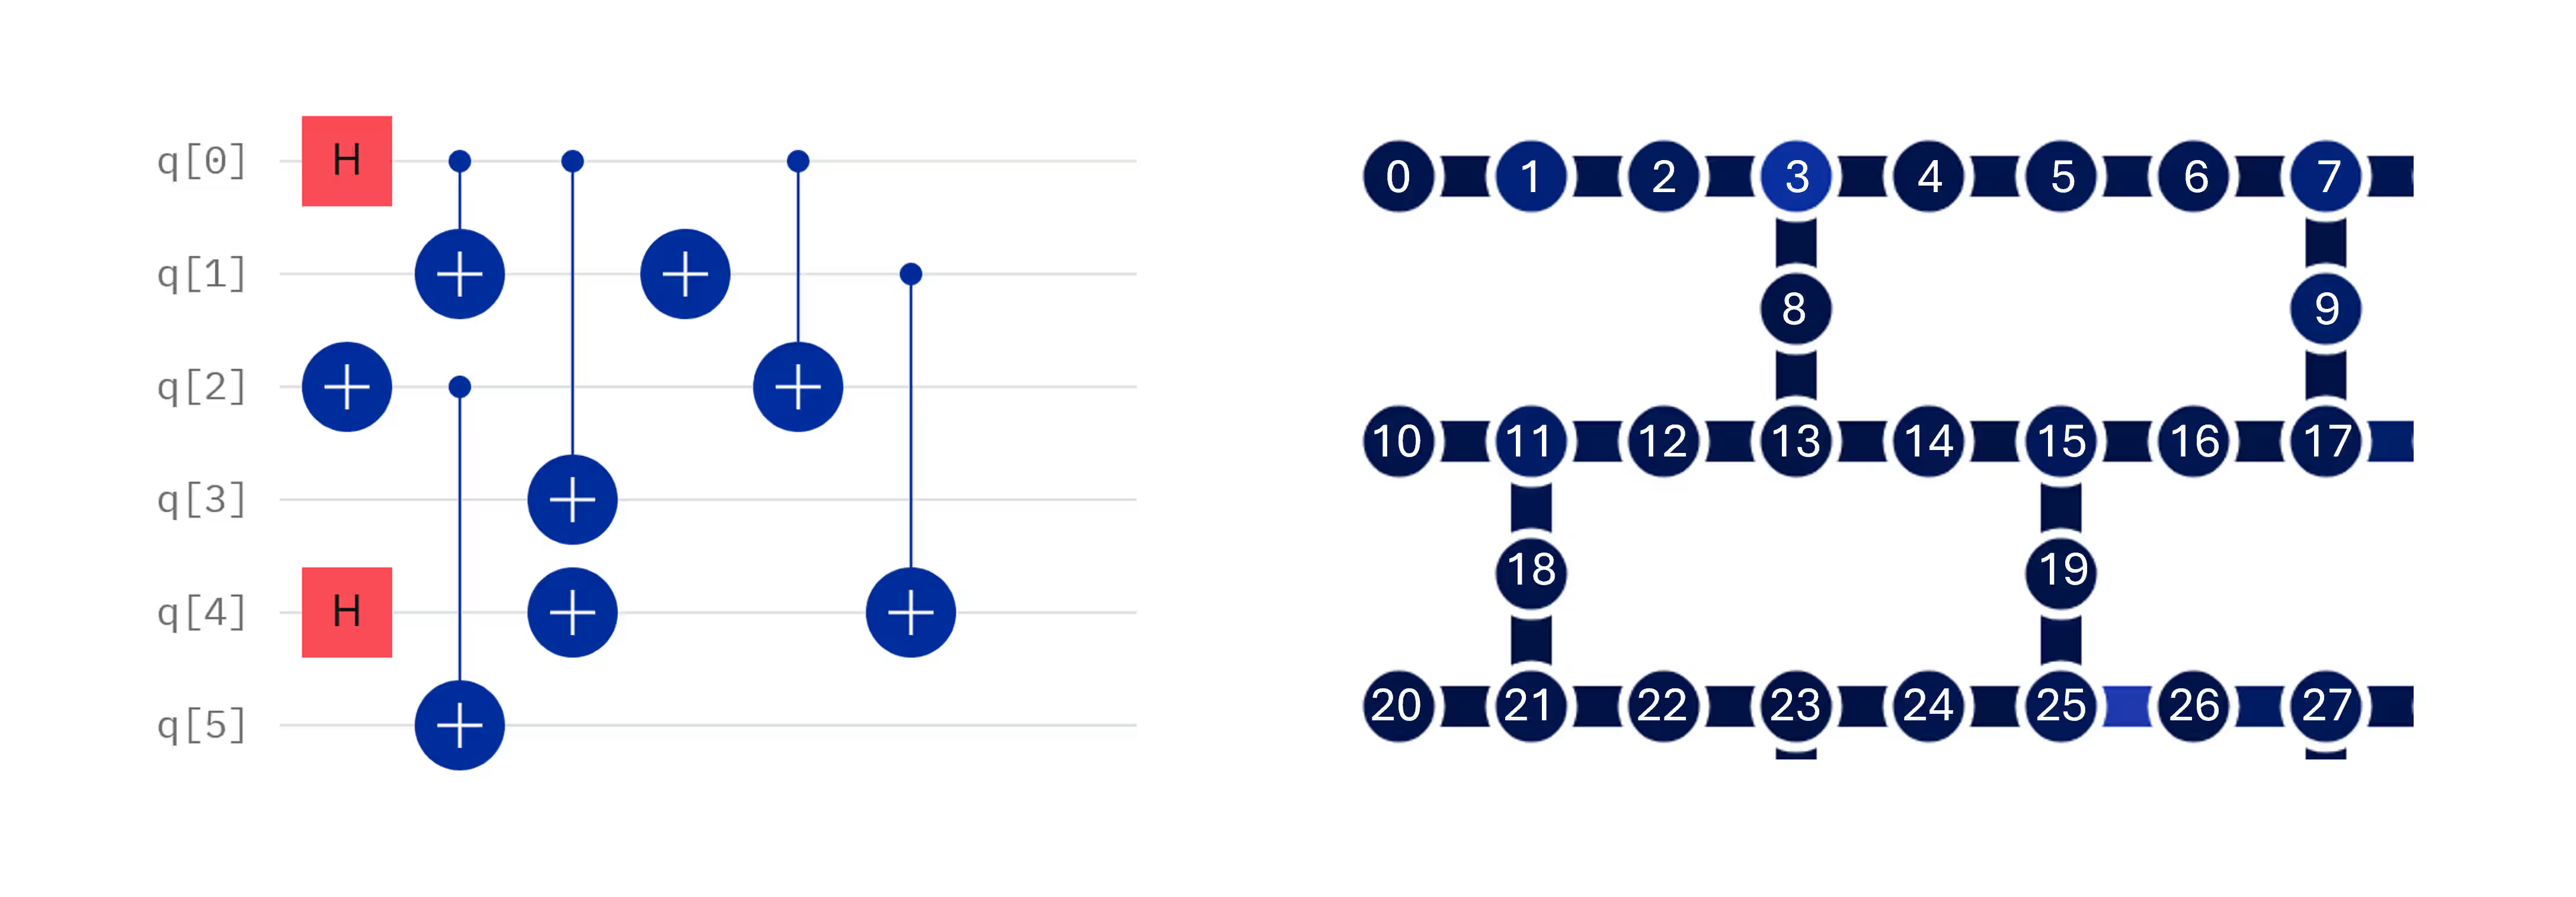
ดู quantum circuit ต่อไปนี้ และสมมติว่าคุณต้องรันบนคอมพิวเตอร์ควอนตัมที่มี layout แบบ heavy-hex ซึ่งแสดงบางส่วน (a) เสนอการแมปจากหมายเลข qubit ใน circuit แบบนามธรรมไปยังหมายเลข qubit ในคอมพิวเตอร์ควอนตัมจริง ที่ทำให้จำนวน SWAP gates ที่ต้องใช้น้อยที่สุด (b) ตัวเลือกของคุณเป็นคำตอบเดียวหรือไม่ หรืออาจมีตัวเลือกอื่นที่ดีเท่ากัน (c) แม้ตัวเลือกของคุณจะเป็น layout ที่ดีที่สุดเพียงแบบเดียวในการลด SWAP gates เพราะเหตุใด Transpiler จึงอาจเลือกการแมปที่ต่างออกไป
คำตอบ
(a) อาจมีคำตอบที่ถูกต้องได้หลายคำตอบ แต่สังเกตว่ามีเพียง abstract qubit 0 เท่านั้นที่มี entangling gate (สอง qubit) กับเพื่อนบ้านสามตัว ตัวอื่นทั้งหมดทำ operation สอง qubit กับเพื่อนบ้านเพียงสองตัว circuit นี้แมปไปยังโทโพโลยี heavy-hex ได้โดยไม่ต้องใช้ SWAP gate เลย layout ใดก็ตามที่ทำได้เช่นนี้ถือว่ายอมรับได้ เมื่อใช้ แทน abstract qubit ศูนย์ และ แทน transpiled qubit ศูนย์ layout หนึ่งคือ:
(b) layout นี้ไม่ใช่แบบเดียว layout อื่นอีกมากก็หลีกเลี่ยง SWAP gates ได้ทั้งหมดเช่นกัน ตัวอย่างอีกแบบคือ:
(c) บางครั้ง qubit ตัวใดตัวหนึ่งมีแนวโน้มเกิดข้อผิดพลาดมากกว่าตัวอื่นส่วนใหญ่บนชิป นอกจากนี้ การเชื่อมต่อระหว่าง qubits บางอันก็เกิดข้อผิดพลาดได้ง่ายกว่าอันอื่น Transpiler พยายามหา layout ที่หลีกเลี่ยง SWAP gates ที่ไม่จำเป็น แต่ก็ใช้ qubits และการเชื่อมต่อที่มี fidelity สูงที่สุดเท่าที่มีบนคอมพิวเตอร์ควอนตัมที่เลือกด้วย
ลดผลกระทบของสัญญาณรบกวนและข้อผิดพลาด
Qiskit addons หลายตัวมุ่งเน้นไปที่การลดผลกระทบของสัญญาณรบกวนและความไม่สมบูรณ์ของฮาร์ดแวร์โดยเฉพาะ
Operator backpropagation และการแปลง circuit ที่คำนึงถึงสัญญาณรบกวน
เราได้พูดถึง operator propagation ในบริบทของ coherent Pauli checks ในการแก้ไขข้อผิดพลาดมาแล้ว อย่างไรก็ตาม operator propagation มีประโยชน์ในวงกว้างกว่านั้น การใช้การแพร่กระจายของ operator ผ่าน quantum circuit มีสองวิธีหลัก: (1) ดูดซับเลเยอร์สุดท้ายสองสามเลเยอร์ของ quantum circuit เข้าไปใน observables ที่วัด และ (2) คำนึงถึงผลที่น่าจะเกิดจากข้อผิดพลาดใน circuit แล้วชดเชยโดยการวัด observable ที่ต่างออกไป เครื่องมือสองตัวถัดไปใช้แนวทางเหล่านี้
Operator backpropagation
Operator backpropagation ลดความลึกของ Circuit โดยดูดซับ gates จากท้าย Circuit เข้าไปใน observable ที่วัด ตัวอย่างเช่น พิจารณา Circuit ต่อไปนี้

circuit นี้มีเลเยอร์การหมุนและ entangling ที่ดูไม่ธรรมดา ตามด้วยบันไดของ CNOT gates และการวัด Z บน qubit 5 circuit นี้มีความลึกสอง qubit เท่ากับ 7 ความลึกนี้เป็นค่าก่อน transpilation ในทางปฏิบัติ โดยทั่วไปคุณใช้ backpropagation หลัง transpilation แต่ตัวอย่างนี้มีไว้เพื่อการสอนเท่านั้น จำไว้ว่ามีกฎสำหรับการแพร่กระจาย observable ผ่าน gate โดยเฉพาะ เมื่อ CNOT gate มี target และ control observable บน จะกลายเป็น เมื่อแพร่กระจายย้อนกลับผ่าน CNOT gate: ใน circuit ตัวอย่างนี้ ถ้าคุณแพร่ observable ย้อนกลับผ่านบันไดของ CNOT gates ทั้งหมด คุณจะได้ observable หรือในสัญกรณ์มาตรฐานของ Qiskit คือ เฉยๆ ถ้าเราวัด observable นี้แทนที่จะวัดแค่ เราก็เอาบันไดของ CNOT gates ทั้งหมดออกได้ ซึ่งลดความลึกสอง qubit จาก 7 เหลือ 2 observable นี้ยังต้องวัดในฐานเดียวบนแต่ละ qubit จึงไม่เพิ่มจำนวน shots ที่เราต้องใช้ แต่ไม่ได้เป็นเช่นนี้เสมอไป โดยทั่วไป observables ที่ซับซ้อนกว่าต้องใช้ shots มากกว่า และบางครั้งต้องวัดในฐานต่างๆ มากขึ้น
กลยุทธ์โดยรวมของ operator backpropagation ประกอบด้วยขั้นตอนต่อไปนี้:
-
ทำให้ circuit ที่รันสั้นลง
-
แทนที่ observable เดิมด้วย observable ที่ขยายแล้ว
-
แลกความลึกของ circuit กับความต้องการการสุ่มตัวอย่างที่เพิ่มขึ้น
circuit ก่อนหน้าเป็นตัวอย่างที่ชัดเจนที่ backpropagation มีประโยชน์ อย่างไรก็ตาม โดยทั่วไปแล้วไม่ง่ายที่จะระบุ circuit ที่ได้ประโยชน์จาก backpropagation มากที่สุด เพื่อตัดสินใจว่าเมื่อไรควรใช้ backpropagation ให้ตรวจสอบว่าคุณลดความลึกจาก circuit ได้มากเท่าใด แล้วชั่งน้ำหนักการลดนั้นกับความต้องการการสุ่มตัวอย่างที่เพิ่มขึ้น
Propagated noise absorption (PNA)
Propagated noise absorption มีโครงสร้างคล้ายกับ operator backpropagation อย่างไรก็ตาม แทนที่จะแพร่ operator ย้อนกลับผ่าน gates ในอุดมคติของ Circuit PNA รวมโมเดลสัญญาณรบกวนที่เรียนรู้มา และแพร่ผลของสัญญาณรบกวนเข้าไปใน observable โดยตรง PNA ทำสิ่งต่อไปนี้:
-
เรียนรู้พฤติกรรมสัญญาณรบกวนจากฮาร์ดแวร์
-
แพร่โมเดลสัญญาณรบกวนผ่าน circuit
-
สร้าง observable ที่ปรับแล้วเพื่อชดเชยสัญญาณรบกวนของ gate
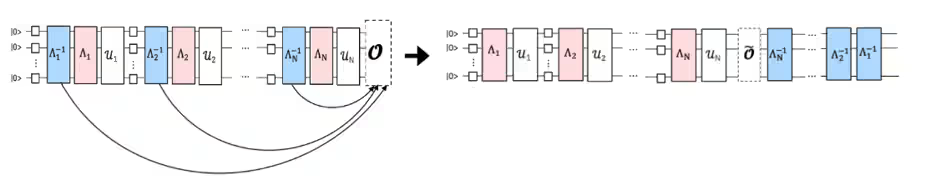
เมื่อวัด observable ที่ปรับแล้วบนฮาร์ดแวร์ที่มีสัญญาณรบกวน ค่าคาดหมายที่ได้จะใกล้เคียงกับผลลัพธ์ในอุดมคติที่ไม่มีสัญญาณรบกวนมากขึ้น PNA มี overhead สองประเภท ประการแรก คุณต้องเรียนรู้โมเดลสัญญาณรบกวน ซึ่งต้องรัน circuit เพิ่มเติม ประการที่สอง PNA อาจสร้าง observables ที่ซับซ้อนขึ้น ซึ่งอาจเพิ่มความต้องการการสุ่มตัวอย่าง
Circuit cutting
Circuit cutting แบ่ง circuit ขนาดใหญ่ออกเป็น subcircuits ที่เล็กกว่าซึ่งรันแยกกันได้ จากนั้นคุณทำการวัดให้เพียงพอเพื่อรวมผลลัพธ์กลับมา Circuit cutting ทำสิ่งต่อไปนี้:
-
ลดความต้องการด้านฮาร์ดแวร์
-
ทำให้คำนวณได้ใหญ่กว่าจำนวน qubits ที่มี (circuit ที่กว้างกว่า)
-
ช่วยจัดการข้อจำกัดด้านความลึกและการเชื่อมต่อ (circuit ที่ลึกกว่า)
-
สร้างผลลัพธ์เดิมกลับมาผ่านการประมวลผลหลังการรันแบบคลาสสิก

Samplomatic
เทคนิคหลายอย่างในส่วนก่อนหน้านี้เสริมวิธีลดทอนและลดผลกระทบอื่นๆ ที่ครอบคลุมตลอดคอร์สนี้ ซึ่งรวมถึง:
-
Dynamical decoupling
-
Pauli twirling
-
M3
-
TREX
-
Zero-noise extrapolation (ZNE)
-
Probabilistic error cancellation (PEC)
ในหลายเวิร์กโฟลว์ คุณสามารถใช้เทคนิคต่างกันกับบริเวณต่างกันของ circuit เดียวกันได้ ดังที่เราได้เห็น เทคนิคเหล่านี้หลายอย่างยังมี overhead ด้านควอนตัมด้วย เราจึงบางครั้งต้องการการควบคุมอย่างละเอียดเกี่ยวกับการเรียนรู้สัญญาณรบกวน การสุ่มตัวอย่าง และการใช้ลำดับ twirling นี่เป็นแรงจูงใจส่วนหนึ่งเบื้องหลัง Samplomatic
Samplomatic เป็นไลบรารีโอเพนซอร์สที่ช่วยให้ทำเวิร์กโฟลว์การสุ่มตัวอย่าง randomization และการลดผลกระทบจากข้อผิดพลาดแบบกำหนดเองได้
งานแรกของมันคือวิเคราะห์ circuit และแบ่งเป็นบริเวณที่มีป้ายกำกับ หรือที่เรียกว่า boxes boxes เหล่านี้มีสองวัตถุประสงค์:
-
แบ่ง circuit ให้เห็นภาพชัดเจน
-
สร้างบริเวณที่มีดัชนีซึ่งกำหนดค่าแยกกันได้
ผู้ใช้สามารถแนบ annotations ที่อธิบายว่าควรจัดการแต่ละ box อย่างไรระหว่างการรัน ตัวอย่างเช่น:
-
ใช้ Pauli twirling กับทุก boxes
-
ใช้ twirling กับ boxes ที่เลือกเท่านั้น
-
ใช้ twirling group ที่ต่างกันในแต่ละบริเวณ
-
ฉีดสัญญาณรบกวนที่เรียนรู้มาเข้าไปในเลเยอร์เฉพาะ
-
ปรับแต่งกลยุทธ์การลดข้อผิดพลาดในระดับละเอียด
Samplomatic ยังระบุบริเวณที่ถูกครอบด้วยกล่องซ้ำกันด้วย เนื่องจากเลเยอร์ที่เหมือนกันมักมีลักษณะสัญญาณรบกวนคล้ายกัน คุณจึงเรียนรู้สัญญาณรบกวนแค่ครั้งเดียวสำหรับแต่ละเลเยอร์ที่ไม่ซ้ำกัน
ผลลัพธ์ของ Samplomatic
Samplomatic สร้างออบเจกต์หลักสองอย่าง
-
Template circuit
-
Samplex
Template circuit คือ Circuit ที่ถูกครอบด้วยกล่อง ผ่านการทรานสไพล์ และมีพารามิเตอร์ พร้อมสำหรับการรัน ส่วน samplex เก็บข้อมูลทั้งหมดที่จำเป็นสำหรับสร้างและประมวลผลตัวแปรของ Circuit เนื้อหาของ samplex ประกอบด้วย
-
ค่าพารามิเตอร์สำหรับ Circuit ที่มีพารามิเตอร์
-
ตัวเลือกการสุ่ม
-
การแจกแจงสำหรับการสุ่มตัวอย่าง
-
ข้อมูลสำหรับการประมวลผลภายหลัง
-
เมทาดาทาการรันเพิ่มเติม
พูดอย่างเป็นทางการ samplex คือการแจกแจงความน่าจะเป็นเหนือพารามิเตอร์ของ template circuit พร้อมข้อมูลเสริมที่จำเป็นสำหรับการรันและการประมวลผลภายหลัง ข้อดีเชิงปฏิบัติที่สำคัญคือทั้ง template circuit และ samplex ถูกสร้างในเครื่องฝั่งไคลเอนต์ ดังนั้นคุณจึงตรวจสอบ ยืนยันความถูกต้อง และดีบักได้ก่อนใช้ทรัพยากรฮาร์ดแวร์ใดๆ
Samplomatic มีข้อดีมากมาย รวมถึงการควบคุมการจัดสรรช็อตแบบปรับตัวและการสุ่มในระดับละเอียด และยังมีข้อดีด้านโลจิสติกส์ เช่น เวิร์กโฟลว์การประมวลผลภายหลังที่มีโครงสร้าง ข้อดีที่สำคัญที่สุดอย่างหนึ่งคือการนำข้อมูลสัญญาณรบกวนที่เรียนรู้แล้วกลับมาใช้ซ้ำข้ามเลเยอร์ที่เหมือนกัน ซึ่งช่วยประหยัดเวลาคอมพิวเตอร์ควอนตัมได้มากในช่วงเรียนรู้สัญญาณรบกวน
Shaded lightcones
ก่อนตัดสินใจว่าจะใช้เทคนิคลดข้อผิดพลาดที่มีต้นทุนสูงตรงไหน การระบุบริเวณของ Circuit ที่สำคัญที่สุดต่อ observable ที่วัดอยู่จะช่วยได้มาก ความจำเป็นนี้เป็นที่มาของแอดออน shaded lightcones แนวคิดเรื่อง lightcone มาจากทฤษฎีสัมพัทธภาพ ซึ่งความสัมพันธ์เชิงเหตุและผลถูกจำกัดด้วยความเร็วจำกัดที่ข้อมูลเดินทางได้
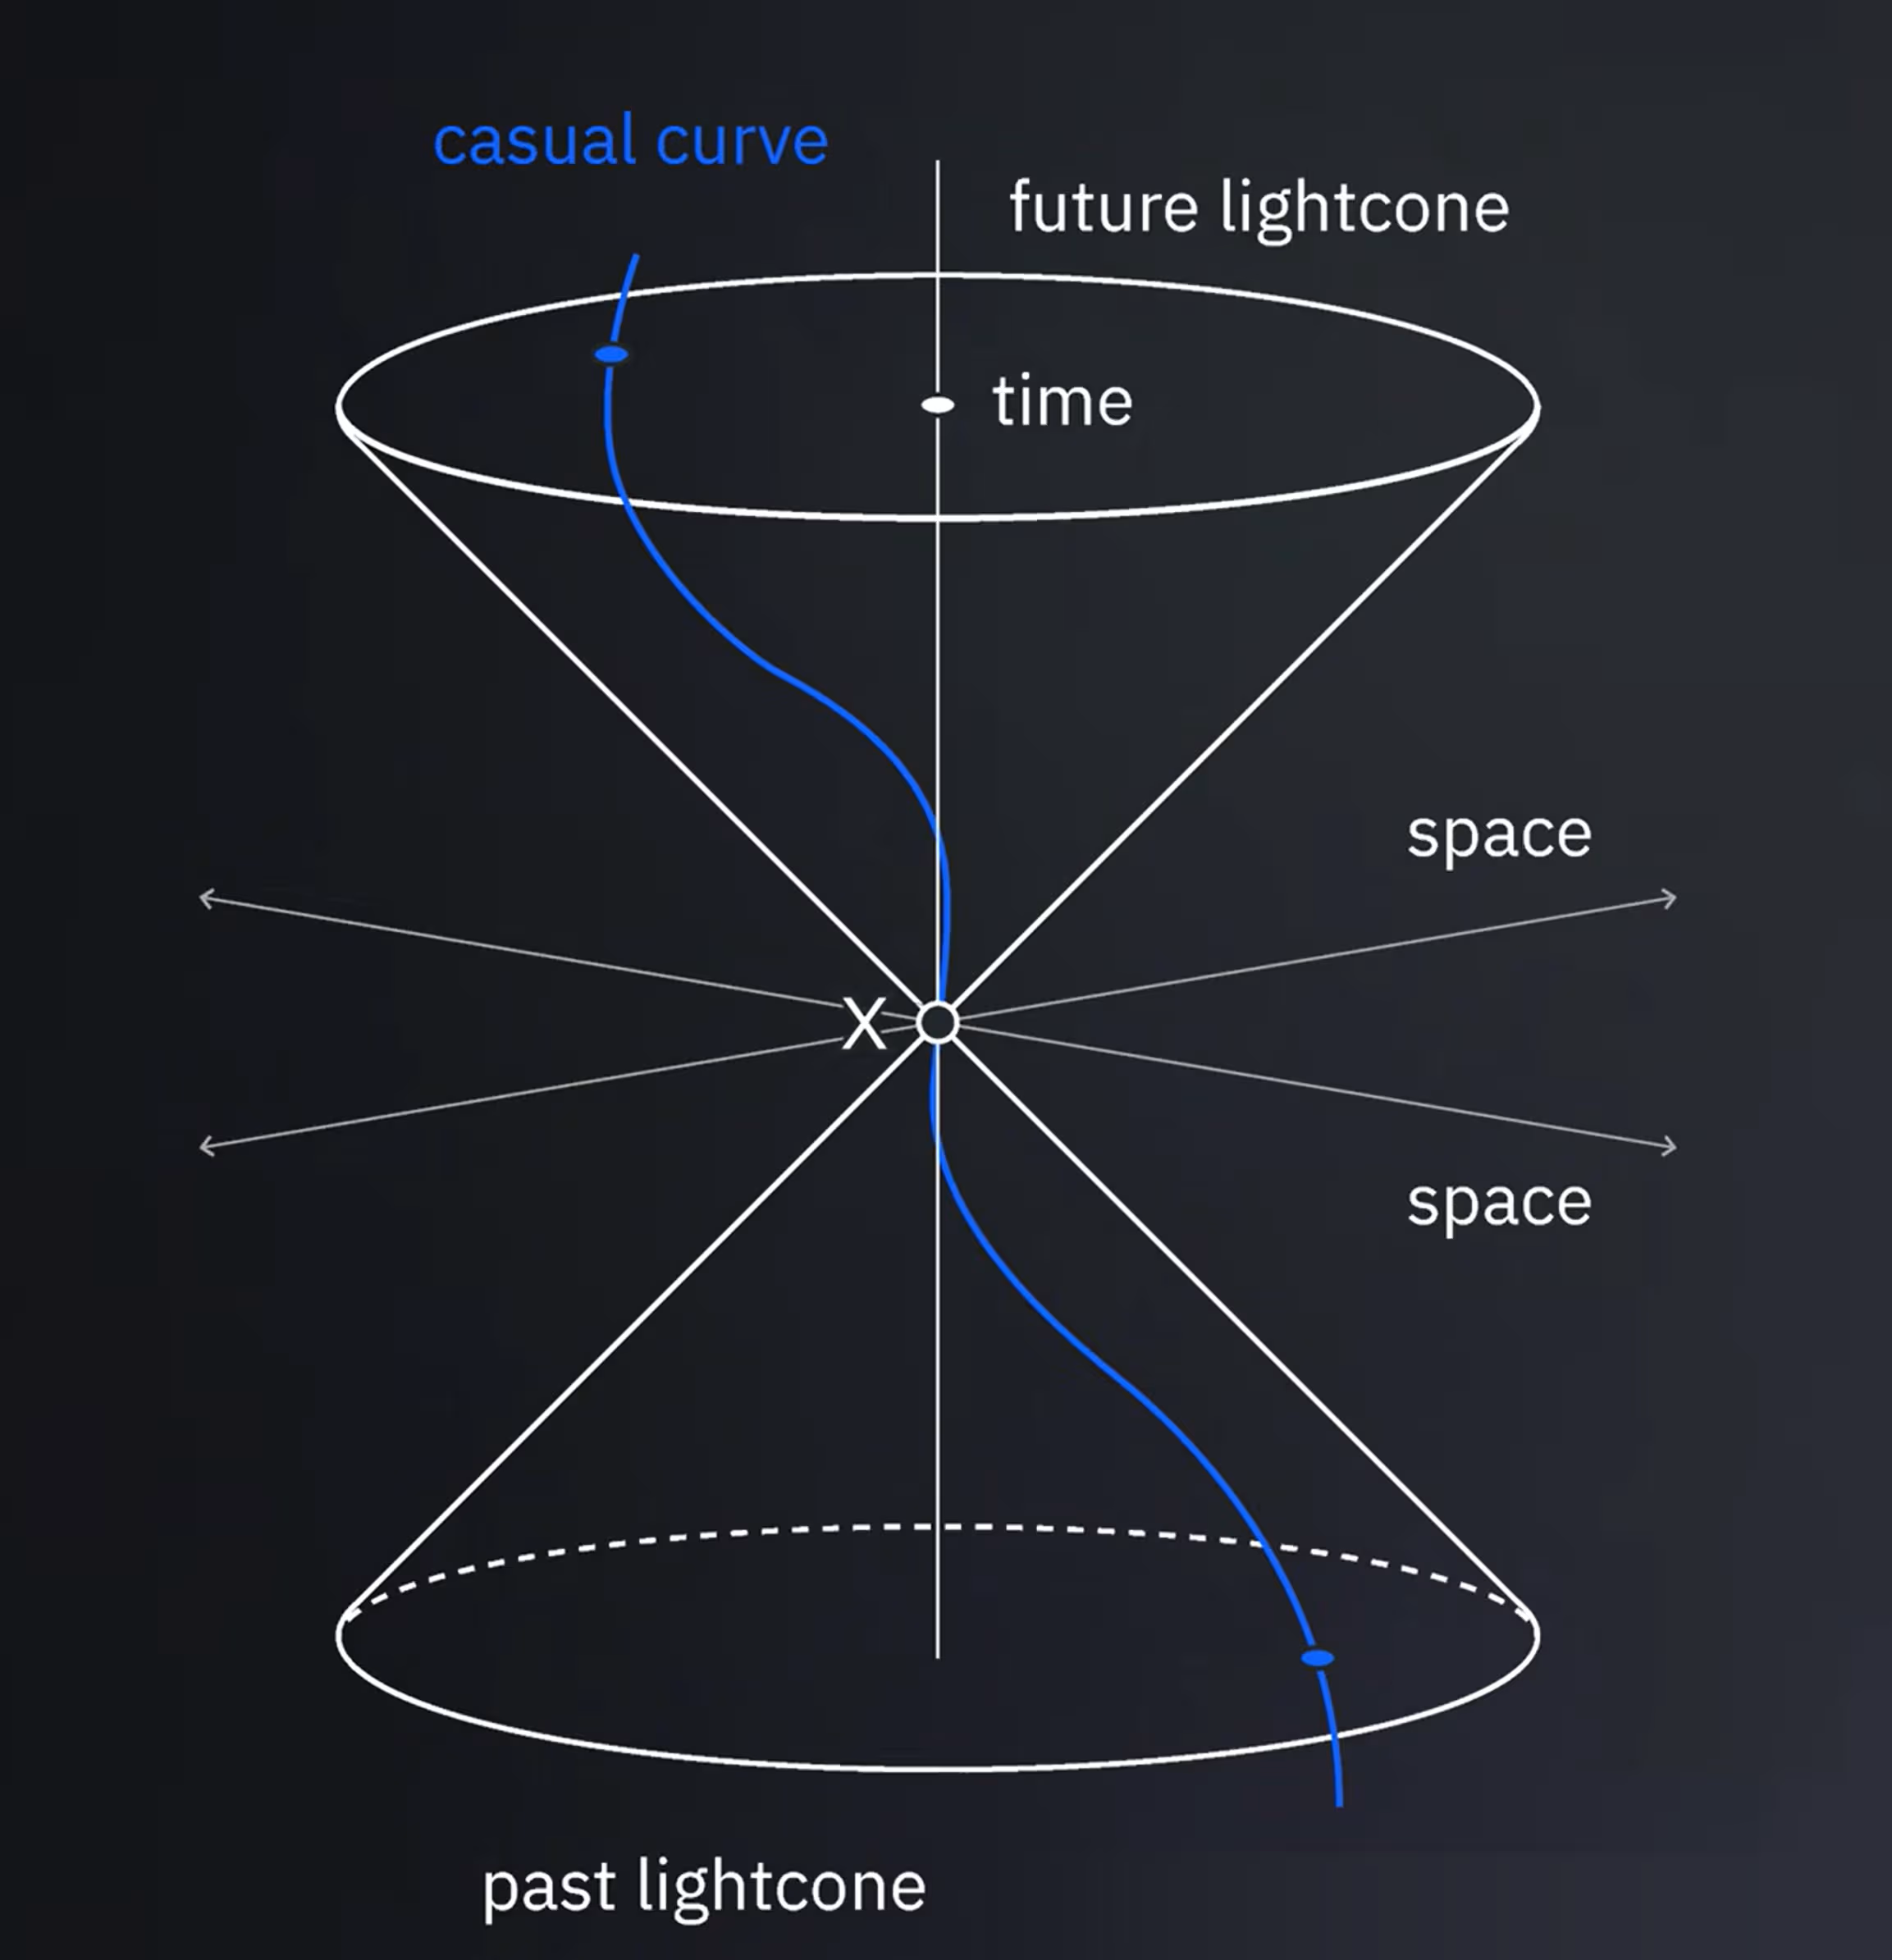
แนวคิดคล้ายกันนี้ใช้ได้กับ Circuit ควอนตัมด้วย
ลองพิจารณา Circuit ขนาดใหญ่ที่สนใจแค่ observable น้ำหนักต่ำ observable น้ำหนักต่ำคือตัวที่กระทำแบบไม่ธรรมดากับ qubit เพียงไม่กี่ตัว เราสนใจ observable น้ำหนักต่ำด้วยหลายเหตุผล เช่น มันอาจแทนสิ่งต่อไปนี้
-
เทอมแต่ละตัวภายใน Hamiltonian ที่ใหญ่กว่า
-
บริเวณปฏิสัมพันธ์เฉพาะที่
-
ข้อมูลที่รวบรวมไว้บน ancilla qubit ชุดเล็กๆ
-
observable อื่นๆ ที่เกี่ยวข้องกับ qubit เพียงไม่กี่ตัว
ข้อผิดพลาดใน Circuit ไม่ใช่ทุกตัวที่จะส่งผลต่อผลการวัดได้ โดยเฉพาะข้อผิดพลาดแบบ Pauli หรือข้อผิดพลาดใดๆ ที่จำลองเป็นชุดของการดำเนินการ Pauli ได้ ตัวอย่างเช่น ดู Circuit ต่อไปนี้
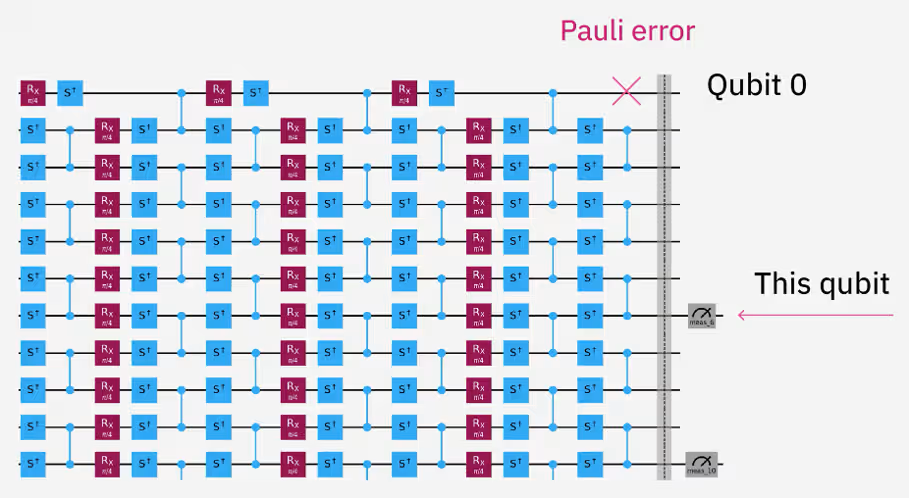
ข้อผิดพลาดแบบ Pauli บน qubit 0 ในเลเยอร์สุดท้ายไม่สามารถส่งผลต่อการวัดบน qubit 6 ได้ เพราะไม่มี Gate เชื่อมที่จะส่งต่อข้อผิดพลาดจาก qubit 0 ไป qubit 6 โปรดทราบว่าข้อโต้แย้งนี้ไม่ครอบคลุมข้อผิดพลาดแบบ non-unitary บางชนิด เช่น การเปลี่ยนสถานะแบบ T1 ไปสู่สถานะพื้นบน qubit 0 ซึ่งทำให้ qubit 0 ยุบลงสู่สถานะฐานคำนวณ ถ้า qubit 0 กับ 6 เคยเอนแทงเกิลกันมาก่อน (เหมือนใน Circuit นี้) ข้อผิดพลาด non-unitary บน qubit 0 ก็อาจส่งผลต่อ qubit 6 ได้ การอภิปรายต่อไปนี้เน้นที่ข้อผิดพลาดที่แทนได้ด้วยการดำเนินการ Pauli หรือส่วนผสมเชิงความน่าจะเป็นของการดำเนินการ Pauli
ในเลเยอร์สุดท้าย มีเพียงข้อผิดพลาดแบบ Pauli บน qubit 5 หรือ qubit 6 เท่านั้นที่ส่งผลโดยตรงต่อการวัดบน qubit 6 ได้
ในเลเยอร์เอนแทงเกิลก่อนหน้านั้น qubit 5 และ 6 เอนแทงเกิลกับ qubit 4 และ 7 ตามลำดับ ดังนั้น ในเลเยอร์เอนแทงเกิลนั้นหรือก่อนหน้านั้นเล็กน้อย ข้อผิดพลาดแบบ Pauli บน qubit ใดก็ตามในสี่ตัวนี้ส่งผลต่อการวัดที่ตามมาได้ คุณตามย้อนกลับผ่าน Circuit ต่อไปเพื่อหาเซตย่อยของ Gate และ qubit ที่เชื่อมโยงเชิงเหตุผลกับการวัดได้ เซตเชิงเหตุผลนี้ก่อให้เกิดบริเวณรูปกรวยในมิติของพื้นที่ (qubit) และเวลา (เลเยอร์) ซึ่งเป็นที่มาของคำว่า lightcone รูปร่างที่แน่นอนของบริเวณนี้ต่างกันไปในแต่ละ Circuit เนื่องจากการวิเคราะห์นี้ขึ้นกับการเชื่อมต่อของฮาร์ดแวร์และตำแหน่งของ Gate จึงมีประโยชน์ที่สุดหลังการทรานสไพล์ การกำหนดเส้นทาง และการปรับเลย์เอาต์ให้เหมาะสม
เหนือกว่าการเชื่อมต่อเชิงเหตุผล
Shaded lightcones ขยายแนวคิดนี้โดยพิจารณาด้วยว่าข้อผิดพลาดชนิดใดสำคัญ
ตัวอย่างเช่น สังเกตสิ่งต่อไปนี้
-
ข้อผิดพลาดแบบ Z ก่อนการวัดในฐาน Z ทันทีไม่ส่งผลต่อผลการวัด
-
ข้อผิดพลาดแบบ X ก่อนการวัดในฐาน Z ทันทีเปลี่ยนผลลัพธ์ได้อย่างมาก
ดังนั้นข้อผิดพลาดบางชนิดจึงควรได้รับความพยายามในการลดมากกว่าชนิดอื่น ความแตกต่างนี้ช่วยลดต้นทุนของเทคนิคอย่าง PEC ได้มาก ในทางปฏิบัติ แอดออนจะสร้างการวิเคราะห์ความไวแยกกันสำหรับข้อผิดพลาดแต่ละชนิดต่อไปนี้
-
X errors
-
Z errors
-
ข้อผิดพลาดแบบ Y (หรือ XZ จนถึงเฟส)
ความไวต่อข้อผิดพลาดนี้โดยทั่วไปดูต่างกันไปในแต่ละชนิดข้อผิดพลาด เพราะข้อผิดพลาดที่เชื่อมโยงเชิงเหตุผลต่างกันส่งผลต่อการวัดต่างกัน และโปรดทราบว่าความไวเปลี่ยนไปตลอดทั้ง Circuit ข้อผิดพลาดแบบ X ก่อนการวัดทันทีอาจสร้างความเสียหายมาก ขณะที่ข้อผิดพลาดที่เกิดขึ้นหลายเลเยอร์ก่อนหน้านั้นอาจมีผลน้อยกว่าหลังจากแพร่ผ่านสถานะที่เอนแทงเกิลสูง
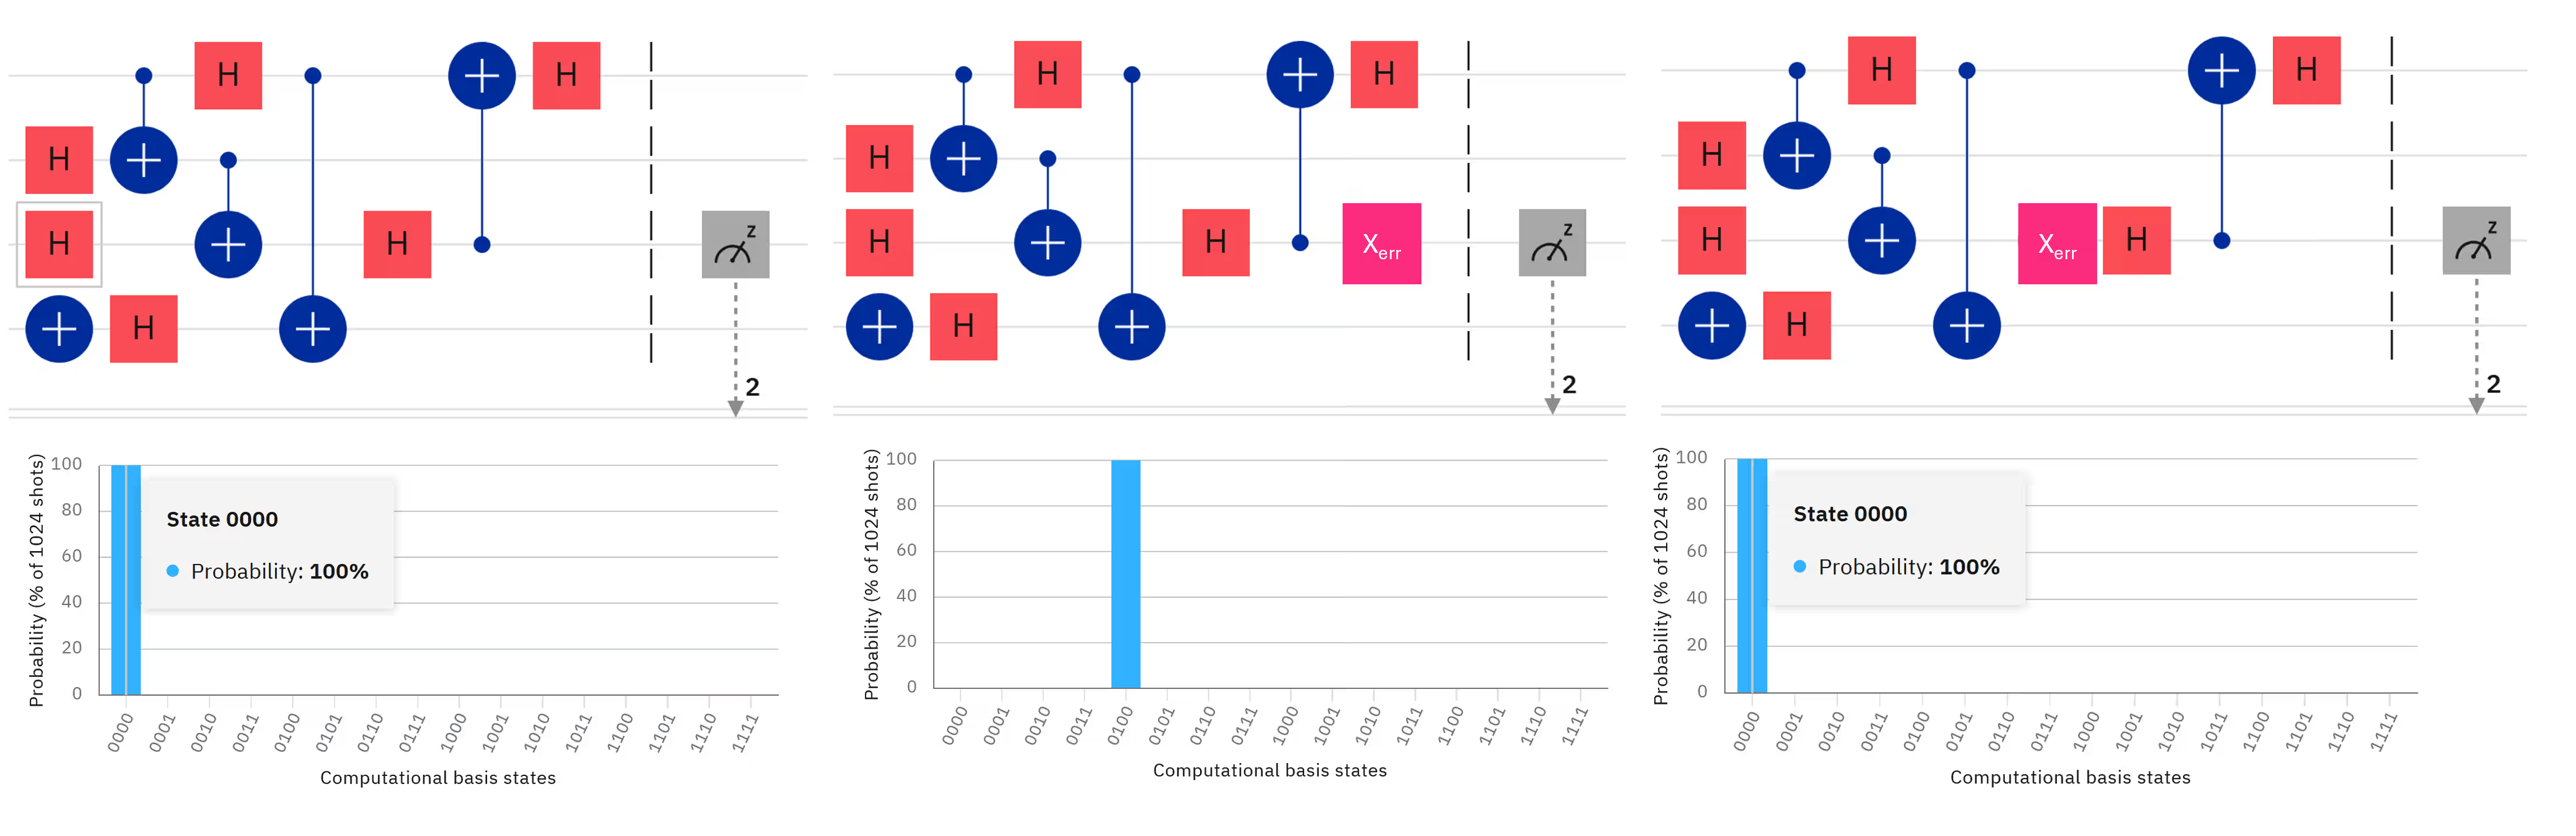
Shaded lightcones วัดปริมาณความแตกต่างนี้โดยกำหนดค่าความไวให้กับข้อผิดพลาดที่อาจเกิดขึ้นทั่วทั้ง Circuit
แผนที่ที่ได้บ่งชี้สิ่งต่อไปนี้
-
ข้อผิดพลาดสำคัญตรงไหน
-
ข้อผิดพลาดชนิดใดสำคัญ
-
ข้อผิดพลาดเหล่านั้นส่งผลต่อ observable สุดท้ายมากแค่ไหน
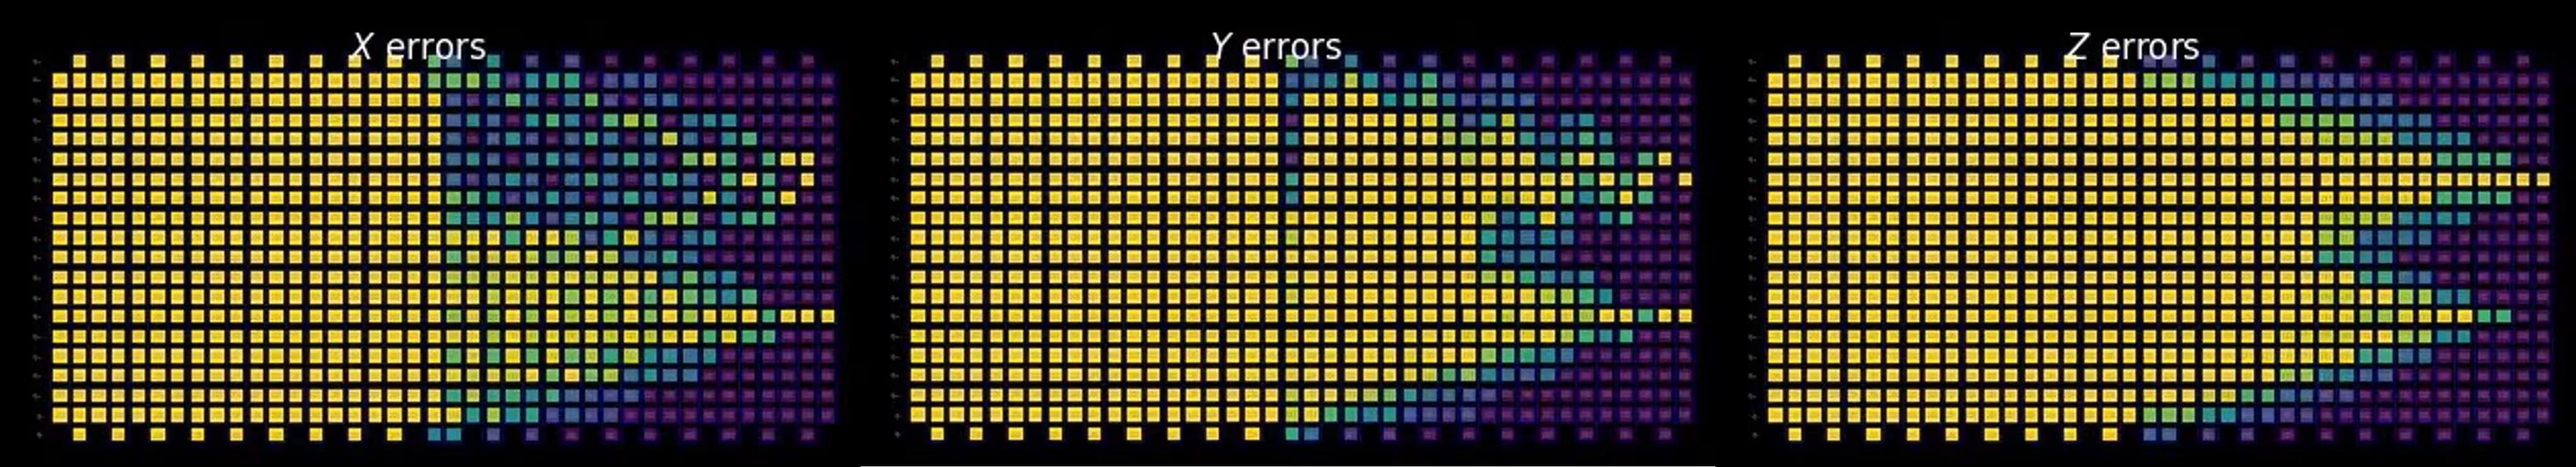
Shaded lightcones ไม่ได้ลดข้อผิดพลาดด้วยตัวเอง แต่ช่วยให้โฟกัสความพยายามในการลดข้อผิดพลาดไปยังจุดที่ให้ประโยชน์สูงสุดได้
เรียนรู้และฉีดสัญญาณรบกวน
หลังจากสร้าง ปรับให้เหมาะสม และใส่คำอธิบายประกอบ Circuit แล้ว ยังเหลืองานเสริมกันสองอย่าง คือ การเรียนรู้สัญญาณรบกวน และการใช้โมเดลสัญญาณรบกวน (เช่น เพื่อฉีดสัญญาณรบกวนหรือแพร่ผลของสัญญาณรบกวน)
NoiseLearnerV3
NoiseLearnerV3 คือเครื่องมือปัจจุบันสำหรับเรียนรู้สัญญาณรบกวน อินเทอร์เฟซ NoiseLearner รุ่นก่อนรับ Circuit ทั้งชุดและสร้างโมเดลสัญญาณรบกวนแบบ Pauli-Lindblad ส่วน NoiseLearnerV3 ทำงานโดยตรงกับคำสั่ง Circuit ที่ถูกครอบด้วยกล่อง สรุปแล้ว NoiseLearnerV3 ทำสิ่งต่อไปนี้
-
รับชุดของเลเยอร์ Circuit ที่มีป้ายกำกับ
-
นำข้อมูลจากเลเยอร์ที่ซ้ำกันกลับมาใช้ซ้ำ
-
รองรับการเรียนรู้สัญญาณรบกวนจากการวัด
-
รองรับการประมวลผลภายหลังของโมเดลที่เรียนรู้มา
-
เปิดใช้เวิร์กโฟลว์การฉีดและการปรับสเกลสัญญาณรบกวน
การออกแบบนี้สอดคล้องกับเวิร์กโฟลว์แบบเน้นเลเยอร์ของ Samplomatic อย่างใกล้ชิด โดยเฉพาะ NoiseLearnerV3 ใช้วิธีต่อไปนี้กับชุดคำสั่งแต่ละชุด
-
การเรียนรู้แบบ Pauli-Lindblad สำหรับการดำเนินการของ Gate
-
การเรียนรู้แบบอิง TREX สำหรับการวัด
จากนั้นคุณใช้โมเดลสัญญาณรบกวนที่เรียนรู้มาในหลายวิธีที่เราครอบคลุมไปแล้วได้ ตัวอย่างเช่น ลองนึกถึง zero-noise extrapolation (ZNE) ที่ใช้การพับ Gate ซึ่งอาจทำให้ Circuit ลึกจนแก้ไม่ได้ วิธีทางเลือกในการปรับสเกลสัญญาณรบกวนในกรณีนั้นคือการสุ่มตัวอย่างจากโมเดลสัญญาณรบกวนที่ทราบ ซึ่งเพิ่มระดับสัญญาณรบกวนได้อย่างมีประสิทธิภาพ แม้ด้วยตัวคูณที่ไม่ใช่จำนวนเต็ม วิธีนี้คือ probabilistic error amplification (PEA) เป็นตัวอย่างที่ดีของการใช้โมเดลสัญญาณรบกวนเพื่อลดข้อผิดพลาด โมเดลสัญญาณรบกวนที่ดียังจำเป็นสำหรับ probabilistic error cancellation (PEC) และ propagated noise absorption (PNA) ด้วย
สรุปคือ เมื่อมีโมเดลสัญญาณรบกวนคุณภาพสูง สัญญาณรบกวนจะกลายเป็นทรัพยากรที่โปรแกรมได้ ไม่ใช่เป็นเพียงแหล่งของข้อผิดพลาด
Shaded lightcones เทียบกับ NoiseLearnerV3
NoiseLearnerV3 และ SLC เกี่ยวข้องกันอย่างใกล้ชิด แต่รับอินพุตต่างกันและตอบคำถามต่างกัน SLC กำหนดว่าควรโฟกัสความพยายามลดข้อผิดพลาดตรงไหน ส่วน NoiseLearnerV3 ระบุลักษณะของสัญญาณรบกวนจริงในบริเวณเหล่านั้น สองกระบวนการนี้ยังมีต้นทุนต่างชนิดกันด้วย ตารางต่อไปนี้สรุปความแตกต่างเหล่านี้
| Shaded lightcones | NoiseLearnerV3 | |
|---|---|---|
| จุดประสงค์ | ระบุว่าการลดข้อผิดพลาดสำคัญตรงไหน | เรียนรู้ว่าข้อผิดพลาดมีพฤติกรรมอย่างไร |
| ต้นทุน | ส่วนใหญ่เป็นต้นทุนแบบคลาสสิก | ต้องรันบนฮาร์ดแวร์ |
| เอาต์พุต | สร้างแผนที่ความไว | สร้างคำอธิบายแชนเนลสัญญาณรบกวน |
| อินพุต | ใช้โครงสร้าง Circuit และการแพร่ของตัวดำเนินการ | ใช้โครงสร้าง Circuit และข้อมูลฮาร์ดแวร์เชิงทดลอง |
Executor และการรันบน runtime
Executor ทำขั้นตอนการรันสุดท้าย โดยทำงานกับอินพุตอย่างใดอย่างหนึ่งต่อไปนี้ได้
-
template circuit และ samplex ที่ Samplomatic สร้างขึ้น
-
Circuit ควอนตัมทั่วไปที่ไม่ใช้ Samplomatic
ด้วยความยืดหยุ่นนี้ คุณเลือกใช้ส่วนประกอบของเวิร์กโฟลว์การรันแบบกำหนดทิศทางมากหรือน้อยเท่าที่ต้องการได้
Executor ทำงานร่วมกับ Samplomatic อย่างใกล้ชิด ซึ่งจัดการตัวเลือกการสุ่ม การจัดสรรช็อต ตัวเลือกการฉีดสัญญาณรบกวน และเมทาดาทาการรันที่เกี่ยวข้อง ตามที่อธิบายไว้ก่อนหน้านี้
สำหรับตัวอย่างเชิงปฏิบัติของโมเดลการรันแบบกำหนดทิศทาง ดูคู่มือ Directed execution model รวมถึงบทเรียนและเอกสารแอดออน Qiskitบน IBM Quantum® Platform
บทสรุป
เวิร์กโฟลว์ควอนตัมสมัยใหม่พึ่งพาชุดเครื่องมือที่เสริมกันมากขึ้นเรื่อยๆ แทนที่จะใช้ primitive การรันเพียงตัวเดียว
เครื่องมือเหล่านี้รองรับทุกขั้นตอนของเวิร์กโฟลว์
-
การแมปปัญหา
-
การสร้าง Circuit
-
การทรานสไพล์และการปรับให้เหมาะสม
-
การระงับข้อผิดพลาด
-
การลดข้อผิดพลาด
-
การเรียนรู้สัญญาณรบกวน
-
การรันแบบมีโครงสร้าง
-
การประมวลผลภายหลัง
เครื่องมืออย่าง Samplomatic, Executor, NoiseLearnerV3, shaded lightcones, propagated noise absorption, circuit cutting และ AQC-Tensor ที่ใช้ร่วมกันให้การควบคุมมากกว่าโมเดลการรันรุ่นก่อนอย่างมีนัยสำคัญ
สาขานี้ยังคงพัฒนาอย่างรวดเร็ว เมื่อโปรเซสเซอร์ควอนตัมใหญ่ขึ้นและเชื่อมต่อกันมากขึ้น เทคนิคเหล่านี้น่าจะมีบทบาทสำคัญยิ่งขึ้นในการบรรลุความได้เปรียบเชิงควอนตัมที่เป็นประโยชน์จริง และท้ายที่สุดจะผสานเข้ากับเวิร์กโฟลว์คอมพิวเตอร์ควอนตัมที่ทนต่อข้อผิดพลาดได้อย่างราบรื่น