Quantum Portfolio Optimizer: Qiskit Function โดย Global Data Quantum
Qiskit Functions เป็นฟีเจอร์ทดลองที่ให้บริการเฉพาะสำหรับผู้ใช้ IBM Quantum® Premium Plan, Flex Plan และ On-Prem (via IBM Quantum Platform API) Plan เท่านั้น ขณะนี้อยู่ในสถานะ preview release และอาจมีการเปลี่ยนแปลง
ภาพรวม
Quantum Portfolio Optimizer คือ Qiskit Function ที่ออกแบบมาเพื่อแก้ปัญหา dynamic portfolio optimization ซึ่งเป็นปัญหาพื้นฐานในด้านการเงินที่มุ่งปรับสัดส่วนการลงทุนเป็นระยะ ๆ ในสินทรัพย์หลายประเภท เพื่อเพิ่มผลตอบแทนและลดความเสี่ยง ด้วยการใช้เทคนิค quantum optimization ล้ำสมัย ฟังก์ชันนี้ทำให้กระบวนการง่ายขึ้น ผู้ใช้ที่ไม่มีความเชี่ยวชาญด้าน quantum computing ก็สามารถได้รับประโยชน์จากมันในการหา investment trajectory ที่ดีที่สุด เหมาะสำหรับผู้จัดการพอร์ตโฟลิโอ นักวิจัยด้าน quantitative finance และนักลงทุนทั่วไป เครื่องมือนี้รองรับการ back-testing กลยุทธ์การซื้อขายในการ optimize พอร์ตโฟลิโอ
คำอธิบายฟังก์ชัน
Quantum Portfolio Optimizer ใช้อัลกอริทึม Variational Quantum Eigensolver (VQE) เพื่อแก้ปัญหา Quadratic Unconstrained Binary Optimization (QUBO) สำหรับ dynamic portfolio optimization ผู้ใช้เพียงแค่ระบุข้อมูลราคาสินทรัพย์และกำหนดเงื่อนไขการลงทุน จากนั้นฟังก์ชันจะรันกระบวนการ quantum optimization และคืนค่าชุด investment trajectory ที่ optimize แล้ว
กระบวนการประกอบด้วยสี่ขั้นตอนหลัก ขั้นแรก ข้อมูล input จะถูก map ไปยังปัญหาที่ compatible กับ quantum โดยสร้าง QUBO ของ dynamic portfolio optimization และแปลงเป็น quantum operator (Ising Hamiltonian) ต่อมา ปัญหา input และอัลกอริทึม VQE จะถูกปรับแต่งเพื่อรันบน quantum hardware จากนั้นรัน VQE บน quantum hardware และสุดท้ายผลลัพธ์จะถูก post-process เพื่อให้ได้ investment trajectory ที่ดีที่สุด ระบบยังมี noise-aware (SQD-based) post-processing เพื่อเพิ่มคุณภาพของ output ด้วย
Qiskit Function นี้อ้างอิงจาก บทความที่ตีพิมพ์ โดย Global Data Quantum

เริ่มต้นใช้งาน
ยืนยันตัวตนด้วย API key และเลือก Qiskit Function ดังนี้ (โค้ดนี้สมมติว่าคุณบันทึก account ไว้ในเครื่องแล้ว)
# Added by doQumentation — required packages for this notebook
!pip install -q pandas qiskit-ibm-catalog
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(qunova/hivqe-chemistry),
 QiskitFunction(global-data-quantum/quantum-portfolio-optimizer),
 QiskitFunction(algorithmiq/tem),
 QiskitFunction(qedma/qesem),
 QiskitFunction(multiverse/singularity),
 QiskitFunction(ibm/circuit-function),
 QiskitFunction(q-ctrl/optimization-solver),
 QiskitFunction(colibritd/quick-pde),
 QiskitFunction(q-ctrl/performance-management),
 QiskitFunction(kipu-quantum/iskay-quantum-optimizer)]
# Access function
dpo_solver = catalog.load("global-data-quantum/quantum-portfolio-optimizer")
ตัวอย่าง: Dynamic portfolio optimization กับเจ็ดสินทรัพย์
ตัวอย่างนี้แสดงวิธีรัน dynamic portfolio optimization (DPO) function และปรับแต่งการตั้งค่าเพื่อประสิทธิภาพสูงสุด โดยมีขั้นตอนละเอียดสำหรับการ fine-tune พารามิเตอร์เพื่อให้ได้ผลลัพธ์ที่ต้องการ
กรณีนี้ใช้เจ็ดสินทรัพย์ สี่ time steps และสี่ resolution qubits ทำให้ต้องการ Qubit รวมทั้งหมด 112 ตัว
1. อ่านสินทรัพย์ที่รวมอยู่ใน portfolio
หากสินทรัพย์ทั้งหมดในพอร์ตโฟลิโอถูกเก็บไว้ในโฟลเดอร์ที่พาธเฉพาะ คุณสามารถโหลดสินทรัพย์เหล่านั้นลงใน pandas.DataFrame และแปลงเป็นอ็อบเจ็กต์รูปแบบ dict โดยใช้ฟังก์ชันต่อไปนี้
import os
import glob
import pandas as pd

def read_and_join_csv(file_pattern):
    """
    Reads multiple CSV files matching the file pattern and combines them
    into a single DataFrame.

    Parameters:
    file_pattern (str): The pattern to match CSV files.

    Returns:
    pd.DataFrame: Combined DataFrame with data from all CSV files.
    """
    # Find all files matching the pattern
    csv_files = glob.glob(file_pattern)
    # Get the base file names without the .csv extension
    file_names = [os.path.basename(f).replace(".csv", "") for f in csv_files]
    # Read each CSV file into a DataFrame and set the first column as the index
    df_list = [pd.read_csv(f).set_index("Unnamed: 0") for f in csv_files]

    # Rename columns in each DataFrame to the base file names
    for df, name in zip(df_list, file_names):
        df.columns = [name]

    # Combine all DataFrames into one by merging them side by side
    combined_df = pd.concat(df_list, axis=1)
    return combined_df

file_pattern = "route/to/folder/with/assets/data/*.csv"
assets = read_and_join_csv(file_pattern).to_dict()
สำหรับตัวอย่างนี้ เราใช้สินทรัพย์ 8801.T, CLF, GBPJPY, ITX.MC, META, TMBMKDE-10Y และ XS2239553048 รูปต่อไปนี้แสดงข้อมูลที่ใช้ในตัวอย่างนี้ โดยแสดงการเปลี่ยนแปลงของราคาปิดรายวันของสินทรัพย์ตั้งแต่วันที่ 1 มกราคม ถึง 1 กันยายน ปี 2023
ในตัวอย่างนี้ เพื่อให้มั่นใจถึงความสม่ำเสมอในทุกวันที่ เราได้เติมวันที่ไม่มีการซื้อขายด้วยราคาปิดจากวันที่มีข้อมูลก่อนหน้า เราทำขั้นตอนนี้เพราะสินทรัพย์ที่เลือกมาจากตลาดที่แตกต่างกันซึ่งมีวันซื้อขายที่แตกต่างกัน ทำให้จำเป็นต้องทำให้ชุดข้อมูลเป็นมาตรฐานเพื่อความสอดคล้อง

2. กำหนดปัญหา
กำหนด specification ของปัญหาโดยตั้งค่าพารามิเตอร์ใน dictionary qubo_settings
qubo_settings = {
    "nt": 4,
    "nq": 4,
    "dt": 30,
    "max_investment": 25,
    "risk_aversion": 1000.0,
    "transaction_fee": 0.01,
    "restriction_coeff": 1.0,
}
3. กำหนดการตั้งค่า optimizer และ ansatz (ไม่บังคับ)
ตั้งค่าเฉพาะสำหรับกระบวนการ optimization ได้ตามต้องการ รวมถึงการเลือก optimizer และพารามิเตอร์ของมัน รวมถึงการระบุ primitive และการตั้งค่าต่าง ๆ
สำหรับ Tailored Ansatz ขนาด population size ที่เลือกมาจากการทดลองก่อนหน้าที่แสดงว่าค่านี้ให้ผล optimization ที่เสถียรและมีประสิทธิภาพ
สำหรับ Real Amplitudes Ansatz สามารถใช้ความสัมพันธ์เชิงเส้นระหว่าง population_size กับจำนวน Qubit ใน Circuit ได้ ตามกฎคร่าว ๆ แนะนำให้ใช้ population_size ~ 0.8 * n_qubits ขั้นต่ำ สำหรับ ansatz real_amplitudes
คาดว่า Optimized Real Amplitudes จะมีประสิทธิภาพ optimization ดีกว่า Real Amplitudes ansatz อย่างไรก็ตาม จำนวนตัวแปรที่ต้อง optimize ใน ansatz นี้เพิ่มขึ้นเร็วกว่า Real Amplitudes มาก (ดูงานวิจัย) ดังนั้นสำหรับปัญหาขนาดใหญ่ Optimized Real Amplitudes ต้องการการรัน Circuit มากขึ้น Optimized Real Amplitudes น่าจะเหมาะกับปัญหาที่ต้องการ Qubit ไม่เกิน 100 ตัว แต่ควรระวังในการตั้งค่าพารามิเตอร์ population_size เพื่อเป็นตัวอย่างของการ scale-up ใน population_size ตารางก่อนหน้าแสดงว่าสำหรับปัญหา 84 Qubit Optimized Real Amplitudes ต้องการ population_size 120 ขณะที่ปัญหา 56 Qubit ใช้ population_size เพียง 40
optimizer_settings = {
    "de_optimizer_settings": {
        "num_generations": 20,
        "population_size": 90,
        "recombination": 0.4,
        "max_parallel_jobs": 5,
        "max_batchsize": 4,
        "mutation_range": [0.0, 0.25],
    },
    "optimizer": "differential_evolution",
    "primitive_settings": {
        "estimator_shots": 25_000,
        "estimator_precision": None,
        "sampler_shots": 100_000,
    },
}
นอกจากนี้ยังสามารถเลือก ansatz เฉพาะได้ ตัวอย่างต่อไปนี้ใช้ ansatz 'Tailored'
ansatz_settings = {
    "ansatz": "tailored",
    "multiple_passmanager": False,
}
4. รันปัญหา
dpo_job = dpo_solver.run(
    assets=assets,
    qubo_settings=qubo_settings,
    optimizer_settings=optimizer_settings,
    ansatz_settings=ansatz_settings,
    backend_name="<backend name>",
    previous_session_id=[],
    apply_postprocess=True,
)
5. ดึงผลลัพธ์
ฟังก์ชันส่งคืน dictionary ที่มี investment trajectories เรียงจากต่ำสุดไปสูงสุดตามค่า objective function (ดูส่วน Output ใน API reference) ผลลัพธ์ชุดนี้ช่วยระบุ trajectory ที่มีต้นทุนต่ำสุดและการประเมินการลงทุนที่สอดคล้องกัน นอกจากนี้ยังเปิดโอกาสให้วิเคราะห์ trajectories ทางเลือกต่าง ๆ ทำให้เลือกได้ว่าแบบไหนตรงกับความต้องการหรือเป้าหมายของตัวเองมากที่สุด ความยืดหยุ่นนี้ทำให้ปรับแต่งการเลือกให้เหมาะกับความชอบหรือสถานการณ์ที่หลากหลาย เริ่มจากการแสดงกลยุทธ์ที่ได้ objective cost ต่ำสุดที่พบในกระบวนการ
# Get the results of the job
dpo_result = dpo_job.result()

# Show the solution strategy
dpo_result["result"]
{'time_step_0': {'8801.T': 0.11764705882352941,
  'ITX.MC': 0.20588235294117646,
  'META': 0.38235294117647056,
  'GBPJPY=X': 0.058823529411764705,
  'TMBMKDE-10Y': 0.0,
  'CLF': 0.058823529411764705,
  'XS2239553048': 0.17647058823529413},
 'time_step_1': {'8801.T': 0.11428571428571428,
  'ITX.MC': 0.14285714285714285,
  'META': 0.2,
  'GBPJPY=X': 0.02857142857142857,
  'TMBMKDE-10Y': 0.42857142857142855,
  'CLF': 0.0,
  'XS2239553048': 0.08571428571428572},
 'time_step_2': {'8801.T': 0.0,
  'ITX.MC': 0.09375,
  'META': 0.3125,
  'GBPJPY=X': 0.34375,
  'TMBMKDE-10Y': 0.0,
  'CLF': 0.0,
  'XS2239553048': 0.25},
 'time_step_3': {'8801.T': 0.3939393939393939,
  'ITX.MC': 0.09090909090909091,
  'META': 0.12121212121212122,
  'GBPJPY=X': 0.18181818181818182,
  'TMBMKDE-10Y': 0.0,
  'CLF': 0.0,
  'XS2239553048': 0.21212121212121213}}
หลังจากนั้น โดยใช้ข้อมูลเมตา คุณสามารถเข้าถึงผลลัพธ์ของกลยุทธ์ที่สุ่มตัวอย่างทั้งหมดได้ คุณจึงสามารถวิเคราะห์เส้นทางทางเลือกที่ส่งกลับโดย optimizer ได้เพิ่มเติม โดยให้อ่าน dictionary ที่เก็บอยู่ใน dpo_result['metadata']['all_samples_metrics'] ซึ่งมีข้อมูลเพิ่มเติมเกี่ยวกับกลยุทธ์ที่ดีที่สุด รวมทั้งรายละเอียดของกลยุทธ์ตัวเลือกอื่น ๆ ที่ถูกประเมินระหว่างการ optimize
ตัวอย่างต่อไปนี้แสดงวิธีการอ่านข้อมูลนี้โดยใช้ pandas เพื่อดึงตัวชี้วัดหลักที่เกี่ยวข้องกับกลยุทธ์ที่ดีที่สุด ซึ่งรวมถึง Restriction Deviation, Sharpe Ratio และผลตอบแทนการลงทุนที่สอดคล้องกัน
# Convert metadata to a DataFrame
df = pd.DataFrame(dpo_result["metadata"]["all_samples_metrics"])

# Find the minimum objective cost
min_cost = df["objective_costs"].min()
print(f"Minimum Objective Cost Found: {min_cost:.2f}")

# Extract the row with the lowest cost
best_row = df[df["objective_costs"] == min_cost].iloc[0]

# Display the results associated with the best solution
print("Best Solution:")
print(f"  - Restriction Deviation: {best_row['rest_breaches']}%")
print(f"  - Sharpe Ratio: {best_row['sharpe_ratios']:.2f}")
print(f"  - Return: {best_row['returns']}")
Minimum Objective Cost Found: -3.78
Best Solution:
  - Restriction Deviation: 40.0
  - Sharpe Ratio: 24.82
  - Return: 0.46
6. การวิเคราะห์ประสิทธิภาพ
สุดท้าย ให้วิเคราะห์ประสิทธิภาพของแอปพลิเคชันการปรับให้เหมาะสมของคุณ โดยเฉพาะ ให้เปรียบเทียบผลลัพธ์ของคุณ ที่ได้จากตัวอย่างก่อนหน้า กับเส้นฐานแบบสุ่มเพื่อประเมินประสิทธิผลของแนวทางของเรา หากอัลกอริทึมควอนตัมให้ผลลัพธ์ที่มีค่าต้นทุนต่ำกว่าอย่างชัดเจนและสม่ำเสมอ นั่นบ่งชี้ว่ากระบวนการปรับให้เหมาะสมมีประสิทธิผล
รูปแสดงการแจกแจงความน่าจะเป็นของค่าต้นทุนวัตถุประสงค์ เพื่อสร้างการแจกแจงเหล่านี้ ให้นำรายการค่าต้นทุนวัตถุประสงค์จากผลลัพธ์ของฟังก์ชันและนับจำนวนครั้งของค่าต้นทุนแต่ละค่า (ค่าปัดเศษเป็นทศนิยมสองตำแหน่ง) จากนั้น อัปเดตคอลัมน์จำนวนนับให้สอดคล้องกัน โดยรวมจำนวนนับของค่าที่ปัดเศษแล้วเท่ากันเข้าด้วยกัน โปรดทราบว่า เพื่อการเปรียบเทียบภาพที่ดีขึ้น การนับจำนวนครั้งที่เกิดขึ้นได้ถูกทำให้เป็นมาตรฐานเพื่อให้การแจกแจงแต่ละรายการแสดงระหว่าง 0 ถึง 1
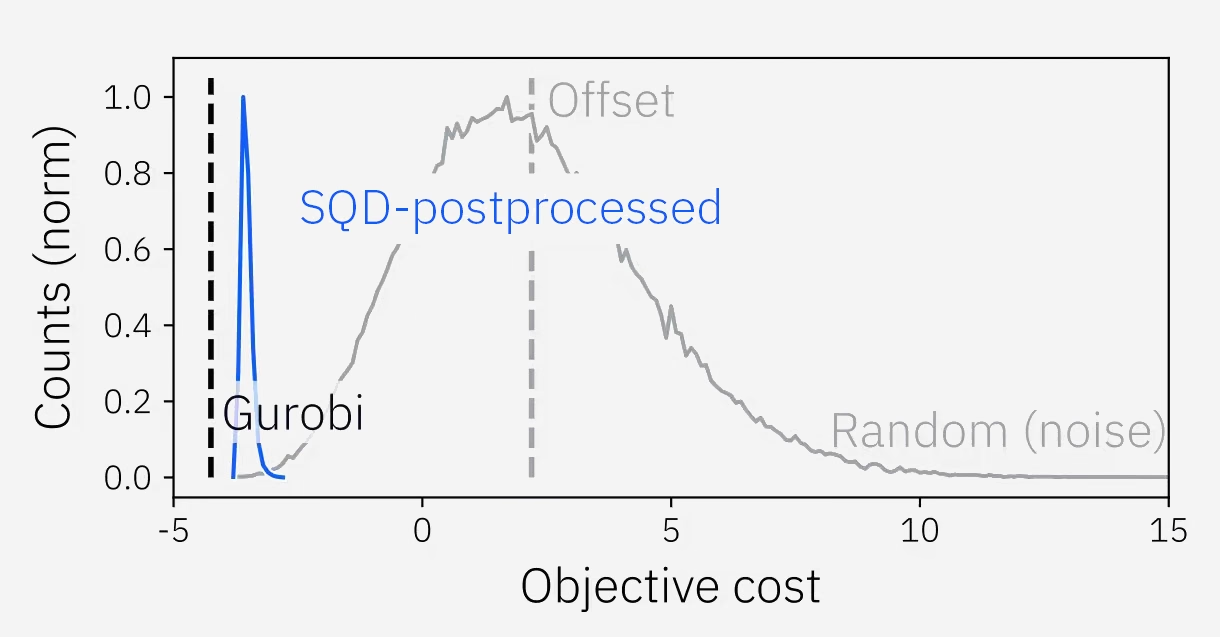 ดังที่เห็นในรูป (เส้นสีน้ำเงิน) cost distribution ของแนวทาง Variational Quantum Eigensolver (ผ่าน postprocess ด้วย SQD) กระจุกตัวอย่างชัดเจนที่ค่า objective cost ต่ำ บ่งชี้ประสิทธิภาพ optimization ที่ดี ในทางตรงกันข้าม noisy baseline มี distribution กว้างกว่า โดยศูนย์กลางอยู่ที่ค่าต้นทุนสูงกว่า เส้นประแนวตั้งสีเทาแสดงค่าเฉลี่ยของ random distribution เน้นย้ำถึงความสม่ำเสมอของฟังก์ชันในการส่งคืนกลยุทธ์การลงทุนที่ผ่าน optimization แล้ว สำหรับการเปรียบเทียบเพิ่มเติม เส้นประสีดำในรูปแสดงผลลัพธ์ที่ได้จาก Gurobi optimizer (เวอร์ชันฟรี) ผลลัพธ์ทั้งหมดนี้ถูกสำรวจเพิ่มเติมใน benchmarks ด้านล่างสำหรับตัวอย่าง "Mixed Assets" ที่ประเมินด้วย ansatz "Tailored"
Benchmarks
ฟังก์ชันนี้ถูกทดสอบภายใต้การตั้งค่าต่าง ๆ ของ resolution qubits, ansatz circuits และกลุ่มสินทรัพย์จากหลายภาคส่วน ได้แก่ สินทรัพย์ผสม (Set 1) อนุพันธ์น้ำมัน (Set 2) และ IBEX35 (Set 3) ดูรายละเอียดเพิ่มเติมในตารางต่อไปนี้
| Set | วันที่ | สินทรัพย์ |
|---|---|---|
| Set 1 | 01/01/2023 | 8801.T, CL=F, GBPJPY=X, ITX.MC, META, TMBMKDE-10Y, XS2239553048 |
| Set 2 | 01/06/2023 | CL=F, BZ=F, HO=F, NG=F, XOM, RB=F, 2222.SR |
| Set 3 | 01/11/2022 | ACS.MC, ITX.MC, FER.MC, ELE.MC, SCYR.MC, AENA.MC, AMS.MC |
มีการใช้ metrics หลักสองตัวเพื่อประเมินคุณภาพของ solution
- Objective cost ซึ่งวัดประสิทธิภาพของ optimization โดยเปรียบเทียบค่า cost function จากแต่ละการทดลองกับผลลัพธ์จาก Gurobi (เวอร์ชันฟรี)
- Sharpe ratio ซึ่งสะท้อนผลตอบแทนที่ปรับตามความเสี่ยงของแต่ละพอร์ตโฟลิโอ ให้ข้อมูลเชิงลึกเกี่ยวกับประสิทธิภาพทางการเงินของ solution
เมตริกเหล่านี้เมื่อรวมกันจะวัดผลทั้งด้านการคำนวณและด้านการเงินของพอร์ตโฟลิโอที่สร้างขึ้นด้วยควอนตัม
| ตัวอย่าง | Qubit | Ansatz | ความลึก | การใช้งาน Runtime (วินาที) | การใช้งานทั้งหมด (วินาที) | Objective cost | Sharpe | Gurobi objective cost | Gurobi Sharpe |
|---|---|---|---|---|---|---|---|---|---|
| Mixed Assets (Set 1, 4 time steps, 4-bit) | 112 | Tailored | 83 | 12735 | 13095 | -3.78 | 24.82 | -4.25 | 24.71 |
| Mixed Assets (Set 1,4 time steps, 4 time steps, 4-bit) | 112 | Real Amplitudes | 359 | 11739 | 11903 | -3.39 | 23.64 | -4.25 | 24.71 |
| Oil Derivatives (Set 2, 4 time steps, 3-bit) | 84 | Optimized Real Amplitudes | 78 | 6180 | 6350 | -3.73 | 19.13 | -4.19 | 21.71 |
| IBEX35 (Set 3, 4 time steps, 2-bit) | 56 | Optimized Real Amplitudes | 96 | 3314 | 3523 | -3.67 | 14.48 | -4.11 | 16.44 |
ผลลัพธ์แสดงให้เห็นว่า quantum optimizer ที่ใช้ ansatz เฉพาะสำหรับแต่ละปัญหา สามารถระบุกลยุทธ์การลงทุนที่มีประสิทธิภาพได้ในพอร์ตโฟลิโอหลากหลายประเภท
ด้านล่างนี้ระบุรายละเอียดทั้ง population size และจำนวน generations ที่กำหนดใน dictionary optimizer_options พารามิเตอร์อื่น ๆ ทั้งหมดถูกตั้งเป็นค่า default
| ตัวอย่าง | population_size | num_generations |
|---|---|---|
| Mixed Assets Portfolio | 90 | 20 |
| Mixed Assets Portfolio | 92 | 20 |
| Oil Derivatives Portfolio | 120 | 20 |
| IBEX35 Portfolio | 40 | 20 |
จำนวน generations ถูกกำหนดเป็น 20 เนื่องจากพบว่าค่านี้เพียงพอสำหรับการ converge นอกจากนี้ ค่า default ของพารามิเตอร์ภายในของ optimizer ถูกปล่อยไว้ไม่เปลี่ยนแปลง เพราะให้ประสิทธิภาพที่ดีอย่างสม่ำเสมอและแนะนำโดยทั่วไปในเอกสารและแนวทางการ implementation
รับการสนับสนุน
ถ้าต้องการความช่วยเหลือ ส่งอีเมลไปที่ qpo.support@globaldataquantum.com พร้อมระบุ function job ID ในข้อความ
ขั้นตอนถัดไป
- อ่าน งานวิจัยที่เกี่ยวข้อง
-
- เยี่ยมชม เอกสารอ้างอิง API สำหรับ Qiskit Function นี้
- ขอสิทธิ์เข้าถึง function โดยกรอก แบบฟอร์มนี้
- ลองใช้ tutorial Dynamic Portfolio Optimization