Parity Twine Optimizer: ฟังก์ชัน Qiskit โดย ParityQC
Qiskit Functions เป็นฟีเจอร์ทดลองที่ใช้ได้เฉพาะผู้ใช้แผน IBM Quantum® Premium Plan, Flex Plan และ On-Prem (ผ่าน IBM Quantum Platform API) เท่านั้น ฟีเจอร์นี้อยู่ในสถานะ preview release และอาจมีการเปลี่ยนแปลงได้
ภาพรวม
Parity Twine Optimizer ช่วยให้ผู้ใช้สามารถแก้ปัญหาการหาค่าเหมาะที่สุดด้วยคอมพิวเตอร์ควอนตัมโดยใช้วิธี Parity Twine แนวทางนี้สร้างขึ้นบน Parity Architecture โดยใช้คอมไพเลอร์ ParityQC เพื่อลดจำนวนเกตและความลึกของวงจรที่จำเป็นในการรันอัลกอริทึมควอนตัม พร้อมทั้งคำนึงถึงการเชื่อมต่อของอุปกรณ์
การลดทรัพยากรนี้ช่วยให้สามารถแก้ปัญหาการหาค่าเหมาะที่สุดที่เกี่ยวข้องกับอุตสาหกรรมในขนาดที่ไม่สามารถทำได้ด้วยวิธีการแปลง (transpilation) แบบมาตรฐานที่ใช้ SWAP จำนวนมาก Parity Twine Optimizer ทำให้ขั้นตอนการแปลงเป็นอัตโนมัติและสามารถใช้งานได้โดยผู้ใช้ป้อนข้อมูลน้อยที่สุด
แนวทาง Parity Twine มีประสิทธิภาพเหนือกว่าวิธีการคอมไพล์อื่น ๆ ทั้งหมดในแง่ของการลดจำนวนเกตและความลึกของวงจรสำหรับอัลกอริทึมควอนตัม เช่น quantum approximate optimization algorithm (QAOA) และ quantum Fourier transform (QFT) ด้วยการแยกข้อมูลควอนตัมออกจากคิวบิตทางกายภาพ จึงสร้างอันตรกิริยาแบบไม่เฉพาะที่ (non-local) ได้โดยไม่ต้องใช้เกต SWAP แต่ Parity Twine chains (ลำดับของเกต CNOT) จะกระจายข้อมูล parity เชิงตรรกะระหว่างคิวบิตอย่างเป็นระบบแทน
ตัวหาค่าเหมาะที่สุด (optimizer) ใช้ QAOA เพื่อลดพลังงานของฟังก์ชันต้นทุนที่กำหนด QAOA เป็นอัลกอริทึมแบบ hybrid quantum-classical variational ที่ออกแบบมาเพื่อแก้ปัญหาการหาค่าเหมาะที่สุดเชิงการจัดหมู่ (combinatorial optimization) โดยการประมาณสถานะพื้น (ground state) ของ cost Hamiltonian () เทอมการผสม (mixing term) () ผลักดันการเปลี่ยนสถานะเพื่อสำรวจพื้นที่คำตอบ ลำดับสลับกันของเทอมเหล่านี้ ซึ่งควบคุมโดยพารามิเตอร์ และ กำหนดยูนิทารี ซึ่งกระทำกับสถานะเริ่มต้น
การเข้ารหัสยูนิทารีของปัญหา exp() ต้องการการเข้ารหัสตัวดำเนินการหมุน (rotation operators) เชิงตรรกะแบบ -body ทั้งหมด (exp()) สิ่งนี้สามารถทำได้โดยใช้ตัวสร้างแบบ -body (Parity Twine Networks) ซึ่งช่วยลดความลึกของวงจร QAOA และจำนวนเกตสองคิวบิต
คำอธิบาย
อินพุตของ Parity Twine Optimizer ประกอบด้วยปัญหาการหาค่าเหมาะที่สุด ชื่อฮาร์ดแวร์ IBM Quantum ที่เลือก และอาร์กิวเมนต์เสริมเพิ่มเติมเพื่อปรับแต่งการตั้งค่าการแปลงและการรันบนฮาร์ดแวร์ ฟังก์ชัน optimizer จะส่งนิยามของปัญหาไปยัง Parity Twine Compiler รูปที่ 1 แสดงสรุปขั้นตอนการทำงานของฟังก์ชัน
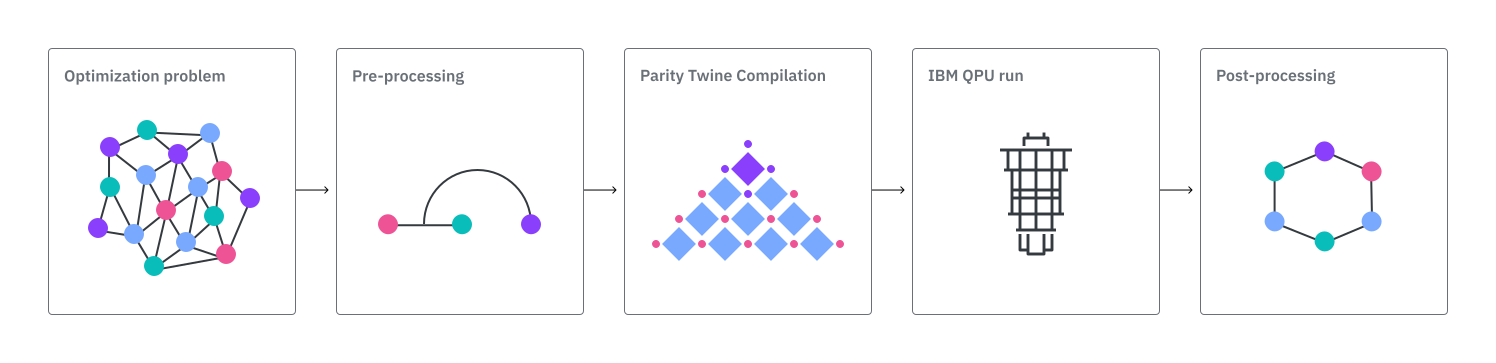
ปัญหาการหาค่าเหมาะที่สุดที่ป้อนเข้ามาจะถูกประมวลผลล่วงหน้าให้เป็น Hamiltonian (ที่ทำให้เป็นมาตรฐาน) จากนั้นคอมไพเลอร์ ParityQC จะสร้างวงจร ansatz แบบ Parity Twine ที่มีพารามิเตอร์ ซึ่งจะถูกแปลงเป็น ansatz เชิงตรรกะที่ตรงกับชุดเกต ดั้งเดิมของฮาร์ดแวร์ที่เลือก
พารามิเตอร์ของวงจร QAOA จะถูกปรับให้เหมาะสมด้วยวิธีคลาสสิกโดยใช้แนวทาง "efficient depth one" และกำหนดค่าให้กับวงจรที่แปลงแล้ว เนื่องจากใช้ QAOA เพียงหนึ่งรอบ พารามิเตอร์ และ ที่เหมาะที่สุดจะได้มาจากการค้นหาแบบกริด (grid search) บน CPU โดยไม่ต้องปรับค่าแบบวนซ้ำซึ่งต้องเรียกรันวงจรหลายครั้งและสิ้นเปลืองสูง วิธีนี้ช่วยลดเวลารัน QPU ที่จำเป็นของ optimizer ได้อย่างมาก เวลาในการรันต่อวงจรส่วนใหญ่ถูกกำหนดโดยค่าใช้จ่ายคงที่ในการรันงานบน QPU เมื่อกำหนดพารามิเตอร์ของวงจรแล้ว งานจะถูกส่งไปยัง QPU ของ IBM® ที่ระบุ
จากนั้นผลลัพธ์ดิบจะถูกประมวลผลภายหลัง ขั้นตอนนี้ใช้การค้นหาแบบ greedy เฉพาะที่ (local greedy search) ที่วนซ้ำแบบสุ่มผ่านสตริงคำตอบและสลับค่าบิตหากทำให้ค่าฟังก์ชันต้นทุนลดลง
การเปรียบเทียบประสิทธิภาพ
ประสิทธิภาพอาจขึ้นอยู่กับทั้งอินสแตนซ์ของปัญหาและขั้นตอนการประมวลผลที่ตามมา ในบางกรณี ตัวอย่างแบบคลาสสิกและตัวอย่างที่สร้างด้วยควอนตัมอาจให้คุณภาพของคำตอบสุดท้ายที่ใกล้เคียงกันหลังจากการประมวลผลภายหลังที่เทียบเท่ากัน ดังนั้นการประเมินควรพิจารณากระบวนการหาค่าเหมาะที่สุดทั้งหมด
โมเดล Sherrington-Kirkpatrick
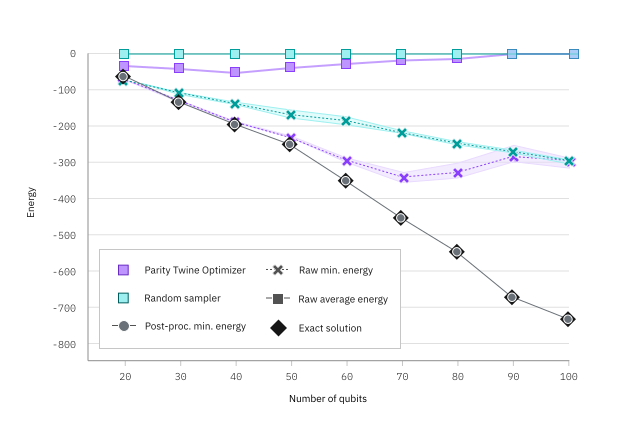
รูปที่ 2 แสดงให้เห็นถึงประสิทธิภาพของ Parity Twine Optimizer โดยเปรียบเทียบผลลัพธ์ที่ได้จาก optimizer กับการสุ่มตัวอย่างสำหรับโมเดล Sherrington-Kirkpatrick เมื่อจำนวนคิวบิตเพิ่มขึ้น
การประมวลผลภายหลังของทั้งผลลัพธ์แบบสุ่มและผลลัพธ์จาก optimizer นำไปสู่สถานะพื้นที่แม่นตรง (exact ground state) แต่ผลลัพธ์พลังงานต่ำสุดดิบจาก Twine QAOA ดีกว่าค่าสุ่มเสมอ สำหรับจำนวนคิวบิตที่มากที่สุดที่พิจารณา (90 และ 100) สัญญาณรบกวนของฮาร์ดแวร์ทำให้ผลลัพธ์ของ optimizer แย่ลงจนกลับไปเป็นค่าดิบที่ตรงกับการสุ่มตัวอย่าง
ดูบทแนะนำนี้เพื่อเป็นการแนะนำโมเดล Sherrington-Kirkpatrick และรายละเอียดวิธีการแก้ปัญหาด้วย Parity Twine Optimizer
ปัญหา Market Split
ตาราง 1 แสดงตัวชี้วัดประสิทธิภาพเฉพาะสำหรับ Parity Twine Optimizer ที่นำไปใช้กับอินสแตนซ์ต่าง ๆ ของปัญหา Market Split (MS) สิ่งเหล่านี้ได้มาจาก QOBLIB - Quantum Optimization Benchmarking Library และสอดคล้องกับ การส่ง ที่ทำขึ้นสำหรับ ไลบรารีโดยใช้ Parity Twine Optimizer
MS violation เป็นตัวชี้วัดความแม่นยำที่วัดว่าคำตอบนั้นห่างจากการเป็นไปตามข้อจำกัดทั้งหมดมากเพียงใด ซึ่งนิยามเป็น ค่าที่ต่ำกว่าของตัวชี้วัดนี้บ่งชี้ว่าคำตอบแม่นยำกว่า
ตาราง 1 รายงานค่าเฉลี่ยจากการรันห้าครั้งของแต่ละอินสแตนซ์โดยใช้ Parity Twine Optimizer กับอุปกรณ์ ibm_boston เป็น backend และ 100,000 shots
ตารางรายงานค่า MS violation ต่ำสุดที่ได้จากการรันของแต่ละอินสแตนซ์
| อินสแตนซ์ | คิวบิต | เกตสองคิวบิต | ความลึกสองคิวบิต | MS violation | เวลาแมป (s) | เวลารัน QPU (s) | เวลาประมวลผลภายหลัง (s) |
|---|---|---|---|---|---|---|---|
| ms_03_050_002 | 20 | 399 | 76 | 0 | 45 | 29 | 71 |
| ms_03_100_022 | 20 | 399 | 76 | 0 | 30 | 29 | 77 |
| ms_03_200_177 | 20 | 399 | 76 | 0 | 33 | 29 | 63 |
| ms_04_050_001 | 30 | 899 | 116 | 1 | 68 | 29 | 216 |
| ms_04_100_003 | 30 | 899 | 116 | 2 | 89 | 29 | 187 |
| ms_04_200_030 | 30 | 899 | 116 | 3 | 89 | 29 | 219 |
| ms_05_100_003 | 40 | 1599 | 156 | 3 | 237 | 30 | 364 |
| ms_06_050_001 | 50 | 2499 | 196 | 4 | 499 | 30 | 464 |
| ms_07_050_001 | 60 | 3599 | 236 | 17 | 858 | 31 | 637 |
| ms_08_050_001 | 70 | 4899 | 276 | 36 | 1561 | 31 | 773 |
ตาราง 1: ตัวชี้วัดประสิทธิภาพสำหรับอินสแตนซ์ต่าง ๆ ของปัญหา market split ชื่ออินสแตนซ์เป็นไปตามตัวอย่างที่สอดคล้องกันในไลบรารีปัญหา QOBLIB ดังที่กล่าวไว้ก่อนหน้านี้ในส่วนคำอธิบาย เวลา QPU มีค่าน้อยมากและเกือบคงที่ เนื่องจากใช้ QAOA เพียงหนึ่งรอบโดยมีพารามิเตอร์วงจรที่เหมาะที่สุดซึ่งได้จาก CPU
ดูบทแนะนำนี้เพื่อเป็นการแนะนำปัญหา Market Split และรายละเอียดวิธีการแก้ปัญหาด้วย Parity Twine Optimizer
ปัญหา Maximum Independent Set
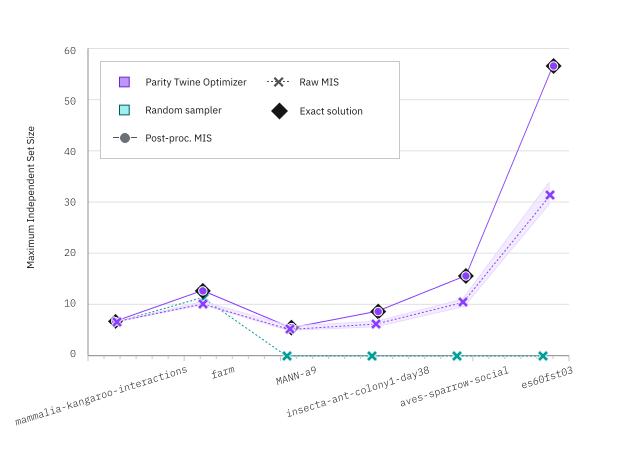
รูปที่ 3 เปรียบเทียบผลลัพธ์ที่ได้จาก Parity Twine Optimizer กับการสุ่มตัวอย่างสำหรับปัญหา maximum independent set สำหรับอินสแตนซ์ที่เลือก ซึ่งได้จาก QOBLIB - Quantum Optimization Benchmarking Library ซึ่งมีขนาดตั้งแต่ 18 (mammalia-kangaroo-interactions) ถึง 114 (es60fst03) คิวบิต
สำหรับอินสแตนซ์ขนาดเล็ก ขนาด Maximum Independent Set ดิบที่ได้จาก optimizer และการสุ่มตัวอย่างมีความคล้ายคลึงกัน แต่สำหรับอินสแตนซ์ขนาดใหญ่ optimizer ให้ผลลัพธ์ที่ดีกว่ามาก การประมวลผลภายหลังของทั้งผลลัพธ์แบบสุ่มตัวอย่างและผลลัพธ์จาก optimizer นำไปสู่ขนาดเซตที่สอดคล้องกับค่าที่แน่นอนอีกครั้ง
เริ่มต้นใช้งาน
ยืนยันตัวตนโดยใช้โทเคน API ของ IBM Quantum Platform ของคุณ และเลือกฟังก์ชัน Qiskit ดังนี้:
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

# Authenticate and load the Qiskit Function
catalog = QiskitFunctionsCatalog(
    channel="ibm_quantum_platform",
)
function = catalog.load("parityqc/parity-twine-optimizer")
ตัวอย่าง
Parity Twine Optimizer สามารถนำไปใช้กับตัวอย่าง QUBO อย่างง่ายได้ดังนี้ ปัญหานี้ถูกกำหนดขึ้นก่อนโดยใช้ dictionary:
problem = {"()": 3, "(0,)": 1, "(0, 1)": 2, "(1, 2)": -1}
จากนั้น ต้องกำหนดประเภทตัวแปรเป็น binary หรือ spin:
variable_type = "spin"
สิ่งนี้กำหนดฟังก์ชันวัตถุประสงค์ โดยที่
เลือก backend ตัวอย่างเช่น:
backend_name = "ibm_phoenix"
ใช้ catalog.backends() เพื่อดูรายการ backend ที่ใช้ได้จากบัญชี/อินสแตนซ์ของผู้ใช้
หากไม่ได้ระบุ backend ระบบจะเลือก backend ที่ไม่ยุ่ง (least-busy) ที่สุดโดยอัตโนมัติ (backend ที่มีจำนวนงานที่รอดำเนินการน้อยที่สุด)
เมื่อโหลด optimizer แล้ว (ดูก่อนหน้านี้) คุณสามารถรันบนปัญหาได้โดยใช้ตัวเลือกค่าเริ่มต้น:
function_job = function.run(
    problem=problem, variable_type=variable_type, backend_name=backend_name
)
print(f"Job ID: {function_job.job_id}")
ตรวจสอบสถานะงานได้ดังนี้:
# Monitor the job status
function_job.status()
ดึงผลลัพธ์ได้ดังนี้:
# Retrieve the job result if the status is DONE
result = function_job.result()

result
การพิมพ์ผลลัพธ์จะให้ผลดังนี้:
{
    'solution': {'0': -1, '1': 1, '2': 1},
    'objective_value': -1.0,
    'solution_bitstring': '100',
    'metadata': {
        'circuit_metrics': {
            'depth': 20,
            'gate_count': 198,
            'two_qubit_gate_depth': 4,
            'two_qubit_gate_count': 4,
            'num_qubits': 3,
            'operations': {'delay': 158, 'rz': 17, 'sx': 14, 'cz': 4, 'measure': 3, 'x': 2}
        },
        'solver_info': {
            'variable_mapping': {'0': 0, '1': 1, '2': 2},
            'bitstring_distributions': {
                'before_postprocessing': {'100': 71760, ... },
                'after_postprocessing': {'100': 88440, '011': 11560}
            },
            'best_parameters': {
                'beta': [-0.46259546391008877],
                'gamma': [0.6181957189727373]
            }
        },
        'resource_usage': {
            'RUNNING: MAPPING': {'CPU_TIME': 42.878},
            'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 0.094},
            'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 790.623},
            'RUNNING: EXECUTING_QPU': {'QPU_TIME': 28.0},
            'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.828}
        }
    }
}
dictionary solution สอดคล้องกับคิวบิตที่กำหนดไว้ในปัญหา ( และ ) และให้ค่าสปินที่ปรับให้เหมาะที่สุดของคิวบิตเหล่านั้น
objective_value คือค่าต้นทุนหรือพลังงานของปัญหาการหาค่าเหมาะที่สุด ซึ่งเป็นตัวชี้วัดคุณภาพของ solution
metadata ให้ข้อมูลเกี่ยวกับการแปลง (จำนวน/ความลึกของเกตสองคิวบิต เกตที่ใช้ คิวบิตที่ใช้งาน) และเวลารันต่าง ๆ ทั้งสำหรับเวลาคำนวณเชิงควอนตัมและเชิงคลาสสิก
นอกจากนี้ metadata ยังช่วยให้เห็นการทำงานภายในของอัลกอริทึมได้บ้าง คุณสามารถดูพารามิเตอร์ variational ที่ปรับให้เหมาะที่สุด (beta และ gamma) และตรวจสอบว่าการแจกแจงของบิตสตริงที่วัดได้ดีขึ้นอย่างไรหลังจากใช้การประมวลผลภายหลังแบบคลาสสิกกับผลลัพธ์ควอนตัมดิบ
บิตสตริงทั้งหมดในผลลัพธ์สามารถแมปไปยังตัวแปรของปัญหาได้โดยใช้ variable_mapping
ตัวอย่างเช่น คุณสามารถแมป 'solution_bitstring': '100' กับ 'variable_mapping': {'0': 0, '1': 1, '2': 2} ไปยังคำตอบแบบไบนารี: {'0': 1, '1': 0, '2': 0}
เนื่องจากคุณกำลังแก้ปัญหาในรูปของตัวแปรสปิน คุณต้องใช้การแปลงจากไบนารีเป็นสปิน (0 -> 1, 1 -> -1)
จากนั้นคุณจะได้คำตอบสุดท้าย 'solution': {'0': -1, '1': 1, '2': 1}
ดูเอกสารอ้างอิง API สำหรับรายละเอียดฉบับเต็มของอินพุตและเอาต์พุตของฟังก์ชัน Parity Twine Optimizer
บันทึกการเปลี่ยนแปลง
[1.0.2] - 2026-09-15
Notes
รุ่นนี้เป็นเวอร์ชันโปรดักชันที่เสถียรรุ่นแรกของฟังก์ชัน Qiskit ของ Parity Twine Optimizer รุ่นในอนาคตคาดว่าจะนำเสนอสิ่งต่อไปนี้:
- การคอมไพล์ปัญหาลำดับสูงกว่า
- อัลกอริทึมการหาค่าเหมาะที่สุดเพิ่มเติม และ
- การปรับปรุงในการประมวลผลก่อนและหลัง
คุณสมบัติ
- แก้ปัญหา QUBO แบบ sparse และ dense ด้วย Parity Twine Compiler ที่มีประสิทธิภาพ
เอกสารประกอบ
- คู่มือผู้ใช้เริ่มต้นใช้งาน
- บทแนะนำพร้อมตัวอย่างสำหรับปัญหา Market Split และ Sherrington-Kirkpatrick
- เอกสาร API
รับการสนับสนุน
ติดต่อ ParityQC หากมีคำถามหรือปัญหาใดๆ
ขั้นตอนถัดไป
- ขอสิทธิ์เข้าถึงฟังก์ชันนี้โดยกรอกแบบฟอร์มนี้
- เยี่ยมชมเอกสารอ้างอิง API สำหรับ Qiskit Function นี้
- ลองบทแนะนำ สำหรับการประยุกต์ใช้ Parity Twine Optimizer กับปัญหา Market Split
- ลองบทแนะนำ สำหรับการประยุกต์ใช้ Parity Twine Optimizer กับโมเดล Sherrington-Kirkpatrick
- อ่านพรีปรินต์ ArXiv เรื่อง Connectivity-aware Synthesis of Quantum Algorithms, Drier et al. (2025)