Rimay Quantum Feature Extraction - Qiskit Function โดย Kipu Quantum
Qiskit Functions เป็นฟีเจอร์เชิงทดลองที่ใช้ได้เฉพาะผู้ใช้ IBM Quantum® Premium Plan, Flex Plan และ On-Prem (ผ่าน IBM Quantum Platform API) Plan เท่านั้น ฟีเจอร์นี้อยู่ในสถานะ preview release และอาจมีการเปลี่ยนแปลง
ภาพรวม
Rimay เสริม pipeline machine learning แบบคลาสสิกด้วยฟีเจอร์ที่สร้างบนฮาร์ดแวร์ควอนตัม function รับข้อมูลตารางแบบคลาสสิกและคืนชุดฟีเจอร์ที่แปลงด้วยควอนตัม เมื่อระบบควอนตัมประมวลผลข้อมูล จะสร้างฟีเจอร์ที่สมบูรณ์ซึ่งจับความสัมพันธ์แบบไม่เชิงเส้นระหว่าง input ได้ คุณใช้ฟีเจอร์ที่สร้างขึ้นเดี่ยว ๆ หรือรวมกับฟีเจอร์เดิมของคุณเพื่อฝึกโมเดลคลาสสิกใดก็ได้ บนชุดข้อมูลขนาดเล็กถึงกลาง ฟีเจอร์ที่แปลงด้วยควอนตัมสามารถช่วยให้คุณภาพการทำนายดีขึ้นเมื่อเทียบกับ baseline แบบคลาสสิกล้วน
function นี้สร้างมาสำหรับผู้ใช้ต่อไปนี้:
-
ทีม data science ที่มี pipeline machine learning อยู่แล้วบนชุดข้อมูลตารางขนาดเล็กถึงกลาง ซึ่งคุณภาพการทำนายหยุดนิ่ง คุณเพิ่ม Rimay เป็นขั้นตอนประมวลผลก่อนเพิ่มเติมหนึ่งขั้น โดยไม่ต้องสร้าง quantum circuit เอง
-
นักวิจัยที่สำรวจวิธีควอนตัมสำหรับงาน machine learning
คำอธิบาย
อัลกอริทึมการสกัดฟีเจอร์เชิงควอนตัม [1] รวมหลักการสองอย่างของ quantum machine learning เข้าด้วยกัน อย่างแรกคือ quantum feature maps ซึ่งฝังข้อมูลลงในปริภูมิฮิลเบิร์ตมิติสูง จึงได้การแทนข้อมูลที่แสดงออกได้มากขึ้น อย่างที่สองคือ quantum reservoir computing ซึ่งใช้พลวัตของระบบควอนตัมหลายส่วนเป็นการแปลงแบบไม่เชิงเส้นของอินพุต
Rimay เข้ารหัสค่าฟีเจอร์และข้อมูลร่วมกัน (mutual information) ระหว่างฟีเจอร์ลงในสนามเฉพาะที่และสัมประสิทธิ์การคับเปิลของแฮมิลโทเนียนแบบสปินกลาส พลวัตควอนตัมแบบ counterdiabatic จะพัฒนาระบบไปสู่สถานะพลังงานต่ำ ซึ่งมีส่วนผสมแบบไม่เชิงเส้นของสหสัมพันธ์ในข้อมูลอินพุต Rimay สกัดสหสัมพันธ์เหล่านี้ด้วยการวัดค่าคาดหวังของหนึ่งส่วนและสองส่วน ค่าคาดหวังเหล่านี้คือฟีเจอร์ที่ผ่านการแปลงเชิงควอนตัมซึ่งคุณป้อนเข้าโมเดล machine learning ของคุณ
เวิร์กโฟลว์
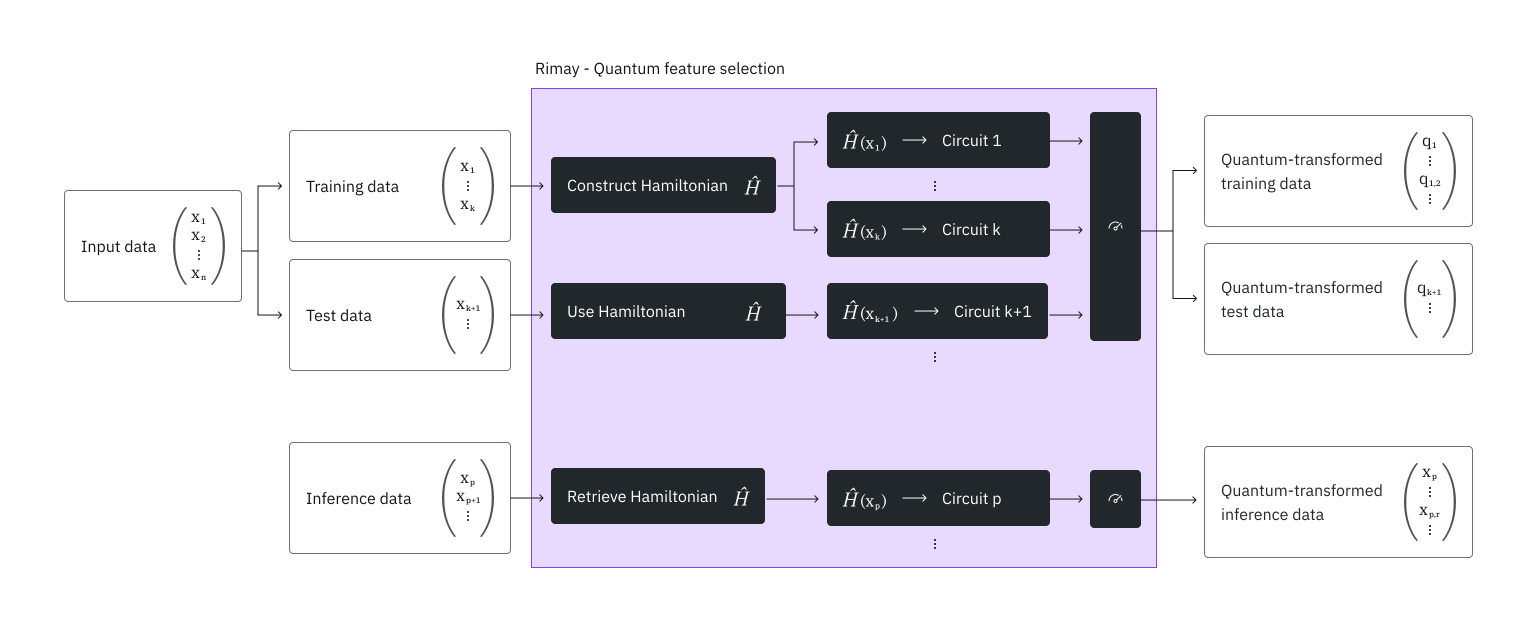
-
ประมวลผลข้อมูลตารางล่วงหน้าเหมือนที่ทำกับ machine learning แบบคลาสสิก Rimay ต้องใช้ฟีเจอร์ที่เป็นตัวเลข ดังนั้นให้แปลงฟีเจอร์เชิงหมวดหมู่เป็นตัวเลข เช่น ใช้
OneHotEncoderของ scikit-learn -
แบ่งข้อมูลเป็นชุดฝึกและชุดทดสอบ แล้วอัปโหลดทั้งสองชุดไปยังฟังก์ชัน ตามที่แสดงในส่วน ตัวอย่าง
-
Rimay ใช้ข้อมูลฝึกสร้างแฮมิลโทเนียนที่แทนข้อมูล ฟีเจอร์แต่ละตัวสอดคล้องกับหนึ่ง qubit และชุดฝึกทั้งหมดเป็นตัวกำหนดว่าฟีเจอร์ใด และ qubit ใด จะมีปฏิสัมพันธ์กัน Rimay เก็บโครงสร้างนี้ไว้เพื่อแมปข้อมูลทดสอบและข้อมูลสำหรับ inference ภายหลังด้วยแฮมิลโทเนียนเดียวกัน
-
สำหรับแต่ละตัวอย่าง ค่าฟีเจอร์จะกำหนดสนามเฉพาะที่ของแฮมิลโทเนียน และข้อมูลร่วมระหว่างฟีเจอร์จะกำหนดสัมประสิทธิ์การคับเปิลของโครงสร้างจากขั้นตอนที่ 3 Rimay แปลงวิวัฒนาการแบบ counterdiabatic ของแฮมิลโทเนียนนี้เป็นดิจิทัลในรูปแบบ circuit แล้วรัน circuit เหล่านั้นบน QPU
-
Rimay วัดบิตสตริงที่ได้ แล้วคำนวณค่าคาดหวังหนึ่งส่วนและค่าคาดหวังสองส่วนของ qubit ที่คับเปิลกันทางกายภาพ
-
คุณดาวน์โหลดค่าคาดหวังในรูปแบบที่ป้อนเข้าโมเดลได้โดยตรง หรือนำไปรวมกับฟีเจอร์เดิมของคุณ
เนื่องจากโครงสร้างนี้ จำนวน qubit ที่การรันต้องใช้จึงเท่ากับจำนวนฟีเจอร์ และจำนวน circuit ที่ส่งเท่ากับจำนวนตัวอย่าง
หลังจากฟิตการแมปแล้ว คุณสามารถแมปข้อมูลใหม่ผ่านการแมปนั้นได้ เช่น สำหรับ inference จากนั้น Rimay จะดึงแฮมิลโทเนียนที่สร้างไว้ระหว่างการฟิต แล้วสร้าง circuit สำหรับตัวอย่างใหม่จากมัน
นำ Rimay ไปใช้ใน machine learning pipeline ของคุณ
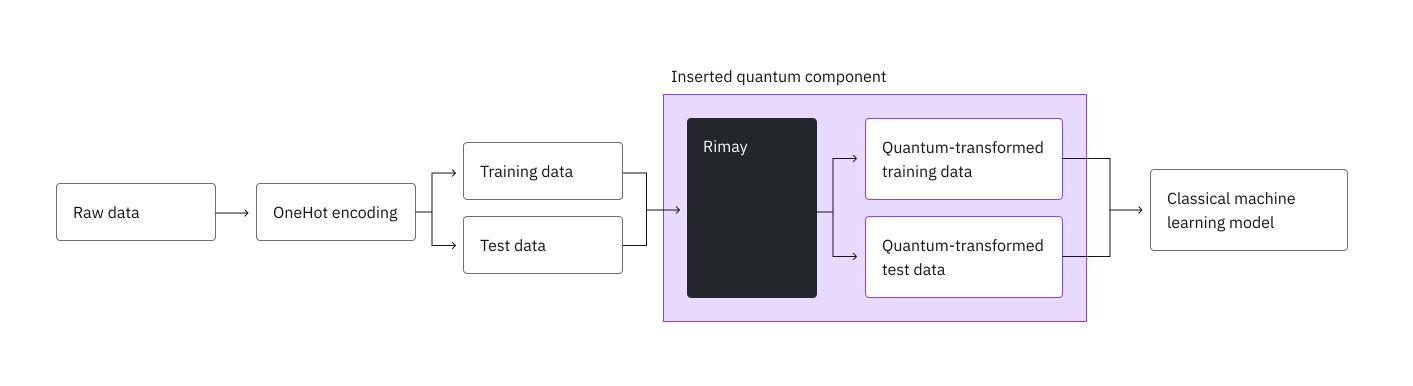
เช่นเดียวกับ pipeline แบบคลาสสิก คุณเริ่มจากประมวลผลข้อมูลดิบล่วงหน้า เช่น ทำ one-hot encoding ให้ฟีเจอร์เชิงหมวดหมู่ แล้วแบ่งเป็นชุดฝึกและชุดทดสอบ แทนที่จะป้อนทั้งสองชุดเข้าโมเดลโดยตรง ให้ป้อนเข้า Rimay ก่อน แล้วฝึกโมเดลของคุณด้วยฟีเจอร์ที่ผ่านการแปลงเชิงควอนตัม
เบนช์มาร์ก
Kipu Quantum ทดสอบ Rimay กับชุดข้อมูล German credit จาก OpenML [2] ซึ่งจัดประเภทผู้ขอสินเชื่อ 1000 ราย เป็นความเสี่ยงด้านเครดิตดีหรือไม่ดี ชุดข้อมูลมีแอตทริบิวต์เชิงหมวดหมู่ 13 รายการและเชิงตัวเลขเจ็ดรายการ การทำ one-hot encoding กับแอตทริบิวต์เชิงหมวดหมู่ได้ฟีเจอร์ตัวเลข 48 ตัว เบนช์มาร์กกันตัวอย่าง 20% ไว้เป็นชุดทดสอบ
เป็นค่าพื้นฐาน มีการฝึกโมเดลคลาสสิกหลายตัวด้วยฟีเจอร์คลาสสิก สำหรับ Rimay มีการฝึก random forest สองแบบ คือด้วยฟีเจอร์ที่ผ่านการแปลงเชิงควอนตัมเพียงอย่างเดียว (Random forest Q) และด้วยฟีเจอร์ที่ผ่านการแปลงเชิงควอนตัมรวมกับฟีเจอร์คลาสสิก (Random forest H ย่อมาจาก hybrid) ตารางแสดงเฉพาะ random forest เพราะทำงานได้ดีที่สุดกับฟีเจอร์ที่ผ่านการแปลงเชิงควอนตัม
| Model | Features | Accuracy | AUC | F1 score | Precision | Recall |
|---|---|---|---|---|---|---|
| CatBoost | Classical | 0.775 | 0.781 | 0.850 | 0.795 | 0.914 |
| Random forest | Classical | 0.765 | 0.781 | 0.846 | 0.782 | 0.921 |
| XGBoost | Classical | 0.760 | 0.758 | 0.835 | 0.803 | 0.871 |
| LightGBM | Classical | 0.770 | 0.751 | 0.840 | 0.818 | 0.864 |
| Random forest Q | Quantum | 0.750 | 0.793 | 0.840 | 0.762 | 0.936 |
| Random forest H | Hybrid | 0.770 | 0.798 | 0.854 | 0.770 | 0.957 |
ฟีเจอร์แบบ hybrid ช่วยปรับปรุงทุกเมตริกของ random forest ยกเว้น precision และ random forest แบบ hybrid ได้ AUC, F1 score และ recall สูงกว่า CatBoost ที่ใช้ฟีเจอร์คลาสสิก ผลที่เด่นที่สุดอยู่ที่ recall ซึ่งเพิ่มจาก 0.921 เป็น 0.957 ฟีเจอร์ที่ผ่านการแปลงเชิงควอนตัมเพียงอย่างเดียวไม่ถึงระดับ precision ของโมเดลคลาสสิก
ชุดทดสอบมีเพียง 200 ตัวอย่าง ดังนั้นการทำนายถูกเพิ่มอีกหนึ่งตัวอย่างจะทำให้ accuracy เปลี่ยนไป 0.005 ให้อ่านความแตกต่างเหล่านี้เป็นแนวโน้มที่ต้องตรวจสอบเพิ่มเติม ไม่ใช่ผลที่มีนัยสำคัญ ความแม่นยำของการทำนายยังอาจขึ้นกับสัญญาณรบกวนจากฮาร์ดแวร์ในฟีเจอร์ที่สกัดได้ ดังนั้นให้ใช้ shot มากพอที่ shot noise จะไม่จำกัดผลลัพธ์
เบนช์มาร์กใช้ทรัพยากรดังต่อไปนี้
| Example | Number of qubits | Number of samples | Number of shots | Total time (min) | QPU usage (min) | Processor |
|---|---|---|---|---|---|---|
| German credit | 48 | 1000 | 5000 | 23 | 22 | ibm_boston |
| German credit | 48 | 1000 | 5000 | 3 | 2 | ibm_phoenix |
จำนวนตัวอย่าง ซึ่งก็คือจำนวน circuit เป็นตัวกำหนดเวลา QPU ให้ใช้โปรเซสเซอร์ประเภท Nighthawk r2 เพราะช่วยลดเวลา QPU ที่ต้องใช้ได้มาก
อินพุต
mode เป็นตัวกำหนดว่าการรันต้องใช้พารามิเตอร์ใดบ้าง สำหรับคำอธิบายของพารามิเตอร์อินพุตทุกตัว ดู API reference
ไฟล์อินพุต
-
อัปโหลดทุกไฟล์ด้วย
catalog.file_upload()ก่อนรันฟังก์ชัน -
การอัปโหลดจะแทนที่ไฟล์ชื่อเดียวกันที่มีอยู่ก่อน แม้จะเป็นของ job ที่คุณส่งไปแล้วแต่ยังไม่เริ่มก็ตาม หากต้องการรันหลาย job พร้อมกัน ให้ตั้งชื่อไฟล์ของแต่ละ job ไม่ซ้ำกัน เช่น
run1_x_train.csvและrun2_x_train.csv -
ทุกไฟล์เป็นไฟล์ CSV ที่มีแถวส่วนหัว แต่ละคอลัมน์ของไฟล์ฟีเจอร์คือฟีเจอร์หนึ่งตัว และทุกค่าต้องเป็นตัวเลข
-
y_trainมีคอลัมน์ตัวเลขเพียงหนึ่งคอลัมน์พอดี โดยมีหนึ่งป้ายกำกับต่อหนึ่งแถวของx_trainให้แมปป้ายกำกับเชิงหมวดหมู่เป็นตัวเลข เช่น good และ bad เป็น 1 และ 0 -
x_testและx_inferenceต้องมีคอลัมน์เหมือนกับx_trainและเรียงลำดับเดียวกัน
mapping_id เป็นทางเดียวที่จะเข้าถึงการแมปที่การฟิตของคุณสร้างขึ้น และไม่สามารถค้นหาหรือกู้คืนได้ มันให้สิทธิ์ในการใช้การแมปนั้น จึงควรปฏิบัติเหมือนข้อมูลรับรอง และอย่าแชร์ หากทำหาย คุณต้องฟิตการแมปใหม่ ซึ่งต้องรันบนฮาร์ดแวร์ควอนตัมอีกครั้ง และควรบันทึก backend_name ของการฟิตไว้ด้วย เพราะการแมปรันได้บนโปรเซสเซอร์นั้นเท่านั้น
ข้อจำกัด
-
ฟีเจอร์แต่ละตัวถูกแมปไปยังหนึ่ง qubit ดังนั้นโปรเซสเซอร์ต้องมี qubit อย่างน้อยเท่ากับจำนวนฟีเจอร์ในข้อมูลของคุณ หากมีฟีเจอร์มากกว่านั้น ให้ลดจำนวนลงด้วยเทคนิคการเลือกฟีเจอร์ก่อน
-
ตัวอย่างแต่ละตัวกลายเป็นหนึ่ง circuit และการรันนับตัวอย่างฝึกและทดสอบรวมกัน การรันหนึ่งครั้งมีตัวอย่างได้สูงสุด 15,000 ตัวอย่าง
-
job เดียวขอรันได้สูงสุด 10 ล้านครั้ง ดังนั้นจำนวนตัวอย่างคูณ
shotsต้องไม่เกิน 10 ล้าน -
job ต้องเสร็จภายใน 24 ชั่วโมง รวมเวลาที่ circuit รอในคิวของโปรเซสเซอร์ด้วย job ที่ใช้เวลานานกว่านั้นจะถูกหยุดโดยไม่มีผลลัพธ์ บนโปรเซสเซอร์ที่คิวยาว ให้เก็บชุดข้อมูลขนาดใหญ่ไว้ต่ำกว่าขีดจำกัดเหล่านี้พอสมควร
เอาต์พุต
job.result() คืนค่าเป็น dictionary ตัวฟีเจอร์ที่ผ่านการแปลงเชิงควอนตัมเองจะถูกเขียนเป็นไฟล์ CSV ที่คุณดาวน์โหลดด้วย catalog.file_download() สำหรับคำอธิบายของทุกคีย์ใน dictionary ดู API reference สำหรับเวลาที่แต่ละเฟสของการรันใช้ ดู เมทาดาทาของการรัน
ไฟล์เอาต์พุตทุกไฟล์มีหนึ่งแถวต่อหนึ่งแถวอินพุต เรียงตามลำดับของไฟล์อินพุต และมีหนึ่งคอลัมน์ต่อฟีเจอร์ที่ผ่านการแปลงเชิงควอนตัมหนึ่งตัว คอลัมน์ที่ชื่อขึ้นต้นด้วย corr_ คือค่าคาดหวังสองส่วน ไฟล์ไม่มีคอลัมน์ป้ายกำกับ ป้ายกำกับของข้อมูลฝึกยังอยู่ในไฟล์ y_train ของคุณ
เมทาดาทาของการรัน
resource_usage มีหนึ่งรายการสำหรับแต่ละเฟสการทำงานที่การรันผ่าน ได้แก่ "RUNNING: MAPPING", "RUNNING: POST_PROCESSING" และบน QPU มักมี "RUNNING: WAITING_FOR_QPU" ด้วย แต่ละรายการมี CPU_TIME ซึ่งเป็นเวลาจริง (wall-clock) ของเฟสเป็นวินาที และ QPU_TIME ซึ่งเป็นเวลา QPU เป็นวินาที บน QPU เวลา QPU ที่ IBM เรียกเก็บจะบันทึกไว้ใต้ "RUNNING: MAPPING" ซึ่งเป็นเฟสที่ circuit รัน
"RUNNING: WAITING_FOR_QPU" คือเวลาที่ job ของคุณรอในคิวของ IBM การรันดึงเวลานี้จาก timestamp ของ job ที่ IBM ให้มา และไม่นับรวมใน "RUNNING: MAPPING" หาก IBM ไม่รายงาน timestamp เหล่านั้นสำหรับทุก job รายการนี้จะไม่มี และเวลารอจะรวมอยู่ใน "RUNNING: MAPPING"
IBM® คำนวณการใช้งานเสร็จหลังจาก job จบไประยะหนึ่ง การรันจะรอได้นานประมาณหนึ่งนาที การใช้งานที่ยังคำนวณอยู่หลังจากเวลานั้นจะไม่รวมใน QPU_TIME และการใช้งานสุดท้ายจะแสดงบน IBM Quantum Platform หากการรันอ่านข้อมูลการใช้งานจาก IBM ไม่ได้ QPU_TIME จะเป็น None
ตัวอย่างเช่น
"metadata": {
    "version": "0.3.0",
    "resource_usage": {
        "RUNNING: MAPPING": {"CPU_TIME": 12.4, "QPU_TIME": 6.0},
        "RUNNING: WAITING_FOR_QPU": {"CPU_TIME": 28.8, "QPU_TIME": 0.0},
        "RUNNING: POST_PROCESSING": {"CPU_TIME": 0.3, "QPU_TIME": 0.0},
    },
}
เริ่มต้นใช้งาน
ยืนยันตัวตนด้วย IBM Quantum Platform API key ของคุณ และเลือก Qiskit Function ดังนี้
โค้ดต่อไปนี้สมมติว่าคุณบันทึกข้อมูลรับรองไว้แล้ว หากยังไม่ได้บันทึก ให้ทำตามขั้นตอนใน ติดตั้งไคลเอนต์ Qiskit Functions Catalog เพื่อบันทึกบัญชีของคุณด้วย API key
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(kipu-quantum/rimay)]
# Access function
rimay = catalog.load("kipu-quantum/rimay")
ขนาดของฟังก์ชัน
ทุก job รันที่ขนาดใดขนาดหนึ่ง ได้แก่ S, M หรือ L หากขนาดที่ระบุเล็กเกินไป job จะถูกปฏิเสธ หากขนาดใหญ่เกินความจำเป็น job จะรันบนโปรไฟล์การประมวลผลที่ใหญ่กว่างานต้องการ
ขนาดของ job Rimay ขึ้นกับจำนวนตัวอย่างที่มันแมป ได้แก่ แถวของ x_train และ x_test สำหรับ fit-transform และแถวของ x_inference สำหรับ transform ป้ายกำกับใน y_train ไม่นับ และการรัน delete ไม่แมปตัวอย่างใดเลย
| Size | Samples per job | Compute profile | vCPU | RAM |
|---|---|---|---|---|
S | Up to 2,999 | 8x32 | 8 | 32 GB |
M | 3,000 to 9,999 | 8x32 | 8 | 32 GB |
L | 10,000 to 15,000 | 16x128 | 16 | 128 GB |
จำนวนตัวอย่างเป็นเกณฑ์เดียว ขนาดไม่เปลี่ยนอะไรนอกจากโปรไฟล์การประมวลผล ข้อจำกัด เรื่องฟีเจอร์ ตัวอย่าง และ shot เหมือนกันทุกขนาด S และ M รันบนโปรไฟล์การประมวลผลเดียวกัน และต่างกันที่จำนวนตัวอย่างที่แต่ละขนาดรองรับ
ค่าเริ่มต้นคือ M ซึ่งใช้เมื่อ job ไม่ได้ขอขนาด ดังนั้น job ที่มีตัวอย่างมากกว่า 9,999 ตัวอย่างต้องขอ L
คุณยังอ่านการแมปจากตัวฟังก์ชันได้ด้วย rimay.sizes_map และอ่านขนาดที่ job รันเมื่อไม่ได้ขอขนาดได้ด้วย rimay.default_size
คำนวณขนาดก่อนส่ง
รันสิ่งนี้กับอินพุตของคุณเอง มันแค่อ่านอินพุตและไม่ทำอย่างอื่น ไม่มีการส่ง job และไม่มีการจองอะไร คุณจึงเรียกใช้กี่ครั้งก็ได้
ส่งชุดข้อมูลเอง ไม่ใช่ชื่อไฟล์ โดยเรียงลำดับเดียวกับ input_file พร้อมกับ mode ของการรัน ขั้นตอนที่ 2 ของตัวอย่าง แสดงการเรียกใช้
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
หากขนาดเล็กเกินไป job จะล้มเหลวด้วยข้อผิดพลาด 4600 และข้อความจะระบุขนาดที่ควรใช้แทน หากขนาดใหญ่เกินความจำเป็น job จะรันตามปกติและบันทึกเหตุการณ์คำแนะนำ 4601
ตัวอย่าง
ตัวอย่างนี้แสดงวิธีอัปโหลดข้อมูล รันฟังก์ชัน และดึงฟีเจอร์ที่ผ่านการแปลงเชิงควอนตัม สำหรับตัวอย่างแบบครบวงจรที่รวมการประมวลผลล่วงหน้าและการฝึกโมเดลคลาสสิก ดูบทแนะนำ
1. อัปโหลดข้อมูล
ตัวอย่างนี้ใช้ชุดข้อมูลสังเคราะห์ขนาดเล็กที่มีฟีเจอร์ตัวเลขสี่ตัวและป้ายกำกับแบบไบนารี เพื่อให้การรันใช้เพียงสี่ qubit และเสร็จเร็ว เซลล์ถัดไปเขียนข้อมูลเป็นไฟล์ CSV สี่ไฟล์ ได้แก่ ฟีเจอร์ฝึก ป้ายกำกับฝึก ฟีเจอร์ทดสอบ และฟีเจอร์สำหรับขั้นตอนที่ 4 ของตัวอย่างนี้ หากต้องการใช้ข้อมูลของคุณเอง ให้เขียนชุดฝึกและชุดทดสอบที่ประมวลผลล่วงหน้าแล้วลงไฟล์ด้วยรูปแบบเดียวกันแทน
from pathlib import Path

Path("x_train.csv").write_text("""f0,f1,f2,f3
0.7227,1.3355,1.9595,2.5562
0.2731,0.5779,0.8983,1.1624
0.1139,0.1817,0.2163,0.2426
0.0341,0.1311,0.0854,0.09
0.8996,1.6951,2.497,3.3407
0.9669,1.8906,2.7705,3.6569
0.6366,1.2821,1.8793,2.4602
0.7718,1.4979,2.2223,2.933
0.5465,1.1008,1.67,2.2195
0.9475,1.9423,2.8942,3.8199
0.8829,1.6842,2.4703,3.2865
0.0675,0.0365,0.0705,0.0162
""")
Path("y_train.csv").write_text("label\n1\n0\n0\n0\n1\n1\n0\n1\n0\n1\n1\n0\n")
Path("x_test.csv").write_text("""f0,f1,f2,f3
0.543,1.0786,1.5684,2.0607
0.9928,1.9037,2.9302,3.8422
0.2269,0.3637,0.4628,0.597
0.9896,1.9511,2.8913,3.8208
""")
Path("x_inference.csv").write_text("""f0,f1,f2,f3
0.2708,0.542,0.8506,1.0897
0.3585,0.6025,0.9517,1.2609
0.8871,1.6559,2.4577,3.2992
""")
95
อัปโหลดไฟล์ฝึกและไฟล์ทดสอบ คุณจะอัปโหลด x_inference.csv ในขั้นตอนที่ 4
for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
2. รันฟังก์ชัน
คำนวณขนาดของการรันจากข้อมูลที่คุณอัปโหลด ด้วยตัวคำนวณจาก ขนาดของฟังก์ชัน
import pandas as pd

x_train = pd.read_csv("x_train.csv")
y_train = pd.read_csv("y_train.csv")
x_test = pd.read_csv("x_test.csv")

size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
เลือกโปรเซสเซอร์ที่มี qubit อย่างน้อยเท่ากับจำนวนฟีเจอร์ในข้อมูลของคุณ และรันฟังก์ชันในโหมด fit-transform ด้วยขนาดนั้น ข้อมูลตัวอย่างมีฟีเจอร์สี่ตัว ดังนั้นโปรเซสเซอร์ IBM Quantum ตัวใดก็รันได้
backend = catalog.least_busy(operational=True, simulator=False)

job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv", "x_test.csv"],
    backend_name=backend.name,
    shots=5000,
    function_size=size,
)
print(job.job_id)
85dabc9f-a769-4f4a-8e92-f3be73f85ca2
ตรวจสอบสถานะของ workload หรือรับผลลัพธ์ดังนี้
# Monitor the job status
job.status()
'DONE'
result = job.result()

# Keep both: the mapping_id is the only handle on the mapping this run
# fitted, and the mapping runs only on the processor it was fitted on.
mapping_id = result["mapping_id"]
fit_backend_name = result["backend_name"]
3. ดึงผลลัพธ์
ดาวน์โหลดฟีเจอร์ที่ผ่านการแปลงเชิงควอนตัม ส่ง target_name เพื่อให้แต่ละไฟล์ถูกบันทึกภายใต้ชื่อของตัวเอง
for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
693iB [00:00, 171kiB/s]
254iB [00:00, 111kiB/s]
4. แมปข้อมูลใหม่
หลังจากฝึกโมเดลแล้ว ให้แมปข้อมูลใหม่ด้วยการแมปที่ฟิตไว้ เช่น เพื่อรัน inference ตัวอย่างนี้แมป x_inference.csv ซึ่งเซลล์แรกของตัวอย่างนี้เขียนไว้ ส่ง mapping_id ที่การฟิตคืนมา เพื่อให้แถวใหม่ถูกแมปด้วยการแมปเดิมแทนที่จะสร้างใหม่
การแมปถูกสร้างสำหรับผัง qubit ของโปรเซสเซอร์หนึ่งตัว ดังนั้นให้ส่ง backend_name เดียวกับการฟิต ซึ่งการฟิตคืนมาใน result["backend_name"] อย่าใช้ least_busy() เลือกโปรเซสเซอร์ เพราะอาจคืนตัวอื่น Rimay จะปฏิเสธโปรเซสเซอร์อื่นก่อนส่งอะไรทั้งสิ้น จำนวน shot ก็มาจากการฟิตเช่นกัน
catalog.file_upload("x_inference.csv", rimay)

x_inference = pd.read_csv("x_inference.csv")
size = calculate_function_size([x_inference], mode="transform")

job = rimay.run(
    mode="transform",
    input_file=["x_inference.csv"],
    # The processor the mapping was fitted on
    backend_name=fit_backend_name,
    shots=5000,
    mapping_id=mapping_id,
    function_size=size,
)
# Monitor the job status
job.status()
'DONE'
result = job.result()

for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
202iB [00:00, 73.5kiB/s]
5. ลบการแมป
เมื่อคุณไม่ต้องการการแมปที่ฟิตไว้แล้ว ให้ลบมัน การรัน delete ไม่ทำงานควอนตัมใดๆ จึงไม่ต้องใช้โปรเซสเซอร์ ไม่ต้องมี shot และไม่ต้องมีขนาดของฟังก์ชัน คุณยกเลิกการลบไม่ได้ หลังจากลบ mapping_id จะไม่อ้างถึงอะไรอีก และการรัน transform ด้วยมันจะล้มเหลว
job = rimay.run(mode="delete", mapping_id=mapping_id)
job.result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': '30L40joyUPYfnvgwo2d7MXXSzqvHkggR-Kzn81wfIYw',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
ดึงข้อความแสดงข้อผิดพลาด
หากสถานะ workload ของคุณเป็น ERROR ให้ใช้ job.error_message() เพื่อดึงข้อความแสดงข้อผิดพลาด ดังนี้
job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv"],
    backend_name=backend.name,
    shots=0,
)
job.error_message()
ทุกข้อผิดพลาดที่ Rimay รายงานมีรหัสจากรหัสข้อผิดพลาดของ IBM Quantum ข้อความ และวิธีแก้ที่ระบุค่าที่คุณส่งและค่าที่อนุญาต ตารางต่อไปนี้แสดงข้อผิดพลาดที่พบบ่อยที่สุด
| Code | Cause |
|---|---|
1221 | พารามิเตอร์หายไปหรือมีชนิดผิด, mode ไม่ถูกต้อง, ไฟล์ที่ระบุใน input_file ไม่ได้อัปโหลด, ไฟล์ไม่สอดคล้องกัน, ฟีเจอร์ไม่ใช่ตัวเลข หรือ mapping_id ไม่ตรงกับการแมปที่เก็บไว้ |
1221 | การรัน "transform" ระบุ backend_name ต่างจากการฟิตที่สร้างการแมปของมัน |
1216 | อินสแตนซ์ของคุณไม่มีโปรเซสเซอร์ที่ใช้ backend_name ที่คุณส่ง วิธีแก้จะแสดงรายการโปรเซสเซอร์ที่มี |
1200 | API key ของคุณไม่มีสิทธิ์เข้าถึงอินสแตนซ์ที่ job รันอยู่ |
3200 | backend_name ไม่ได้ขึ้นต้นด้วย ibm_ |
4500 | ข้อมูลมีฟีเจอร์มากกว่าจำนวน qubit ของโปรเซสเซอร์ |
6000 | จำนวนตัวอย่างคูณ shots เกิน 10 ล้านครั้ง |
6001 | shots น้อยกว่า 1 |
6002 | ข้อมูลมีตัวอย่างมากกว่าที่การรันหนึ่งครั้งอนุญาต |
กรณีการใช้งาน
ในการจัดประเภทข้อมูลตารางบนชุดข้อมูลขนาดเล็กถึงกลาง Kipu Quantum ได้ใช้การสกัดฟีเจอร์เชิงควอนตัมกับงานต่อไปนี้
นอกจากข้อมูลตาราง neural network ที่ถูกตรึง (frozen) สามารถแปลงรูปภาพเป็นฟีเจอร์ตัวเลข ซึ่งการสกัดฟีเจอร์เชิงควอนตัมจะแมปต่อเป็นฟีเจอร์ที่ผ่านการแปลงเชิงควอนตัม
ขอความช่วยเหลือ
หากต้องการความช่วยเหลือ ติดต่อ support@kipu-quantum.com
ขั้นตอนถัดไป
-
ไปที่ API reference ของ Qiskit Function นี้
-
ลองทำบทแนะนำ Classify credit risk with Kipu Quantum's Rimay quantum feature extraction
เอกสารอ้างอิง
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.
ข้อมูลเพิ่มเติม
Rimay เป็นคำในภาษาเกชัว (Quechua) แปลว่า "อธิบาย"