รีเฟรชคุณสมบัติของ backend ด้วยการ benchmark แบบ real-time
ประมาณการใช้งาน: 3 นาทีบน ibm_kingston (หมายเหตุ: นี่เป็นเพียงการประมาณเท่านั้น เวลารันจริงของคุณอาจแตกต่างไป)
ผลลัพธ์การเรียนรู้
-
เหตุใดคุณสมบัติที่ QPU รายงานจึงอาจล้าหลังพฤติกรรมปัจจุบันของอุปกรณ์ และเมื่อใดที่คุ้มค่าที่จะวัดใหม่ด้วยตัวเอง
-
การทดลองการจำแนกคุณลักษณะมาตรฐานทั้งห้าแบบ (readout, single-qubit randomized benchmarking, layered two-qubit randomized benchmarking, และ ) แต่ละแบบวัดอะไร
-
วิธีรันชุดการจำแนกคุณลักษณะทั้งหมดในการเรียกครั้งเดียวหรือทีละขั้นตอน และรับออบเจ็กต์ backend ที่มีคุณสมบัติที่รีเฟรชแล้วกลับมา
-
วิธีเปรียบเทียบคุณสมบัติที่วัดได้กับคุณสมบัติที่รายงาน และเหตุใดความแตกต่างบางอย่างจึงสะท้อนถึงวิธีการวัดมากกว่าการดริฟต์ของอุปกรณ์
ข้อกำหนดเบื้องต้น
-
เวิร์กโฟลว์ Qiskit patterns
-
โหมดการรัน Qiskit Runtime โดยเฉพาะ batch mode
-
วิธีสำรวจ ข้อมูล QPU เช่น คุณสมบัติของ backend และข้อมูลการปรับเทียบ
ความเป็นมา
IBM Quantum® QPU ทุกตัวรายงานชุดคุณสมบัติที่อธิบายว่าคิวบิตแต่ละตัวทำงานได้ดีเพียงใดในปัจจุบัน: เวลา relaxation (), เวลา coherence (), ความผิดพลาดของ readout, และความผิดพลาดของ gate หนึ่งและสองคิวบิต ตัวเลขเหล่านี้มีความสำคัญในทางปฏิบัติ transpiler ใช้ตัวเลขเหล่านี้เพื่อตัดสินใจว่าคิวบิตทางกายภาพใดที่ Circuit ของคุณควรรัน เทคนิคการลดความผิดพลาดอาศัยตัวเลขเหล่านี้ และคุณอาจใช้ตัวเลขเหล่านี้เพื่อตัดสินว่าอุปกรณ์ทำงานได้ดีเพียงพอสำหรับการทดลองหรือไม่
คุณสมบัติที่รายงานมาจากกระบวนการปรับเทียบ ซึ่งโดยทั่วไปจะรันประมาณวันละครั้ง อย่างไรก็ตาม คิวบิตแบบตัวนำยิ่งยวดสามารถดริฟต์ได้ในช่วงเวลาที่สั้นกว่า และข้อบกพร่องชั่วคราว (ที่เรียกว่า two-level system) สามารถทำให้คิวบิตที่ดูดีเยี่ยมในเวลาปรับเทียบเสื่อมสภาพลงชั่วคราวได้ นอกจากนี้ job มักจะถูก transpile ไว้ก่อนที่จะรันจริงนานพอสมควร ดังนั้นการตัดสินใจที่อิงจากคุณสมบัติที่รายงานอาจตั้งอยู่บนข้อมูลที่ล้าสมัย บทเรียน การ benchmark แบบ real-time สำหรับการเลือกคิวบิต แสดงให้เห็นว่าคุณสมบัติเหล่านี้สามารถผันผวนได้มากเพียงใดในแต่ละวัน และสร้างเวิร์กโฟลว์การจำแนกคุณลักษณะแบบเต็มด้วยมือจาก Qiskit Experiments แต่ละตัว
บทเรียนนี้แสดงเวอร์ชันที่คล่องตัวของเวิร์กโฟลว์นั้น โดยใช้ยูทิลิตี้ BackendCharacterization จาก Qiskit Device Benchmarking ซึ่งรวมการสร้างการทดลอง, การส่ง job, และการ fit เส้นโค้งไว้ในการเรียกไม่กี่ครั้ง คุณใช้เวลา QPU ประมาณ 70 วินาที และได้ออบเจ็กต์ backend ที่มีคุณสมบัติสะท้อนอุปกรณ์ ในขณะนี้ พร้อมที่จะเปรียบเทียบกับค่าที่รายงาน หรือส่งต่อไปยังเครื่องมือขั้นถัดไป
การทดลองการจำแนกคุณลักษณะ
suite นี้วัดคุณสมบัติห้าอย่าง แต่ละอย่างมีการทดลองมาตรฐาน:
-
ความผิดพลาดของ Readout (
readout): คิวบิตแต่ละตัวถูกเตรียมใน หรือ และวัดทันที ความน่าจะเป็นของการอ่าน state ผิดให้ความผิดพลาดของ state preparation and measurement (SPAM) -
ความผิดพลาดของ Gate หนึ่งคิวบิต (
rb_1q): Randomized benchmarking (RB) รันลำดับของ single-qubit Clifford gate แบบสุ่มที่ในอุดมคติจะรวมกันเป็น identity วิธีที่ความน่าจะเป็นในการอยู่รอดสลายตัวไปตามความยาวของลำดับให้ความผิดพลาดเฉลี่ยต่อ gate โดยไม่ขึ้นกับความผิดพลาดของ SPAM -
ความผิดพลาดของ Gate สองคิวบิต (
rb_2q): แนวคิด RB แบบเดียวกันที่นำไปใช้กับเลเยอร์ทั้งหมดของ Gate สองคิวบิตที่ไม่ทับซ้อนกันซึ่งรันพร้อมกัน เหมือนกับการทดลอง layer fidelity เนื่องจากมี Gate จำนวนมากรันพร้อมกัน อัตราความผิดพลาดที่ได้จึงรวมผลของ crosstalk และใกล้เคียงกับสิ่งที่ Circuit ที่ลึกจะเจอจริง ๆ มากกว่า -
(
t1): แต่ละคิวบิตจะถูกกระตุ้นและวัดหลังจากดีเลย์ที่เพิ่มขึ้นเรื่อย ๆ การสลายตัวของสัดส่วนสถานะกระตุ้นให้ค่าเวลาผ่อนคลาย (relaxation time) -
(
t2): การทดลอง Hahn echo จะทำให้แต่ละคิวบิตอยู่ในสถานะซ้อนทับ (superposition) ใช้พัลส์ echo ที่กึ่งกลางของดีเลย์ และวัดว่าความคงสภาพของเฟส (phase coherence) สูญเสียไปเร็วแค่ไหน โดยค่าเริ่มต้นจะใช้ echo เดียว ส่วนแบบหลาย echo (แบบ CPMG) จะสาธิตในตอนท้ายของบทเรียนนี้
สิ่งที่การรีเฟรชทำและไม่ทำ
จำสามประเด็นนี้ไว้เมื่อใช้เวิร์กโฟลว์นี้:
-
คุณสมบัติที่รีเฟรชแล้วจะอยู่เฉพาะใน backend object ที่ส่งคืนให้คุณเท่านั้น ไม่มีอะไรเปลี่ยนแปลงบนอุปกรณ์เองหรือในข้อมูลการปรับเทียบ (calibration) ที่ IBM Quantum รายงานให้ผู้ใช้คนอื่น
-
ค่าที่วัดได้เป็นภาพรวม (snapshot) ที่ถ่ายด้วยวิธีการเฉพาะ ค่าบางส่วน โดยเฉพาะความผิดพลาดของ Gate สองคิวบิตแบบเลเยอร์และค่า แบบ single-echo ที่วัดพร้อมกัน จะถูกวัดด้วยวิธีที่ต่างจากข้อมูลการปรับเทียบที่รายงานไว้ ดังนั้นส่วนหนึ่งของช่องว่างที่คุณสังเกตเห็นจึงเกิดจากวิธีการมากกว่าการดริฟต์ บทเรียนนี้จะชี้ให้เห็นว่าจุดไหนที่เป็นเช่นนั้น
-
การจำแนกคุณลักษณะ (characterization) เองก็ใช้เวลา QPU (ประมาณ 70 วินาทีสำหรับชุดเต็มบนโปรเซสเซอร์ Heron r2) ซึ่งเป็นราคาที่ต้องจ่ายเพื่อให้ได้ข้อมูลที่ทันสมัย
เวิร์กโฟลว์นี้เป็นไปตามสี่ขั้นตอนของ Qiskit pattern:
-
ขั้นตอนที่ 1: แมปอินพุตแบบคลาสสิกให้เป็นปัญหาควอนตัม เลือกอุปกรณ์และชุดคุณสมบัติที่จะวัด
-
ขั้นตอนที่ 2: ปรับปัญหาให้เหมาะกับการรันบนฮาร์ดแวร์ควอนตัม ยูทิลิตี้นี้สร้าง Circuit การทดลองโดยตรงด้วย Gate ดั้งเดิมของอุปกรณ์ และรันแบบขนานทั่วทั้งชิป
-
ขั้นตอนที่ 3: รันโดยใช้ Qiskit primitives การทดลองรันเป็นงาน Sampler ภายใน batch
-
ขั้นตอนที่ 4: ประมวลผลต่อและส่งคืนผลลัพธ์ในรูปแบบคลาสสิกที่ต้องการ ฟิตข้อมูลการวัดให้เป็นแผนที่ความผิดพลาดต่อคิวบิต รีเฟรช Backend และเปรียบเทียบคุณสมบัติที่วัดได้กับค่าที่รายงานไว้
ข้อกำหนด
ก่อนเริ่มบทเรียนนี้ ตรวจสอบให้แน่ใจว่าคุณติดตั้งสิ่งต่อไปนี้แล้ว:
-
Qiskit SDK v2.0 หรือใหม่กว่า พร้อมการรองรับ visualization
-
Qiskit Runtime v0.40 หรือใหม่กว่า (
pip install qiskit-ibm-runtime) -
Qiskit Device Benchmarking ซึ่งจะติดตั้ง Qiskit Experiments ให้ด้วย (
pip install git+https://github.com/qiskit-community/qiskit-device-benchmarking.git)
การตั้งค่า
นำเข้าไลบรารีที่จำเป็น
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit_device_benchmarking": "git+https://github.com/qiskit-community/qiskit-device-benchmarking.git", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import logging
import sys

import numpy as np
from qiskit_ibm_runtime import Batch, QiskitRuntimeService

from qiskit_device_benchmarking.utilities.characterization_utils import (
    BackendCharacterization,
    plot_characterization_comparison,
)
ชุดการจำแนกคุณลักษณะจะสร้างการทดลองหลายรายการ ส่งงานหลายงาน และฟิตผลลัพธ์ ซึ่งอาจใช้เวลารวมสักสองสามนาที เปิดใช้งานการล็อกระดับ INFO เพื่อให้แต่ละขั้นตอนแสดงความคืบหน้าขณะที่มันเกิดขึ้น
logger = logging.getLogger("qiskit_device_benchmarking")
logger.setLevel(logging.INFO)
logger.addHandler(logging.StreamHandler(stream=sys.stdout))
ตัวอย่าง Simulator ขนาดเล็ก
บทเรียนนี้ไม่มีตัวอย่าง Simulator เวิร์กโฟลว์นี้วัดความไม่สมบูรณ์ทางกายภาพของอุปกรณ์เฉพาะเครื่องหนึ่ง เช่น คิวบิตของมันผ่อนคลายและเสียเฟสเร็วแค่ไหน และ Gate กับการอ่านค่า (readout) ของมันล้มเหลวบ่อยแค่ไหน Simulator ในอุดมคติไม่มีความไม่สมบูรณ์เหล่านี้เลย จึงไม่มีอะไรให้จำแนกคุณลักษณะ คุณสามารถแนบโมเดลสัญญาณรบกวนสังเคราะห์ไปกับ fake backend ได้ แต่การทดลองก็จะได้ตัวเลขที่คุณใส่เข้าไปเองกลับคืนมาเท่านั้น ด้วยเหตุนี้ เราจึงไปที่ฮาร์ดแวร์โดยตรง แบ่งเป็นสี่ขั้นตอนของ Qiskit pattern
ตัวอย่างฮาร์ดแวร์ขนาดใหญ่
ขั้นตอนที่ 1: แมปอินพุตแบบคลาสสิกให้เป็นปัญหาควอนตัม
ในเวิร์กโฟลว์นี้ "ปัญหา" คือตัวอุปกรณ์เอง อินพุตแบบคลาสสิกคือ QPU ที่คุณต้องการจำแนกคุณลักษณะและรายการคุณสมบัติที่จะวัด ส่วนการทดลองควอนตัมคือ Circuit การจำแนกคุณลักษณะที่สร้างขึ้นจากอินพุตเหล่านั้น
ขั้นแรก เลือก Backend บทเรียนนี้ใช้ ibm_kingston ซึ่งเป็นโปรเซสเซอร์ Heron r2 ขนาด 156 คิวบิต คุณสามารถใช้อุปกรณ์ IBM Quantum อื่นใดที่คุณมีสิทธิ์เข้าถึงแทนได้ (หรือเลือกด้วย service.least_busy())
service = QiskitRuntimeService()
device = "ibm_kingston"
backend = service.backend(device)
ถัดไป เลือกคุณสมบัติที่จะวัด คุณสามารถส่งชุดย่อยใด ๆ ของการทดลองต่อไปนี้ได้:
-
readout: การทดลอง SPAM (state preparation and measurement) -
rb_1q: randomized benchmarking แบบคิวบิตเดี่ยวที่แยกอิสระ -
rb_2q: randomized benchmarking แบบสองคิวบิตที่รันพร้อมกัน จากการทดลอง layer fidelity -
t2: การทดลอง Hahn echo (ใช้ echo เดียวโดยค่าเริ่มต้น) -
t1: การทดลอง relaxation
รันชุดเต็มเพื่อให้ได้ภาพรวมที่สมบูรณ์ของอุปกรณ์ ตัดรายการออกได้หากคุณสนใจเฉพาะบางคุณสมบัติและต้องการประหยัดเวลา QPU
experiments = ["readout", "rb_1q", "rb_2q", "t1", "t2"]
ขั้นตอนที่ 2: ปรับปัญหาให้เหมาะกับการรันบนฮาร์ดแวร์ควอนตัม
ในบทเรียนส่วนใหญ่ นี่คือจุดที่คุณจะทำการ transpile Circuit ของคุณ แต่ในที่นี้ BackendCharacterization จะจัดการเรื่องนั้นให้ภายในตัวเอง สร้าง Circuit การทดลองโดยตรงด้วย Gate ดั้งเดิมของอุปกรณ์ รันการทดลองคิวบิตเดี่ยวบนคิวบิตทั้งหมดพร้อมกัน และจัดตารางการ benchmark สองคิวบิตทั่วเลเยอร์ที่ไม่ทับซ้อนกันของ coupling map เพื่อให้ครอบคลุมทั้งอุปกรณ์ด้วย job เพียงไม่กี่ตัว เนื่องจากการรันแบบขนานนี้ ชุดทั้งหมดจึงใช้เวลา QPU เพียงประมาณ 70 วินาที
เริ่มต้นคลาสที่จัดการเวิร์กโฟลว์:
# Initialize the class used to run the experiments
characterizer = BackendCharacterization(backend)
ขั้นตอนที่ 3: รันโดยใช้ Qiskit primitives
เมท็อด run_experiments จะสร้าง Circuit และส่งเป็นงาน Sampler รันภายในบริบท Batch เพื่อให้งานถูกจัดตารางร่วมกันบน QPU และเมท็อดจะคืนค่าเมื่อส่งงานทั้งหมดแล้ว (คุณสามารถรันนอก batch หรือภายใน Session ก็ได้เช่นกัน)
คุณอาจเห็นคำเตือนเกี่ยวกับการส่ง backend ในขณะที่ session context manager เปิดอยู่ นี่เป็นเรื่องที่คาดไว้แล้วและสามารถละเว้นได้อย่างปลอดภัย
# Run the characterization experiments inside a Batch
with Batch(backend=backend):
    jobs = characterizer.run_experiments(experiments=experiments)
base_primitive.get_mode_service_backend:WARNING:2026-07-14 14:23:02,051: A backend was passed in as the mode but a session context manager is open so this job will run inside this session/batch instead of in job mode.
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7tfu6hjac73ffba2g', 'd9b7tjug26ic73dfju3g', 'd9b7u3u6hjac73ffban0', 'd9b7u7rv6alc73csmicg']
Readout job submitted: d9b7u8bv6alc73csmidg
T1 experiment submitted: ['d9b7u8ug26ic73dfjuqg']
T2 (Hahn) experiment submitted: ['d9b7u9fu62qs738othg0']
Single-qubit RB submitted: ['d9b7v8m6hjac73ffbc40', 'd9b7veeg26ic73dfk040']
เมท็อดนี้คืนค่างานที่ส่งไปเป็นดิกชันนารีที่คีย์ด้วยชื่อการทดลอง ซึ่งมีประโยชน์สำหรับการติดตามงานบน IBM Quantum Platform dashboard หรือสำหรับดีบัก
# Print all the job IDs for debugging purposes
jobs
{'rb_2q': [<RuntimeJobV2('d9b7tfu6hjac73ffba2g', 'sampler')>,
  <RuntimeJobV2('d9b7tjug26ic73dfju3g', 'sampler')>,
  <RuntimeJobV2('d9b7u3u6hjac73ffban0', 'sampler')>,
  <RuntimeJobV2('d9b7u7rv6alc73csmicg', 'sampler')>],
 'readout': [<RuntimeJobV2('d9b7u8bv6alc73csmidg', 'sampler')>],
 't1': [<RuntimeJobV2('d9b7u8ug26ic73dfjuqg', 'sampler')>],
 't2': [<RuntimeJobV2('d9b7u9fu62qs738othg0', 'sampler')>],
 'rb_1q': [<RuntimeJobV2('d9b7v8m6hjac73ffbc40', 'sampler')>,
  <RuntimeJobV2('d9b7veeg26ic73dfk040', 'sampler')>]}
ขั้นตอนที่ 4: ประมวลผลต่อและส่งคืนผลลัพธ์ในรูปแบบคลาสสิกที่ต้องการ
วิเคราะห์ผลลัพธ์
เมท็อด analyze_results จะรอให้งานเสร็จสิ้นและฟิตข้อมูลการวัด ได้แก่ การสลายตัวแบบเอ็กซ์โพเนนเชียลสำหรับ และ การสลายตัวของความน่าจะเป็นในการอยู่รอด (survival probability) สำหรับการทดลอง RB และเมทริกซ์การกำหนด (assignment matrix) สำหรับ readout คืนค่าดิกชันนารีของ error maps หนึ่งรายการต่อคุณสมบัติที่วัด แต่ละรายการแมปคิวบิต (หรือคู่คิวบิต) ไปยังค่าที่วัดได้
error_maps = characterizer.analyze_results()
print(f"The following error maps are available: {list(error_maps.keys())}")
readout_q0 = error_maps["readout_error"][0]
print(f"For example, readout error for qubit 0 is {readout_q0}")
The following error maps are available: ['readout_error', 'oneq_error_x', 'oneq_error_sx', 'lf_error_map', 't1_map', 't2_map']
For example, readout error for qubit 0 is 0.007600000000000051
แผนที่เหล่านี้ครอบคลุมความผิดพลาดของ readout, ความผิดพลาดของ Gate x และ sx แบบคิวบิตเดี่ยว, ความผิดพลาดของ Gate สองคิวบิตแบบเลเยอร์ (lf_error_map จากการทดลอง layer fidelity) และเวลา กับ เป็นวินาที
อัปเดตคุณสมบัติของ Backend
เมท็อด update_backend จะเขียนค่าที่วัดได้ลงในคุณสมบัติของสำเนา Backend แล้วคืนค่ากลับมา ออบเจกต์ backend เดิมยังคงเก็บข้อมูลการปรับเทียบที่รายงานไว้ เพื่อให้เราสามารถเปรียบเทียบทั้งสองอย่างได้ตามที่แสดงด้านล่าง โปรดจำไว้ว่าการอัปเดตนี้เป็นเพียงในเซสชัน Python ของคุณเองเท่านั้น มันไม่เปลี่ยนแปลงอะไรบนอุปกรณ์หรือสำหรับผู้ใช้คนอื่น
backend_updated = characterizer.update_backend()
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
เปรียบเทียบคุณสมบัติที่วัดได้กับค่าที่รายงานไว้
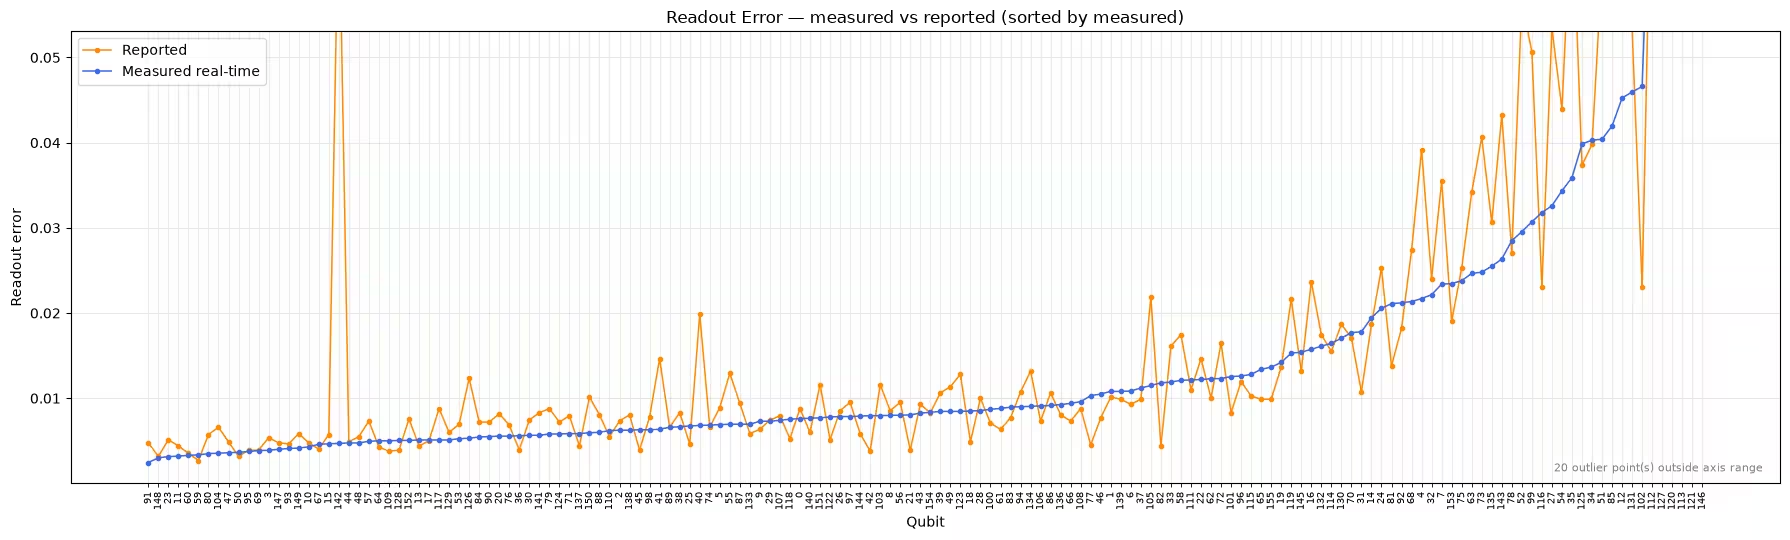
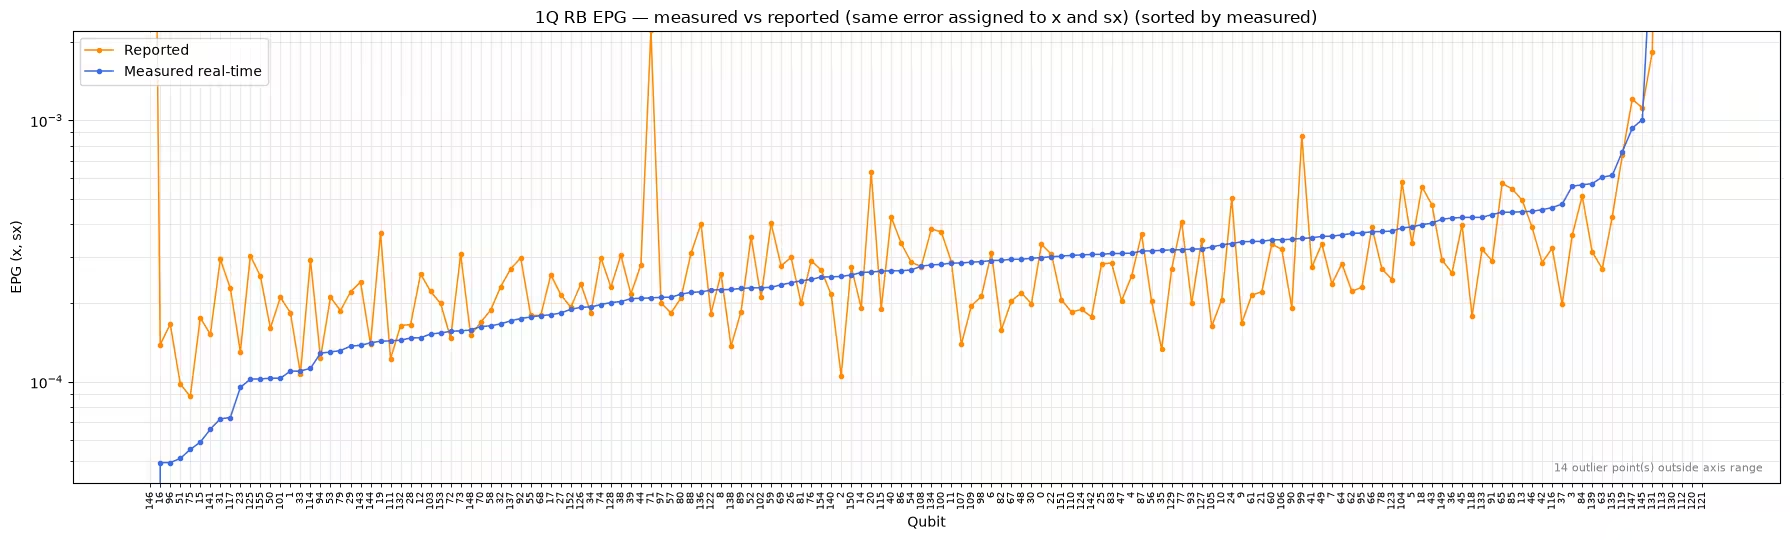
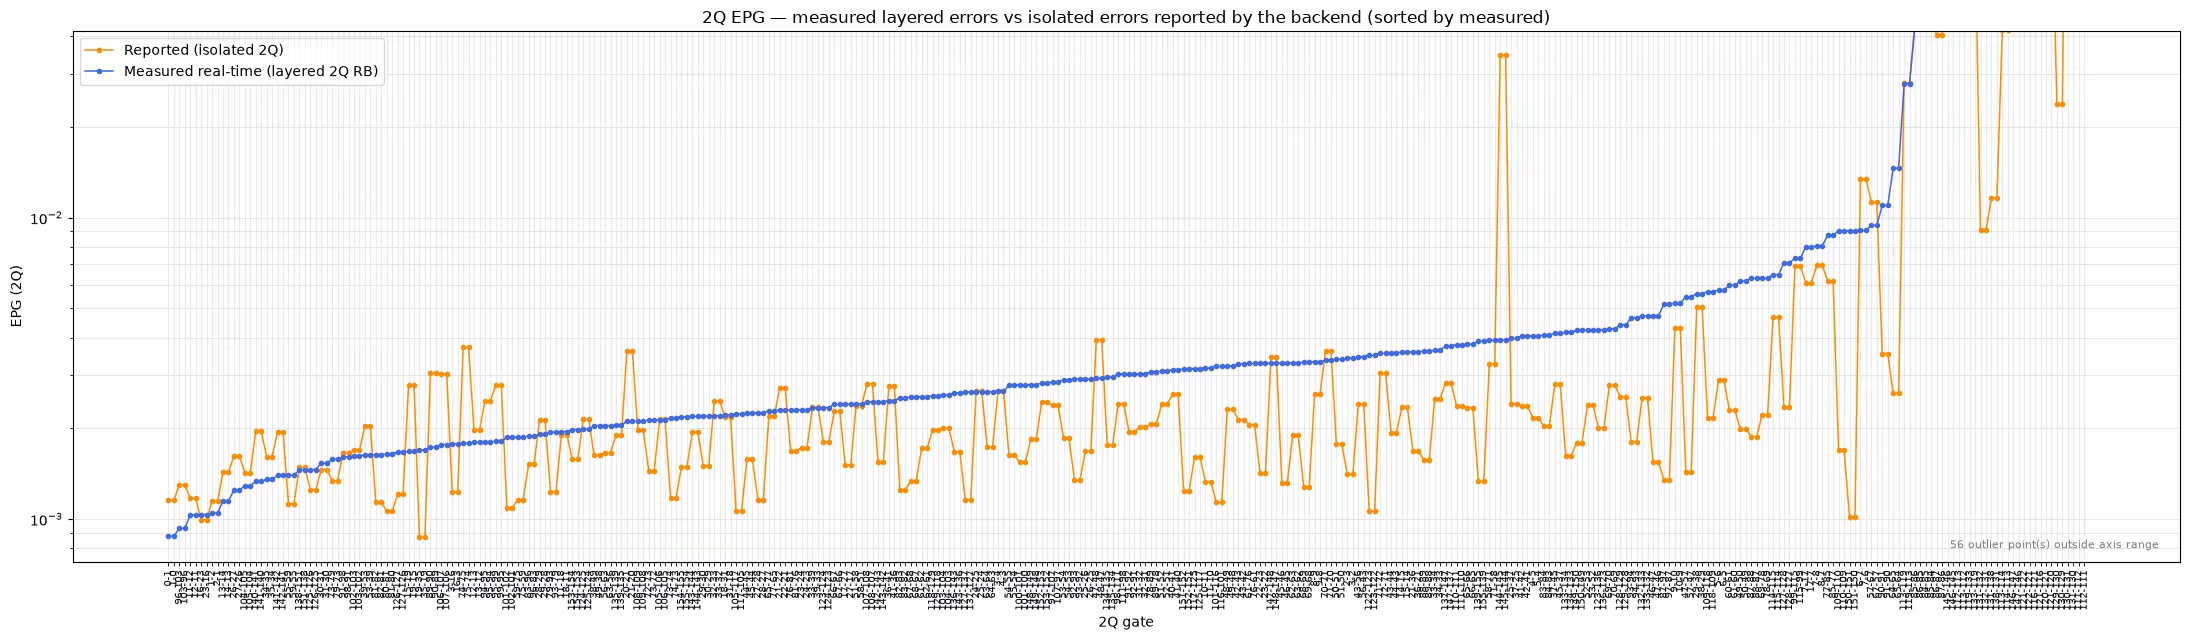
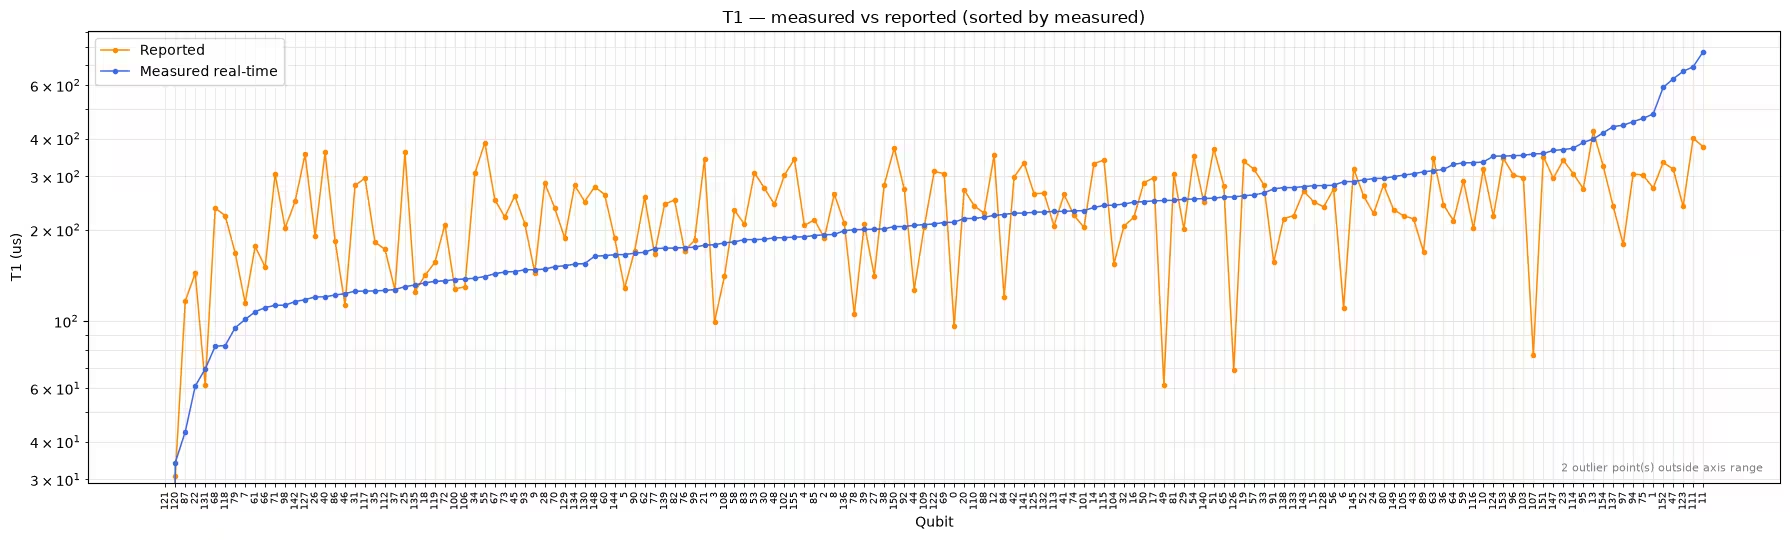
สุดท้าย พล็อตคุณสมบัติแบบ real-time ที่วัดได้เทียบกับค่าที่ Backend รายงาน ในแต่ละพาเนล คิวบิต (หรือคู่คิวบิต) จะถูกเรียงลำดับตามค่าที่วัดได้ ดังนั้นเส้นโค้งที่วัดได้จึงเรียบอยู่แล้วโดยปริยายจากการเรียงลำดับ และการกระจายตัวของค่าที่รายงานรอบ ๆ เส้นนั้นแสดงให้เห็นว่าทั้งสองไม่ตรงกันตรงไหน มีการแสดงพล็อตเดียวสำหรับ RB คิวบิตเดี่ยว เนื่องจากค่าความผิดพลาดต่อ Gate ที่วัดได้ค่าเดียวกันถูกกำหนดให้กับทั้ง Gate x และ sx ขอบเขตแกนถูกเลือกจากส่วนใหญ่ของข้อมูลเพื่อไม่ให้ค่าผิดปกติสุดขั้วเพียงไม่กี่จุดบีบอัดพล็อต จุดใดก็ตามที่อยู่นอกช่วงจะถูกนับในคำอธิบายประกอบบนพล็อต (หรือส่ง ylim เพื่อกำหนดขอบเขตเอง)
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated.properties().to_dict(),
    plots=["readout", "rb_1q", "rb_2q", "t1", "t2"],
)
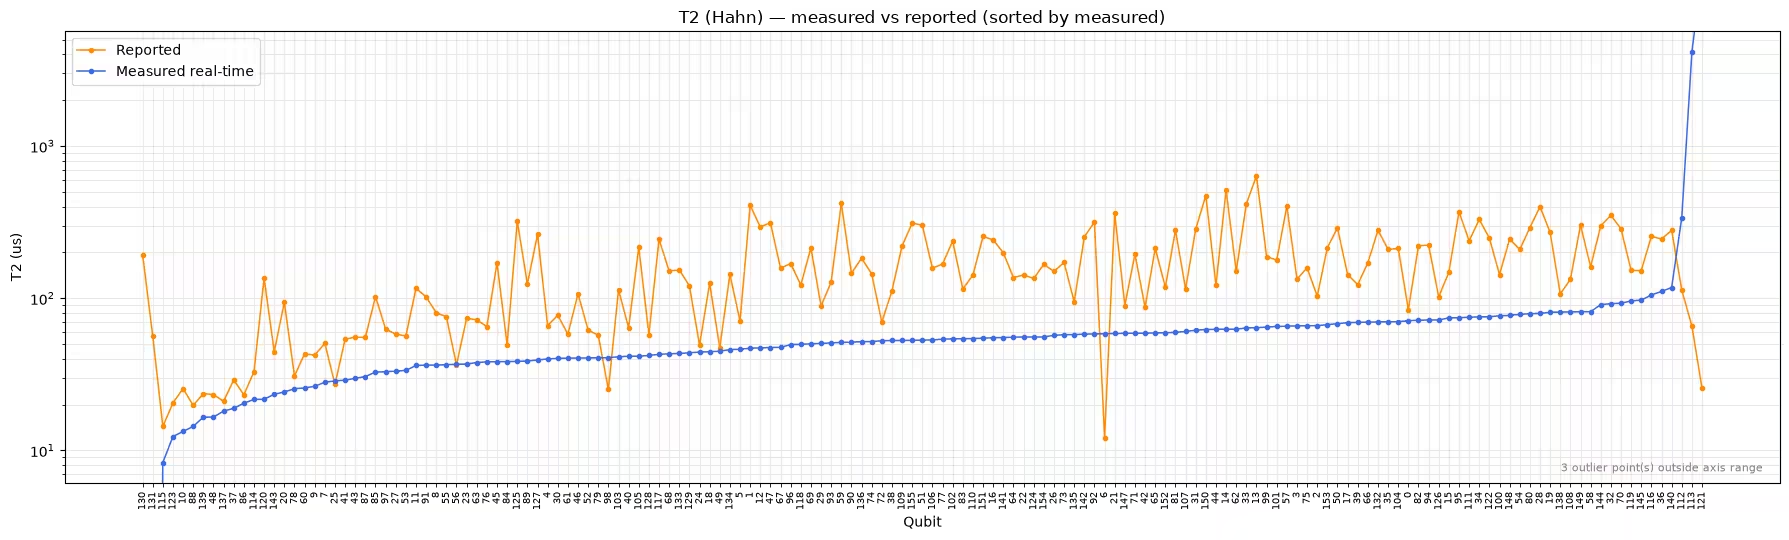
พล็อตเหล่านี้ต้องอ่านอย่างระมัดระวัง เพราะไม่ใช่ทุกช่องว่างระหว่างเส้นโค้งทั้งสองจะหมายความว่าอุปกรณ์ดริฟต์ไป:
-
ความผิดพลาดของ Readout และคิวบิตเดี่ยว: ค่าที่วัดได้ใกล้เคียงกับค่าที่รายงานสำหรับคิวบิตส่วนใหญ่ ในขณะที่ค่าที่รายงานของคิวบิตไม่กี่ตัวอยู่ห่างจากเส้นโค้งที่วัดได้มาก ความไม่ตรงกันเฉพาะจุดเหล่านี้คือการดริฟต์ที่เวิร์กโฟลว์นี้ถูกออกแบบมาเพื่อจับ
-
: ชุดข้อมูลทั้งสองกระจายตัวรอบกันโดยไม่มีการเบี่ยงเบนอย่างเป็นระบบ ซึ่งสอดคล้องกับการที่ ผันผวนตามธรรมชาติเมื่อเวลาผ่านไป
-
ความผิดพลาดของ Gate สองคิวบิต: ค่าที่วัดได้อยู่สูงกว่าค่าที่รายงานอย่างเป็นระบบ นี่เป็นสิ่งที่คาดไว้ เพราะค่าที่รายงานวัดจาก Gate ที่แยกอิสระ ในขณะที่การทดลอง layer fidelity รัน Gate จำนวนมากพร้อมกัน จึงรวมผลของ crosstalk ด้วย ตัวเลขแบบเลเยอร์เกี่ยวข้องมากกว่ากับ Circuit ที่ลึก แต่ไม่สามารถเทียบกับข้อมูลการปรับเทียบที่รายงานได้โดยตรง
-
: ค่าที่วัดได้อยู่ต่ำกว่าค่าที่รายงานอย่างชัดเจนสำหรับคิวบิตส่วนใหญ่ อีกครั้งที่วิธีการมีบทบาทสำคัญ ดังที่จะพิจารณาในหัวข้อถัดไป
ตรวจสอบผลการทดลองแต่ละรายการ
คุณยังสามารถตรวจสอบผลลัพธ์ดิบของการทดลองจำแนกคุณลักษณะแต่ละรายการได้ผ่านคุณสมบัติ experiment_data ซึ่งคืนค่าออบเจกต์ ExperimentData ของ Qiskit Experiments ที่อยู่เบื้องหลัง ตัวอย่างเช่น ด้านล่างนี้แสดงเส้นโค้งการสลายตัวของ ที่วัดได้ของคิวบิตเดี่ยว ซึ่งมีประโยชน์สำหรับตรวจสอบคุณภาพของการฟิตก่อนที่จะเชื่อถือตัวเลขที่ได้
t1_data = characterizer.experiment_data["t1"]

# Each qubit has its own fit figure
n_figs = len(t1_data.figure_names)
print(f"{n_figs} figures available, e.g. {t1_data.figure_names[0]}")

# Show the T1 decay curve of the first qubit
t1_data.figure(0)
156 figures available, e.g. T1_Q0_c78ef792.svg

วัด T2 ด้วยชุดพัลส์ dynamical decoupling
โดยค่าเริ่มต้น การทดลอง จะใช้ Hahn echo เดียวและวัดคิวบิตทั้งหมดพร้อมกัน ซึ่งจากพล็อตเปรียบเทียบด้านบนแสดงให้เห็นว่าอาจให้ค่า ต่ำกว่าที่ Backend รายงานอย่างเห็นได้ชัด สมมติฐานหนึ่งคือจำนวน echo ค่าที่รายงานอาจถูกปรับเทียบด้วย dynamical decoupling ซึ่งช่วยกดสัญญาณรบกวนความถี่ต่ำ เพื่อทดสอบสิ่งนี้ ให้รันการจำแนกคุณลักษณะเฉพาะ โดยตั้งค่า t2_num_echoes ให้มีค่ามากขึ้น ซึ่งจะใช้ชุดพัลส์ echo แบบ CPMG ดีเลย์แทนเวลาวิวัฒนาการอิสระทั้งหมดในทั้งสองกรณี ดังนั้นค่า ที่ฟิตได้จึงสามารถเทียบกับผลลัพธ์แบบ single-echo ได้โดยตรง
# Run a T2-only characterization using a CPMG-style train of 8 echoes
characterizer_dd = BackendCharacterization(backend)
backend_updated_dd = characterizer_dd.run_and_update(
    experiments=["t2"], t2_num_echoes=8
)
Building T2 experiments
T2 (Hahn) experiment submitted: ['d9b96s6g26ic73dflcn0']
Updating T2
# Compare the multi-echo T2 against the backend-reported values
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated_dd.properties().to_dict(),
    plots=["t2"],
    title_prefix="8-echo CPMG",
)

# Compare medians across the reported values, the single-echo run,
# and the 8-echo run
reported_t2s = [
    prop["value"]
    for qubit in backend.properties().to_dict()["qubits"]
    for prop in qubit
    if prop["name"] == "T2"
]
t2_reported = np.median(reported_t2s)
t2_single = np.median(list(error_maps["t2_map"].values())) * 1e6
t2_dd = (
    np.median(list(characterizer_dd.analyze_results()["t2_map"].values()))
    * 1e6
)
print(
    f"Median T2 — reported: {t2_reported:.0f} us | "
    f"single echo: {t2_single:.0f} us | 8-echo CPMG: {t2_dd:.0f} us"
)
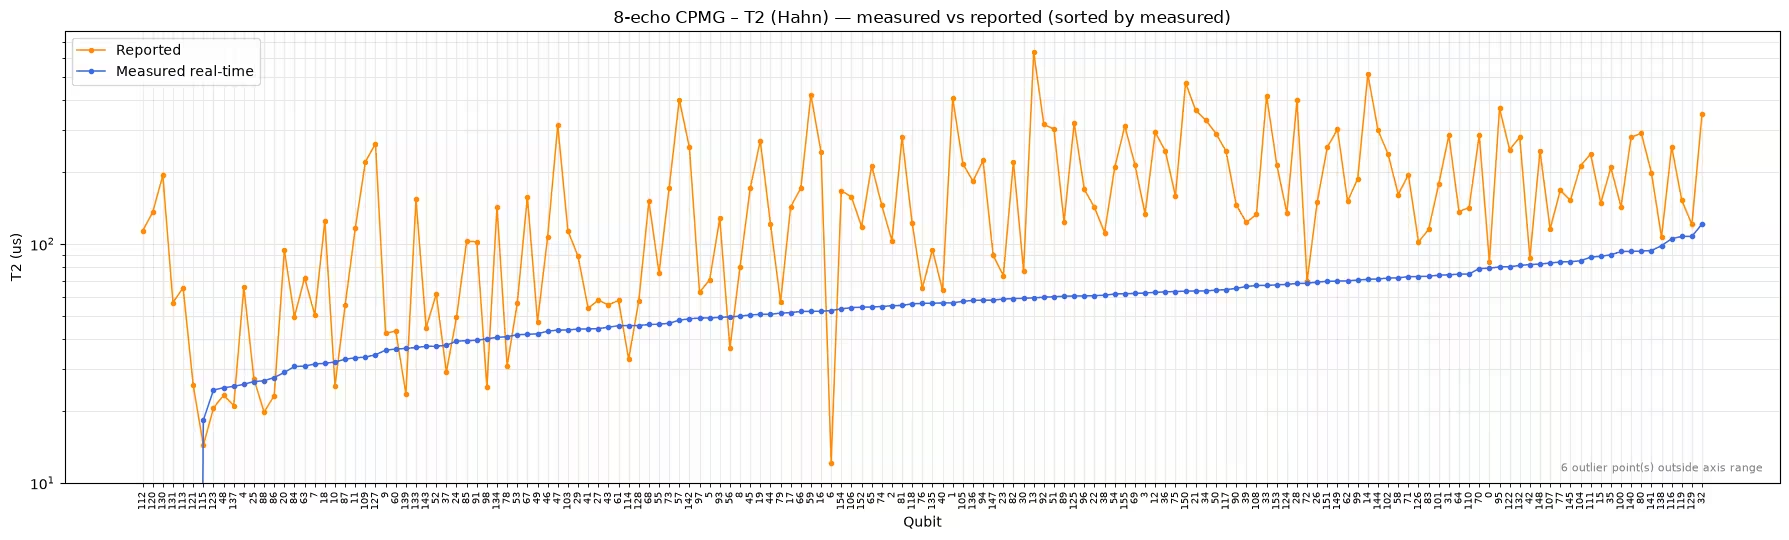
Median T2 — reported: 142 us | single echo: 53 us | 8-echo CPMG: 56 us
ในการรันครั้งนี้ echo ที่เพิ่มขึ้นแทบไม่เปลี่ยนแปลงผลลัพธ์เลย ค่ามัธยฐานของ 8-echo (56 µs) ใกล้เคียงกับแบบ single-echo (53 µs) และทั้งสองยังคงต่ำกว่าค่ามัธยฐานที่รายงาน (142 µs) มาก จำนวน echo เพียงอย่างเดียวไม่สามารถอธิบายช่องว่างนี้ได้ ยังมีความแตกต่างของวิธีการอื่น ๆ เข้ามาเกี่ยวข้อง เช่น รายละเอียดขั้นตอนการปรับเทียบ การวัดคิวบิตทั้งหมดพร้อมกันแทนที่จะวัดแยกอิสระ และอื่น ๆ
บทเรียนเชิงปฏิบัติคือ ควรระมัดระวังในการเปรียบเทียบ (และความผิดพลาดของ Gate สองคิวบิตแบบเลเยอร์) ข้ามวิธีการ ค่าที่รีเฟรชแล้วเป็นภาพรวมที่สอดคล้องในตัวเองซึ่งถ่ายภายใต้เงื่อนไขที่ใกล้เคียงกับภาระงานจริง ทำให้เหมาะสำหรับการเปรียบเทียบคิวบิตกันเองหรือติดตามอุปกรณ์เมื่อเวลาผ่านไป อย่างไรก็ตาม ช่องว่างเมื่อเทียบกับข้อมูลการปรับเทียบที่รายงานไว้ไม่ได้เป็นหลักฐานของการดริฟต์โดยอัตโนมัติ
ขั้นตอนที่ 1–4 อัดรวมเป็นการเรียกครั้งเดียว
สำหรับการใช้งานประจำวัน คุณแทบไม่จำเป็นต้องใช้ผลลัพธ์ระดับกลาง เมท็อด run_and_update เชื่อมทุกอย่างที่คุณทำด้านบน (สร้าง, ส่ง, ฟิต และอัปเดต) เข้าเป็นการเรียกครั้งเดียวที่คืนค่า Backend ที่รีเฟรชแล้ว รับรายการ experiments แบบเดียวกัน (และส่งต่อออปชันอย่าง t2_num_echoes) และสามารถห่อด้วยบริบท Batch หรือ Session ได้เช่นกัน
เซลล์ต่อไปนี้จะไม่ return จนกว่า job ทั้งหมดและ post-processing จะเสร็จสิ้น
# Initialize a fresh characterizer
characterizer = BackendCharacterization(backend)

# Run all of the experiments and update the backend in a single call
backend_updated = characterizer.run_and_update(experiments=experiments)
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7oqnu62qs738otat0', 'd9b7p76g26ic73dfjolg', 'd9b7pnm6hjac73ffb57g', 'd9b7q4fu62qs738otce0']
Readout job submitted: d9b7q4mg26ic73dfjprg
T1 experiment submitted: ['d9b7q57u62qs738otcfg']
T2 (Hahn) experiment submitted: ['d9b7q5m6hjac73ffb5pg']
Single-qubit RB submitted: ['d9b7r4e6hjac73ffb71g', 'd9b7reu6hjac73ffb7d0']
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
ตอนนี้ออบเจกต์ backend_updated ที่รีเฟรชแล้วพร้อมใช้งานในทุกที่ที่คุณสมบัติของ Backend ป้อนเข้าสู่เวิร์กโฟลว์ของคุณ ลองใช้กระบวนการนี้ร่วมกับบทเรียน Real-time benchmarking for qubit selection เพื่อเลือกคิวบิตที่มีประสิทธิภาพดีที่สุดเมื่อ transpile Circuit เนื่องจากอุปกรณ์ยังคงดริฟต์ต่อไป ให้รีเฟรชคุณสมบัติใกล้กับช่วงเวลาที่คุณจะรันภาระงานจริง
ขั้นตอนถัดไป
หากคุณสนใจงานนี้ คุณอาจสนใจเนื้อหาต่อไปนี้ด้วย:
- ใช้คุณสมบัติที่รีเฟรชแล้วเพื่อเลือกคิวบิตที่ดีกว่าในบทเรียน Real-time benchmarking for qubit selection
- เรียนรู้ว่าข้อมูลการปรับเทียบที่รายงานถูกเปิดเผยอย่างไรในคู่มือ QPU information
- สำรวจการทดลองจำแนกคุณลักษณะแต่ละรายการในเอกสาร Qiskit Experiments documentation
- ดูเบนช์มาร์กระดับอุปกรณ์เพิ่มเติมใน Qiskit Device Benchmarking repository