แก้ปัญหา maximum independent set ที่มีตัวแปรมากกว่าจำนวน qubit ด้วย SQOA Solver ของ JIJ
Qiskit Functions เป็นฟีเจอร์ทดลองที่ใช้ได้เฉพาะผู้ใช้ IBM Quantum® Premium Plan, Flex Plan และ On-Prem (ผ่าน IBM Quantum Platform API) Plan เท่านั้น อยู่ในสถานะ preview release และอาจเปลี่ยนแปลงได้
ประมาณการการใช้งาน: 10 วินาทีบนโปรเซสเซอร์ Heron r2 (หมายเหตุ: นี่เป็นเพียงค่าประมาณ รันไทม์จริงของคุณอาจต่างออกไป)
ภูมิหลัง
บทช่วยสอนนี้แสดงวิธีใช้ SQOA Solver ซึ่งเป็น Qiskit Function โดย JIJ เพื่อแก้ปัญหา maximum independent set (MIS) ที่มีตัวแปรไบนารีมากกว่าจำนวน qubit ของ QPU ที่เลือก ขั้นตอนหลักคือโหลดอินสแตนซ์ MIS จาก Quantum Optimization Benchmarking Library (QOBLIB) [1] เขียนเป็นรูปแบบ quadratic unconstrained binary optimization (QUBO) ด้วย qiskit-addon-opt-mapper ส่งให้ SQOA Solver รันบน IBM® QPU และตรวจสอบคำตอบที่ได้กลับมา
ปัญหา maximum independent set
independent set คือเซตย่อยของโหนดในกราฟที่ไม่มีโหนดสองตัวที่เลือกไว้ใช้ขอบร่วมกัน maximum independent set (MIS) คือ independent set ที่มีจำนวนโหนดมากที่สุดเท่าที่เป็นไปได้ การประยุกต์ใช้ MIS ได้แก่ การจัดตารางเวลา การจัดสรรทรัพยากร และการออกแบบเครือข่าย
MIS เป็นปัญหา NP-hard ในการค้นหาแบบทั่วถึง ทุกโหนดที่เพิ่มเข้ามาจะทำให้จำนวนเซตย่อยที่ต้องพิจารณาเพิ่มเป็นสองเท่า วิธีนี้จึงใช้ไม่ได้จริงแม้กับกราฟขนาดปานกลาง QOBLIB รวม MIS เป็นหนึ่งในสิบคลาสปัญหา จึงเป็นเบนช์มาร์กที่มีประโยชน์ในการประเมิน workflow การหาค่าเหมาะที่สุดเชิงควอนตัมบนฮาร์ดแวร์จริง
การเขียนเป็นสูตรทางคณิตศาสตร์
กำหนดกราฟไม่มีทิศทาง ให้กำหนดตัวแปรไบนารี ให้กับแต่ละโหนด :
-
ถ้าเลือกโหนด
-
otherwise.
สูตร binary linear ทำให้จำนวนโหนดที่เลือกมากที่สุด พร้อมกันไม่ให้ปลายทั้งสองข้างของขอบใดถูกเลือกพร้อมกัน:
ฟังก์ชันเป้าหมายนับจำนวนโหนดที่เลือก เมื่อรวมกับข้อจำกัดของขอบ จะรับประกันว่าโหนดที่เลือกเป็น independent set
บทช่วยสอนนี้ใช้ สูตร binary unconstrained ของ QOBLIB ซึ่งแทนที่ข้อจำกัดของขอบด้วยเทอมลงโทษกำลังสอง:
เมื่อใดก็ตามที่เลือกปลายทั้งสองข้างของขอบ เทอมที่สองจะลบสองออกจากฟังก์ชันเป้าหมาย เทอมลงโทษนี้ทำให้การเลือกที่ขัดแย้งกันได้เปรียบน้อยกว่าการเลือกปลายใดปลายหนึ่งเพียงอย่างเดียว ฟังก์ชันเป้าหมายที่ได้คือ QUBO ซึ่งเป็นรูปแบบอินพุตที่ SQOA Solver รับ
ทำไมต้องใช้ SQOA Solver?
แนวทางการหาค่าเหมาะที่สุดเชิงควอนตัมหลายแบบกำหนดหนึ่ง qubit ต่อหนึ่งตัวแปรไบนารี ดังนั้นความจุของฮาร์ดแวร์ควอนตัมจึงจำกัดขนาดปัญหาโดยตรง SQOA Solver รวมเทคนิคการลดขนาดและการคำนวณแบบไฮบริดหลายอย่างเพื่อลดข้อจำกัดนี้:
-
รับมือกับปัญหาที่มีตัวแปรไบนารีมากกว่าจำนวน qubit ของ QPU ได้ Presolve ใช้กฎการลดขนาดที่ตรึงตัวแปรและทำให้ QUBO ที่เหลือง่ายขึ้น โดยยังคงคำตอบที่เหมาะที่สุดไว้อย่างน้อยหนึ่งคำตอบ จากการสังเกต presolve ยังทำให้ QUBO ที่เหลือเบาบางลงได้ ซึ่งช่วยการเข้ารหัสแบบ QRAC ที่ตามมา
จากนั้น solver ใช้การเข้ารหัสแบบ QRAC ที่มาจาก Quantum Random Access Optimization (QRAO) [3] เพื่อแทนหลายตัวแปร (สูงสุดสามตัว) ที่ไม่มีอันตรกิริยา QUBO โดยตรงต่อกันบน qubit เดียวกัน
การลดขนาดจาก presolve และการเข้ารหัสขึ้นกับโครงสร้างของปัญหา ตัวอย่างเช่น ในบทช่วยสอนนี้ ปัญหา 200 ตัวแปรใช้เพียง 67 qubit
-
อาจไวต่อสัญญาณรบกวนของฮาร์ดแวร์น้อยกว่า Sample-based quantum diagonalization [4], [5] ใช้ QPU สุ่มตัวอย่าง bitstring แต่ทำ diagonalization แบบคลาสสิก วิธีนี้หลีกเลี่ยงการประเมินบน QPU ซ้ำๆ เพื่ออัปเดตพารามิเตอร์แบบแปรผัน และช่วยลดผลกระทบของสัญญาณรบกวนต่อ workflow การหาค่าเหมาะที่สุด
-
ทำ workflow ตั้งแต่ presolve จนถึง post-processing โดยอัตโนมัติ คุณให้อินสแตนซ์ QUBO ที่จัดรูปแบบถูกต้องและเลือก backend จากนั้น SQOA Solver จะรัน workflow ทั้งหมดให้อัตโนมัติ โดยใช้ presolve, แมปตัวแปรคลาสสิกไปเป็นปัญหาควอนตัมแบบผ่อนคลาย, สร้างและ transpile วงจรสำหรับการสุ่มตัวอย่าง, ทำการสุ่มตัวอย่างเชิงควอนตัมและ diagonalization แบบคลาสสิก, ปัดเศษและปรับปรุงการกำหนดค่า และสร้างกลับพร้อมประเมินคำตอบแบบคลาสสิก
ข้อกำหนดเบื้องต้น
ก่อนเริ่มบทช่วยสอนนี้ ตรวจสอบให้แน่ใจว่าคุณติดตั้งแพ็กเกจต่อไปนี้แล้ว:
-
ไคลเอนต์ Qiskit Functions Catalog (
pip install qiskit-ibm-catalog) -
Qiskit addon optimization mapper ใช้สำหรับเขียนปัญหาเป็นสูตร (
pip install qiskit-addon-opt-mapper) -
NetworkX และ Matplotlib ใช้จัดการและพล็อตกราฟ (
pip install networkx matplotlib)
คุณยังต้องมีสิทธิ์เข้าถึง SQOA Solver จาก Qiskit Functions Catalog กรอกแบบฟอร์ม เพื่อขอสิทธิ์เข้าถึงฟังก์ชันนี้
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "networkx": "networkx", "ommx": "ommx", "ommx_quantum_benchmarks": "ommx-quantum-benchmarks", "qiskit_addon_opt_mapper": "qiskit-addon-opt-mapper", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
# %pip install qiskit-ibm-catalog qiskit-addon-opt-mapper networkx matplotlib
การตั้งค่า
ก่อนอื่น นำเข้าแพ็กเกจและเครื่องมือที่จำเป็น
import urllib.request

import matplotlib.pyplot as plt
import networkx as nx
from qiskit_addon_opt_mapper import OptimizationProblem
from qiskit_addon_opt_mapper.converters import OptimizationProblemToQubo
from qiskit_ibm_catalog import QiskitFunctionsCatalog
SQOA Solver รับปัญหา QUBO เป็นดิกชันนารีของสัมประสิทธิ์ในรูปแบบ tuple-string ที่ฟังก์ชันการหาค่าเหมาะที่สุดของ IBM® ใช้ กำหนดฟังก์ชันตัวช่วยที่แปลง QUBO ที่ OptimizationProblemToQubo คืนมาให้เป็นรูปแบบนี้
ตัวแปลงจะคืนปัญหา minimization เสมอ ซึ่งตรงกับวิธีที่ SQOA Solver จัดการปัญหาแบบดิกชันนารี คีย์ใช้ดัชนีตัวแปรของ QUBO และทุกตัวแปรจะมีรายการเชิงเส้น แม้สัมประสิทธิ์เป็นศูนย์ เพื่อให้คำตอบที่คืนมาครอบคลุมทุกตัวแปร
def to_problem_dict(qubo: OptimizationProblem) -> dict[str, float]:
    """Convert a QUBO from OptimizationProblemToQubo to the SQOA Solver dictionary format."""
    objective = qubo.objective
    payload = {"()": objective.constant}
    # Keep every variable in the problem, even with a zero linear coefficient.
    payload.update({f"({i},)": 0.0 for i in range(qubo.get_num_vars())})
    for i, coefficient in objective.linear.to_dict().items():
        payload[f"({i},)"] += coefficient
    for (i, j), coefficient in objective.quadratic.to_dict().items():
        # Fold a binary diagonal term x_i * x_i = x_i into the linear term.
        key = f"({i},)" if i == j else f"({i}, {j})"
        payload[key] = payload.get(key, 0.0) + coefficient
    return {key: float(value) for key, value in payload.items()}
ขั้นตอนที่ 1: แมปอินพุตแบบคลาสสิกไปเป็นปัญหาควอนตัม
SQOA Solver รับปัญหา QUBO และทำการแมปเชิงควอนตัมภายในฟังก์ชัน ในบทช่วยสอนนี้ คุณดาวน์โหลดอินสแตนซ์ MIS จาก QOBLIB และเขียนเป็น QUBO ด้วย qiskit-addon-opt-mapper ขั้นตอนนี้ครอบคลุมสิ่งต่อไปนี้:
-
เชื่อมต่อกับ SQOA Solver
-
ทำความเข้าใจเฟรมเวิร์ก SQOA
-
โหลดอินสแตนซ์ของปัญหา
-
เขียน QUBO และแปลงเพื่อส่ง
เชื่อมต่อกับ SQOA Solver
เชื่อมต่อกับ Qiskit Functions Catalog ด้วยข้อมูลรับรอง IBM Quantum Platform ของคุณ แล้วโหลด SQOA Solver โค้ดต่อไปนี้สมมติว่าคุณบันทึกบัญชีของคุณไว้ในสภาพแวดล้อมในเครื่องแล้ว
ถ้าการเชื่อมต่อล้มเหลว ให้ตรวจสอบว่าผู้ดูแลบัญชี IBM Quantum Platform ของคุณให้สิทธิ์อินสแตนซ์บริการที่เลือกในการเข้าถึง SQOA Solver แล้ว
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
solver = catalog.load("jij/sqoa-solver")
ทำความเข้าใจเฟรมเวิร์ก SQOA
Sampling-based Quantum Optimization Algorithm with Quantum Relaxation (SQOA-QR) [2] รวม Quantum Random Access Optimization (QRAO) เข้ากับ sample-based quantum diagonalization:
-
Quantum relaxation และการเข้ารหัส: SQOA Solver แปลง QUBO เป็นฟังก์ชันเป้าหมาย Ising แบบ minimization ในรูป โดยที่ จากนั้น QRAO [3] แมปตัวแปรสปินแต่ละตัวไปเป็น Pauli observable สำหรับการเข้ารหัส -QRAC ที่ใช้ที่นี่ แฮมิลโทเนียนแบบผ่อนคลายคือ
โดยที่ คือตัวดำเนินการเอกลักษณ์ กำหนดตัวแปร ให้กับ qubit หนึ่งตัวและหนึ่งใน , หรือ และ คือจำนวนตัวแปรที่แมปไปยัง qubit เดียวกับ เมื่อ qubit ที่เกี่ยวข้องทั้งสองมีสามตัวแปร ตัวประกอบสเกลเชิงเส้นและกำลังสองจะกลายเป็น และ ตามลำดับ
ตัวแปรที่ใช้ qubit ร่วมกันจะถูกกำหนด Pauli observable ที่ไม่ commute ต่างกัน ตัวแปรที่มีอันตรกิริยากันใน QUBO จะอยู่บน qubit ต่างกัน ส่วนตัวแปรที่ไม่มีอันตรกิริยา QUBO โดยตรงต่อกันใช้ qubit ร่วมกันได้ ดังนั้นการลดจำนวน qubit จึงขึ้นกับโครงสร้างของปัญหา
-
การสุ่มตัวอย่างเชิงควอนตัม: โปรเซสเซอร์ควอนตัมสุ่มตัวอย่าง bitstring จากวงจรที่ออกแบบมาเพื่อสำรวจสถานะพลังงานต่ำของแฮมิลโทเนียนแบบผ่อนคลาย
-
Sample-based diagonalization: solver ฉายแฮมิลโทเนียนแบบผ่อนคลายลงบนปริภูมิย่อยที่ขึงด้วยสถานะฐานที่ได้จาก bitstring ที่สุ่มมา แล้วทำ diagonalization ของแฮมิลโทเนียนที่ฉายแล้วแบบคลาสสิก [4], [5] สำหรับเซตของ bitstring ที่สุ่มมาคงที่ ให้ เป็นปริภูมิย่อยที่ขึงด้วยสถานะฐานที่ต่างกัน สถานะ ดังนั้น พลังงานสถานะพื้นที่ประมาณได้ของมันคือ:
โดยที่ คือพลังงานสถานะพื้นของแฮมิลโทเนียนแบบผ่อนคลายเต็มรูป ดังนั้นปริภูมิย่อยที่เก็บไว้ใหญ่ขึ้นจะไม่ทำให้พลังงานสถานะพื้นที่ประมาณได้เพิ่มขึ้น
ลำดับนี้ถือว่าผลการสุ่มตัวอย่างเดียวกัน และเกี่ยวกับพลังงานของแฮมิลโทเนียนแบบผ่อนคลายก่อนการปัดเศษ ไม่ได้รับประกันทางทฤษฎีว่าคำตอบแบบคลาสสิกที่คืนมาจะดีกว่า แต่ใน QRAO คาดโดยหลักฮิวริสติกว่าสถานะพลังงานต่ำกว่าจะให้คำตอบแบบคลาสสิกที่ดีกว่า
-
การปัดเศษ: สถานะแบบผ่อนคลายที่ได้จาก diagonalization ถูกแปลงเป็นการกำหนดค่าไบนารีแบบคลาสสิก
SQOA Solver ล้อมเฟรมเวิร์กนี้ด้วยการประมวลผลแบบคลาสสิก ก่อนการแมปเชิงควอนตัม presolve ใช้กฎการลดขนาดที่ตรึงตัวแปรและทำให้ QUBO ที่เหลือง่ายขึ้น โดยยังคงคำตอบที่เหมาะที่สุดไว้อย่างน้อยหนึ่งคำตอบ หลัง diagonalization และการปัดเศษ การค้นหาเฉพาะที่แบบคลาสสิกจะปรับปรุงการกำหนดค่า และ OMMX สร้างกลับและประเมินคำตอบฉบับสมบูรณ์
โหลดอินสแตนซ์
QOBLIB แจกจ่ายแต่ละอินสแตนซ์ MIS เป็นกราฟในรูปแบบ DIMACS .gph ซึ่งเป็นรูปแบบที่ทีละบรรทัด โดยบรรทัดที่ขึ้นต้นด้วย p ระบุจำนวนโหนดและขอบ และแต่ละบรรทัดที่ขึ้นต้นด้วย e กำหนดหนึ่งขอบ
QOBLIB ยังเผยแพร่คำตอบอ้างอิงที่เหมาะที่สุดหรือดีที่สุดเท่าที่ทราบสำหรับแต่ละอินสแตนซ์ ฟังก์ชันต่อไปนี้ดาวน์โหลดทั้งสองอย่างจากที่เก็บ QOBLIB DIMACS ระบุป้ายโหนดโดยเริ่มจาก 1 จึงเปลี่ยนป้ายของกราฟให้เริ่มจาก 0
ถ้าอยากเริ่มจากกราฟของคุณเองแทน ให้ข้ามการดาวน์โหลดแล้วเขียนปัญหาจากกราฟ NetworkX ของคุณในแบบเดียวกัน
QOBLIB_URL = "https://raw.githubusercontent.com/ZIB-AOPT/QOBLIB/refs/heads/main/07-independentset"

def fetch_qoblib_graph(name: str) -> nx.Graph:
    """Download a QOBLIB independent-set instance as a NetworkX graph."""
    with urllib.request.urlopen(
        f"{QOBLIB_URL}/instances/{name}.gph"
    ) as response:
        lines = response.read().decode().splitlines()
    graph = nx.Graph()
    for fields in map(str.split, lines):
        if fields and fields[0] == "p":
            # Header: p edge <number of nodes> <number of edges>
            graph.add_nodes_from(range(int(fields[2])))
        elif fields and fields[0] == "e":
            # DIMACS labels nodes from 1; relabel them to start from 0.
            graph.add_edge(int(fields[1]) - 1, int(fields[2]) - 1)
    return graph

def fetch_reference_objective(name: str) -> float:
    """Read the objective value of the QOBLIB reference solution."""
    with urllib.request.urlopen(
        f"{QOBLIB_URL}/solutions/{name}.opt.sol"
    ) as response:
        for line in response.read().decode().splitlines():
            if line.startswith("# Objective value"):
                return float(line.split("=")[1])
    raise ValueError(f"No objective value found for {name}.")

INSTANCE_NAME = "gen200_p0-9_44"
G = fetch_qoblib_graph(INSTANCE_NAME)
reference_objective = fetch_reference_objective(INSTANCE_NAME)
คุณจะใช้ค่าฟังก์ชันเป้าหมายของคำตอบอ้างอิงในภายหลังเพื่อประเมินผลลัพธ์จาก SQOA Solver บทช่วยสอนนี้แก้ปัญหานี้บนอุปกรณ์ที่มี 156 qubit
print(
    f"{INSTANCE_NAME}: {G.number_of_nodes()} nodes, {G.number_of_edges()} edges"
)
print(f"Reference objective: {reference_objective:g}")
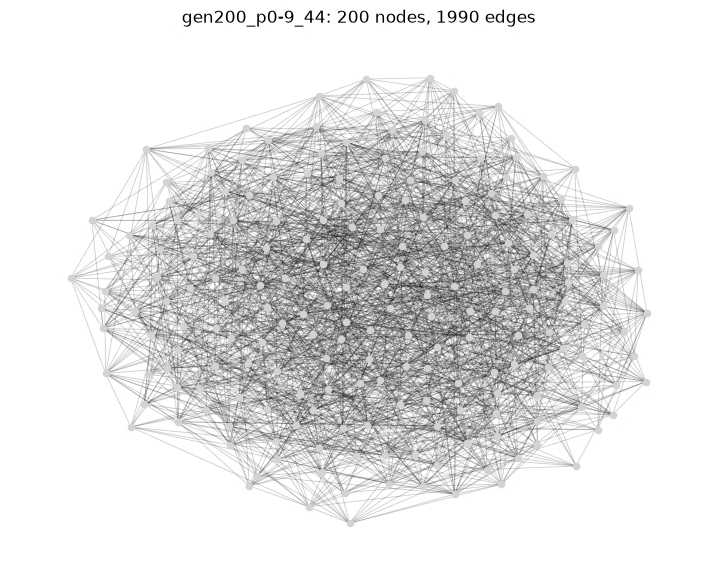
gen200_p0-9_44: 200 nodes, 1990 edges
Reference objective: 44
แสดงภาพกราฟ ภายหลังคุณจะใช้มันตรวจสอบด้วยว่าโหนดที่ SQOA Solver คืนมาเป็น independent set
layout = nx.forceatlas2_layout(
    G, max_iter=500, scaling_ratio=3.0, gravity=1.0, seed=7
)
node_size = max(8, min(60, 4000 / max(G.number_of_nodes(), 1)))

fig, ax = plt.subplots(figsize=(9, 7))
nx.draw_networkx_edges(G, layout, ax=ax, alpha=0.2, width=0.6)
nx.draw_networkx_nodes(
    G, layout, node_size=node_size, node_color="lightgray", ax=ax
)
ax.set_title(
    f"{INSTANCE_NAME}: {G.number_of_nodes()} nodes, {G.number_of_edges()} edges"
)
ax.set_axis_off()
plt.show()
เขียน QUBO
สร้างสูตร binary linear จากส่วนภูมิหลังเป็น OptimizationProblem ที่มีหนึ่งตัวแปรไบนารีต่อโหนด ฟังก์ชันเป้าหมายที่นับโหนดที่เลือก และหนึ่งข้อจำกัดต่อขอบ จากนั้นแปลงด้วย OptimizationProblemToQubo
ด้วยน้ำหนักการลงโทษ 2 ตัวแปลงจะแทนที่ข้อจำกัดของแต่ละขอบด้วยเทอมลงโทษ และเปลี่ยน maximization เป็น minimization ดังนั้นปัญหาที่แปลงแล้วคือสูตร binary unconstrained ของ QOBLIB ที่กลับเครื่องหมาย ดัชนีตัวแปรของ QUBO คือป้ายโหนดของกราฟ คลาสแอปพลิเคชัน IndependentSet ใน qiskit_addon_opt_mapper.applications สร้างโมเดลที่มีข้อจำกัดแบบเดียวกันด้วย IndependentSet(G).to_optimization_problem()
สุดท้าย แปลง QUBO เป็นรูปแบบดิกชันนารีด้วย to_problem_dict() เนื่องจากปัญหาเป็น QUBO แบบไบนารี คำขอใน Step 2 จึงประกาศโดเมนตัวแปรเป็น "binary" ฟังก์ชันจะทำ presolve การแมปเชิงควอนตัม และการสร้างวงจรหลังส่ง
mis = OptimizationProblem(INSTANCE_NAME)
mis.binary_var_list(G.number_of_nodes(), name="x")
mis.maximize(linear={v: 1 for v in G.nodes})
for u, v in G.edges:
    mis.linear_constraint({u: 1, v: 1}, "<=", 1)

converter = OptimizationProblemToQubo(penalty=2)
qubo = converter.convert(mis)
problem_dict = to_problem_dict(qubo)

print(f"QUBO variables: {qubo.get_num_vars()}")
print(f"Dictionary entries: {len(problem_dict)}")
QUBO variables: 200
Dictionary entries: 2191
ขั้นตอนที่ 2: ปรับปัญหาให้เหมาะสมสำหรับการรันบนฮาร์ดแวร์ควอนตัม
SQOA Solver ทำการแมปเชิงควอนตัมและการเตรียมฮาร์ดแวร์ภายในฟังก์ชัน ก่อนอื่นมันใช้ presolve กับ QUBO จากนั้นแมปตัวแปรที่เหลือไปเป็นแฮมิลโทเนียนแบบผ่อนคลายโดยใช้การเข้ารหัสแบบ QRAC
สำหรับการสุ่มตัวอย่างเชิงควอนตัม มันสร้างวงจรตามแฮมิลโทเนียนแบบผ่อนคลายและ transpile วงจรเหล่านั้นสำหรับ backend ที่เลือก การลดขนาดปัญหาและจำนวน qubit จาก presolve และการเข้ารหัสขึ้นกับปัญหา ดังนั้นให้ตั้งค่า solver โดยไม่สมมติตัวประกอบการลดขนาดที่คงที่
ตั้งค่าอินพุตของ solver
SQOA Solver ต้องการอินพุตสองอย่าง:
-
problemคือดิกชันนารีจาก Step 1 -
variable_typeซึ่งเป็น"binary"สำหรับ QUBO นี้
มันยังรับอินพุตเสริมอีกสองอย่าง:
-
backend_nameเลือก QPU เมื่อไม่ระบุหรือเป็นNoneฟังก์ชันจะเลือก QPU ที่พร้อมใช้งานและว่างที่สุดที่อินสแตนซ์ของคุณเข้าถึงได้ -
optionsคือดิกชันนารีที่ควบคุมงบประมาณการสุ่มตัวอย่าง (shots) seed แบบคลาสสิก (seed) การใช้ session (session) การค้นหาเฉพาะที่แบบคลาสสิก (postprocessing_level) และแท็กของ job (job_tags) ถ้าเพิ่มshotsสถิติการสุ่มตัวอย่างอาจดีขึ้น
สำหรับอินพุตทั้งหมด ค่าเริ่มต้นของมัน และกฎการตรวจสอบ ดูเอกสารอ้างอิง API
บทช่วยสอนนี้ระบุชื่อ backend อย่างชัดเจน ใช้ค่าเริ่มต้นสำหรับ shots, session และ postprocessing_level และตั้ง seed แบบคลาสสิก รวบรวมอินพุตไว้ในดิกชันนารีเพื่อให้ส่งต่อให้ solver.run() ใน Step 3 ได้
# ibm_fez has 156 qubits
backend_name = (
    "ibm_fez"  # Omit this key or pass None for automatic selection.
)

sqoa_input = {
    "problem": problem_dict,
    "variable_type": "binary",
    "backend_name": backend_name,
}
sqoa_input["options"] = {
    "shots": 4096,
    "seed": 42,
    "session": False,
    "postprocessing_level": 1,
}
ขั้นตอนที่ 3: รันโดยใช้ primitive
ส่ง job ด้วยการเชื่อมต่อ SQOA Solver ที่สร้างไว้ใน Step 1 ฟังก์ชันรัน IBM Quantum Sampler primitive บน backend ที่เลือก รวบรวม bitstring ที่วัดได้ และทำ diagonalization แบบคลาสสิกกับ post-processing ต่อ คุณโต้ตอบกับ job ของฟังก์ชันเพียงหนึ่งเดียว
job = solver.run(**sqoa_input)
print(f"Job ID: {job.job_id}")
Job ID: dcee8e26-b8ac-4dd7-a76e-5adb5bc388e5
หากต้องการตรวจสอบสถานะของงาน ดูตรวจสอบสถานะ job ภายในฟังก์ชันจะผ่านระยะการแมป การปรับให้เหมาะกับฮาร์ดแวร์ การรอคิว การรันบน QPU และ post-processing
job.status()
'INITIALIZING'
job.result() จะบล็อกจนกว่า job จะเสร็จ และคืนดิกชันนารีที่มีคำตอบ ค่าฟังก์ชันเป้าหมายและความเป็นไปได้ของคำตอบ และเมทาดาทาที่เก็บข้อมูลของ solver และการใช้ทรัพยากร สำหรับนิยามเต็มของอินพุตและเอาต์พุต ดูเอกสารอ้างอิง API
result = job.result()
ขั้นตอนที่ 4: ประมวลผลผลลัพธ์ภายหลังและแปลงเป็นรูปแบบคลาสสิก
ตรวจสอบเอาต์พุตทั้งหมดของฟังก์ชัน แมปการกำหนดค่าที่คืนมากลับไปยังกราฟ ตรวจสอบโหนดที่เลือก และแสดงภาพผลลัพธ์
ตรวจสอบผลลัพธ์
ดิกชันนารีผลลัพธ์มีฟิลด์ระดับบนสุดสี่ฟิลด์:
-
solutionคือการกำหนดค่าตัวแปรทั้งหมด โดยใช้คีย์x_iที่ i คือดัชนีตัวแปร (ตัวอย่างเช่นx_17) ในบทช่วยสอนนี้ ดัชนีตัวแปรคือป้ายโหนด -
objective_valueคือค่าฟังก์ชันเป้าหมายของการกำหนดค่านั้นที่ประเมินบนดิกชันนารีที่ส่งไป นั่นคือบน QUBO แบบ minimization -
feasibleหมายถึงเฉพาะโดเมนของตัวแปร เพราะดิกชันนารีไม่มีข้อจำกัด -
metadataมีsolver_infoและresource_usageโดยsolver_infoบันทึกseedที่ใช้จริงของการรัน ถ้าการค้นหาเฉพาะที่แบบคลาสสิกทำงานsolver_infoยังบันทึกการกำหนดค่าที่ปัดเศษแล้วจากก่อนการปรับปรุงนั้นไว้ในsolution_before_postprocessing
solver_info = result["metadata"]["solver_info"]

print(f"Result fields: {list(result)}")
print(f"Solution entries: {len(result['solution'])}")
print(f"First entries: {dict(list(result['solution'].items())[:3])}")
print(f"Objective value: {result['objective_value']}")
print(f"Feasible: {result['feasible']}")
print(f"Solver-info fields: {list(solver_info)}")
print(f"Effective seed: {solver_info['seed']}")
print(f"Resource-usage phases: {list(result['metadata']['resource_usage'])}")
Result fields: ['solution', 'objective_value', 'feasible', 'metadata']
Solution entries: 200
First entries: {'x_0': 0.0, 'x_1': 0.0, 'x_2': 1.0}
Objective value: -35.0
Feasible: True
Solver-info fields: ['seed', 'solution_before_postprocessing']
Effective seed: 42
Resource-usage phases: ['RUNNING: MAPPING', 'RUNNING: OPTIMIZING_FOR_HARDWARE', 'RUNNING: WAITING_FOR_QPU', 'RUNNING: EXECUTING_QPU', 'RUNNING: POST_PROCESSING']
แมปคำตอบไปยังกราฟ
รวบรวมค่าที่คืนมาตามลำดับของดัชนีตัวแปร และแมปกลับไปยังตัวแปรของปัญหาเดิมด้วย interpret() โหนดที่เลือกคือตัวแปรที่มีค่า 1 และ is_feasible() ตรวจสอบการกำหนดค่าเทียบกับข้อจำกัดของขอบในปัญหาเดิม
x_qubo = [result["solution"][f"x_{i}"] for i in range(qubo.get_num_vars())]
x = converter.interpret(x_qubo)
selected_nodes = [node for node, value in enumerate(x) if value > 0.5]

print(f"Selected nodes: {len(selected_nodes)}")
print(f"Satisfies every edge constraint: {mis.is_feasible(x)}")
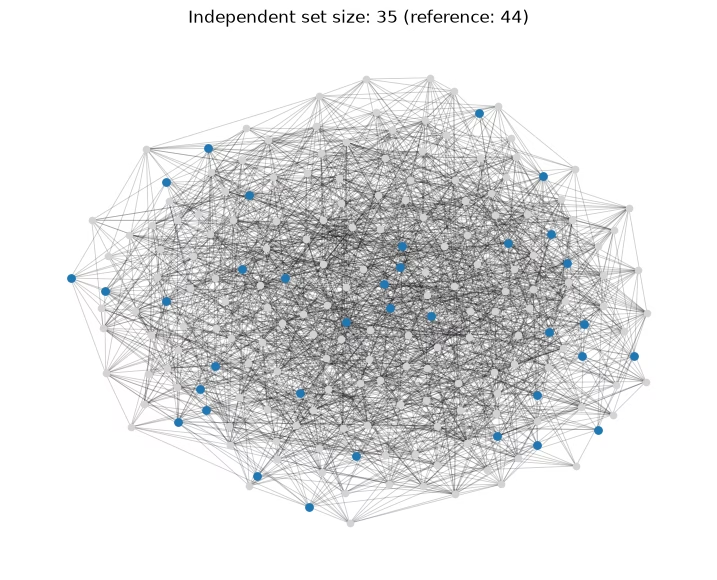
Selected nodes: 35
Satisfies every edge constraint: True
เปรียบเทียบกับคำตอบก่อน post-processing
เนื่องจาก postprocessing_level เป็น 1 solver_info จึงบันทึกการกำหนดค่าที่ปัดเศษแล้วจากก่อนการค้นหาเฉพาะที่แบบคลาสสิกไว้ใน solution_before_postprocessing ด้วย โดยใช้คีย์เดียวกับ solution
ประเมินมันบน QUBO เพื่อดูว่าการปรับปรุงทำให้ผลลัพธ์ดีขึ้นเท่าไร ทั้งสองค่าเป็นค่าฟังก์ชันเป้าหมายของ QUBO แบบ minimization ที่ส่งไป ดังนั้นค่าที่ต่ำกว่าดีกว่า ฟิลด์นี้จะถูกละไว้เมื่อการค้นหาเฉพาะที่ไม่ทำงาน เช่น เมื่อ presolve ตรึงทุกตัวแปรแล้ว
before = solver_info.get("solution_before_postprocessing")
if before is None:
    print("The classical local search did not run for this problem.")
else:
    x_before = [before[f"x_{i}"] for i in range(qubo.get_num_vars())]
    changed = sum(
        before[key] != value for key, value in result["solution"].items()
    )
    print(
        f"Objective before local search: {qubo.objective.evaluate(x_before)}"
    )
    print(f"Objective after local search: {result['objective_value']}")
    print(f"Variables changed by local search: {changed}")
Objective before local search: -12.0
Objective after local search: -35.0
Variables changed by local search: 19
ตรวจสอบข้อจำกัด independence
เนื่องจาก QUBO แทนการอยู่ติดกันผ่านเทอมลงโทษแทนที่จะเป็นข้อจำกัดโดยตรง ผลลัพธ์แบบฮิวริสติกจึงอาจยังเลือกโหนดที่อยู่ติดกันได้ ตรวจสอบโหนดที่คืนมากับกราฟโดยตรง สำหรับการเปรียบเทียบและการแสดงภาพในส่วนถัดไป ให้คัดลอกเซตที่คืนมาและลบปลายหนึ่งข้างของแต่ละความขัดแย้งที่ตรวจพบแบบ greedy
returned_set = set(selected_nodes)
conflicts = [
    (u, v) for u, v in G.edges if u in returned_set and v in returned_set
]
print(f"Conflicting edges in the returned set: {len(conflicts)}")

independent_set = returned_set.copy()
for u, v in conflicts:
    if u in independent_set and v in independent_set:
        # Drop the endpoint that has more selected neighbors.
        drop = max(
            (u, v),
            key=lambda node: sum(nb in independent_set for nb in G[node]),
        )
        independent_set.remove(drop)

assert all(
    not (u in independent_set and v in independent_set) for u, v in G.edges
)
print(f"Independent set size after repair: {len(independent_set)}")
Conflicting edges in the returned set: 0
Independent set size after repair: 35
เปรียบเทียบกับคำตอบอ้างอิง
ใน Step 1 คุณดาวน์โหลดค่าฟังก์ชันเป้าหมายของคำตอบอ้างอิงของ QOBLIB คำตอบอ้างอิงของ QOBLIB อาจเป็นคำตอบที่เหมาะที่สุดหรือดีที่สุดเท่าที่ทราบ ดังนั้นให้เปรียบเทียบกับค่าฟังก์ชันเป้าหมายอ้างอิงโดยไม่สมมติว่าเป็นค่าเหมาะที่สุดที่ได้รับการรับรองเสมอไป
สำหรับปัญหา maximization นี้ อัตราส่วน 1.0 หมายความว่าผลลัพธ์ที่ซ่อมแล้วเท่ากับค่าฟังก์ชันเป้าหมายอ้างอิง
ratio_to_reference = len(independent_set) / reference_objective

print(f"Reference objective: {reference_objective:g}")
print(f"Ratio to reference: {ratio_to_reference:.3f}")
Reference objective: 44
Ratio to reference: 0.795
แสดงภาพผลลัพธ์
พล็อตกราฟอีกครั้งโดยเน้น independent set ที่ซ่อมแล้ว ไม่มีโหนดที่เน้นสองตัวใดใช้ขอบร่วมกัน
fig, ax = plt.subplots(figsize=(9, 7))
nx.draw_networkx_edges(G, layout, ax=ax, alpha=0.2, width=0.6)
nx.draw_networkx_nodes(
    G,
    layout,
    nodelist=[v for v in G if v not in independent_set],
    node_size=node_size,
    node_color="lightgray",
    ax=ax,
)
nx.draw_networkx_nodes(
    G,
    layout,
    nodelist=sorted(independent_set),
    node_size=node_size * 1.4,
    node_color="tab:blue",
    ax=ax,
)
ax.set_title(
    f"Independent set size: {len(independent_set)} "
    f"(reference: {reference_objective:g})"
)
ax.set_axis_off()
plt.show()
อ่านการใช้ทรัพยากร
เมทาดาทาของผลลัพธ์รายงาน CPU_TIME สำหรับระยะอื่นนอกจาก RUNNING: EXECUTING_QPU เมื่อมีข้อมูล ระยะ RUNNING: EXECUTING_QPU สามารถรายงาน QPU_TIME ซึ่งเป็นการใช้ QPU ที่ Quantum Compute คืนมา ถ้ามีข้อมูลการใช้งานสุดท้ายสำหรับทุก job ของ Quantum Compute
usage = result["metadata"]["resource_usage"]

for phase, metrics in usage.items():
    line = f"{phase:36s}"
    if "CPU_TIME" in metrics:
        line += f" CPU {metrics['CPU_TIME']:8.1f} s"
    if "QPU_TIME" in metrics:
        line += f" QPU {metrics['QPU_TIME']:8.1f} s"
    print(line)
RUNNING: MAPPING                     CPU     11.8 s
RUNNING: OPTIMIZING_FOR_HARDWARE     CPU     15.4 s
RUNNING: WAITING_FOR_QPU             CPU     16.5 s
RUNNING: EXECUTING_QPU               QPU      3.0 s
RUNNING: POST_PROCESSING             CPU     55.8 s
บทสรุป
ในบทช่วยสอนนี้ คุณดาวน์โหลด MIS instance จาก QOBLIB, formulate เป็น QUBO ด้วย qiskit-addon-opt-mapper, เชื่อมต่อกับ SQOA Solver, ตั้งค่าและส่ง workload, แมปคำตอบที่ได้กลับไปยังกราฟ และตรวจสอบโหนดที่เลือกเทียบกับกราฟต้นฉบับ
คุณยังเปรียบเทียบผลลัพธ์กับคำตอบอ้างอิงของ QOBLIB, ตรวจสอบส่วนที่ classical post-processing มีส่วนช่วย และดูการใช้ทรัพยากรของแต่ละเฟสการรัน
SQOA Solver รวม presolve, QRAO ที่ใช้การเข้ารหัสแบบ QRAC, การสร้าง sampling circuit, hardware-aware transpilation, sample-based diagonalization, rounding และ classical refinement เข้าด้วยกัน เวิร์กโฟลว์นี้แมปตัวแปรไบนารีได้มากกว่าการเข้ารหัสแบบหนึ่งตัวแปรต่อหนึ่ง qubit ปริมาณที่ลดลงจาก presolve และการเข้ารหัสขึ้นอยู่กับโครงสร้างของปัญหา และคุณภาพของคำตอบขึ้นอยู่กับ sample ที่ได้
การตั้งค่า shots และ postprocessing_level ควบคุมงบ quantum sampling และ classical refinement ตามลำดับ โดยไม่เปลี่ยนเวิร์กโฟลว์การส่งงาน
ภาคผนวก: ส่งปัญหาเป็น OMMX instance
SQOA Solver ยังรับ ommx.v1.Instance จาก OMMX SDK ด้วย แพ็กเกจ OMMX Quantum Benchmarks แจกจ่ายปัญหา QOBLIB เป็น OMMX instance พร้อมคำตอบอ้างอิง คุณจึงโหลด QUBO เดียวกันได้โดยไม่ต้อง formulate เอง
เมื่อใช้ OMMX เป็นอินพุต objective_value จะถูกประเมินตามความหมายของ instance และผลลัพธ์จะมี ommx.v1.Solution แบบ canonical ด้วย ติดตั้งแพ็กเกจ ซึ่งจะติดตั้ง OMMX SDK ด้วย:
# %pip install ommx-quantum-benchmarks
โหลดโมเดล binary_unconstrained ของ instance เดียวกัน ตัวโหลด dataset จะพิมพ์ข้อความแสดงความคืบหน้า โค้ดจึงดักจับข้อความเหล่านั้นไว้เพื่อให้เอาต์พุตกะทัดรัด
%%capture
from ommx_quantum_benchmarks.qoblib import IndependentSet

ommx_instance, _ = IndependentSet()("binary_unconstrained", INSTANCE_NAME)
SQOA Solver รับ OMMX instance เป็นสตริง Base64 แบบ padded มาตรฐาน และส่งคืนคำตอบ canonical ในรูปแบบเดียวกัน กำหนดฟังก์ชันช่วยสองตัวสำหรับการแปลงนี้:
-
to_problem_payload()แปลงommx.v1.Instanceเป็นสตริงที่คุณส่งเป็นproblem -
to_ommx_solution()ถอดรหัสommx.v1.Solutionแบบ canonical จากผลลัพธ์
import base64

from ommx.v1 import Instance, Solution

def to_problem_payload(instance: Instance) -> str:
    """Serialize an OMMX instance into the `problem` string for SQOA Solver."""
    return base64.b64encode(instance.to_bytes()).decode()

def to_ommx_solution(result: dict) -> Solution:
    """Decode the canonical OMMX solution from a SQOA Solver result."""
    payload = result["metadata"]["solver_info"]["ommx_solution"]
    return Solution.from_bytes(base64.b64decode(payload, validate=True))
ส่ง instance ด้วยอินพุตเดียวกับก่อนหน้า โดยเปลี่ยนเฉพาะ problem จากนั้นถอดรหัสคำตอบ canonical และอ่านโหนดที่เลือกตามชื่อตัวแปร
ommx_job = solver.run(
    **{**sqoa_input, "problem": to_problem_payload(ommx_instance)}
)
ommx_result = ommx_job.result()

ommx_solution = to_ommx_solution(ommx_result)
x_values = ommx_solution.extract_decision_variables("x")
ommx_nodes = sorted(
    node for (node,), value in x_values.items() if value > 0.5
)

print(f"Objective value: {ommx_result['objective_value']}")
print(f"Selected nodes: {len(ommx_nodes)}")
Objective value: 35.0
Selected nodes: 35
ขั้นตอนถัดไป
- นำเวิร์กโฟลว์นี้ไปใช้กับปัญหา QUBO ของคุณเอง สร้าง
OptimizationProblemตามที่แสดงในคู่มือ SQOA Solver ขั้นตอนการแปลงและการส่งงานเหมือนเดิม แต่ให้ปรับการตรวจสอบให้เหมาะกับโครงสร้างของปัญหาของคุณ - ส่งปัญหาเป็น OMMX instance ตามที่แสดงในภาคผนวก ดูเอกสารอ้างอิง API สำหรับรูปแบบปัญหาที่รองรับและฟิลด์ที่ส่งคืน
- สำรวจ independent-set instance อื่นๆ ในที่เก็บ QOBLIB หรือผ่าน OMMX Quantum Benchmarks
- เรียนรู้เพิ่มเติมเกี่ยวกับการสร้างโมเดลด้วย qiskit-addon-opt-mapper หรือ JijModeling และการแลกเปลี่ยนปัญหาด้วย OMMX
เอกสารอ้างอิง
[1] Koch, T., Bernal Neira, D. E., Chen, Y., Cortiana, G., Egger, D. J., Heese, R., Hegade, N. N., Gomez Cadavid, A., Huang, R., Itoko, T., et al. (2026). Quantum optimization benchmarking library: The intractable decathlon. Nature Computational Science, 6, 653–671. DOI, arXiv:2504.03832
[2] Matsuyama, H., & Yamashiro, Y. (2025). Sampling-based quantum optimization algorithm with quantum relaxation. 2025 IEEE International Conference on Quantum Computing and Engineering (QCE), 1, 2323–2333. DOI, arXiv:2504.12629
[3] Fuller, B., Hadfield, C., Glick, J. R., Imamichi, T., Itoko, T., Thompson, R. J., Jiao, Y., Kagele, M. M., Blom-Schieber, A. W., Raymond, R., et al. (2024). Approximate solutions of combinatorial problems via quantum relaxations. IEEE Transactions on Quantum Engineering, 5, 1–15. DOI, arXiv:2111.03167
[4] Kanno, K., Kohda, M., Imai, R., Koh, S., Mitarai, K., Mizukami, W., & Nakagawa, Y. O. (2026). Quantum-selected configuration interaction: Classical diagonalization of Hamiltonians in subspaces selected by quantum computers. Physical Review Research, 8(2), 023268. DOI, arXiv:2302.11320
[5] Robledo-Moreno, J., Motta, M., Haas, H., Javadi-Abhari, A., Jurcevic, P., Kirby, W., et al. (2025). Chemistry beyond the scale of exact diagonalization on a quantum-centric supercomputer. Science Advances, 11(25), eadu9991. DOI, arXiv:2405.05068